AiSOC:6741 星的开源 AI SOC,先学会了对自己说实话
标题里那个 5400,已经是旧数字了。现在 6,741 星,720 个 fork。
但它值得写的理由跟星数关系不大。我把 beenuar/AiSOC 的 README、架构文档、Sigma 编译报告,还有那份叫 REPOSITORY_REALITY.md 的自查报告一起读完,最直接的感受是:
这是一个会主动告诉你哪里跑不起来的项目。
而且它承认的第一件事,就是”我以前骗过你”。
一、先说它承认的那件事
docs/audit/REPOSITORY_REALITY.md 第二节,标题叫”The headline”,原文我抄下来:
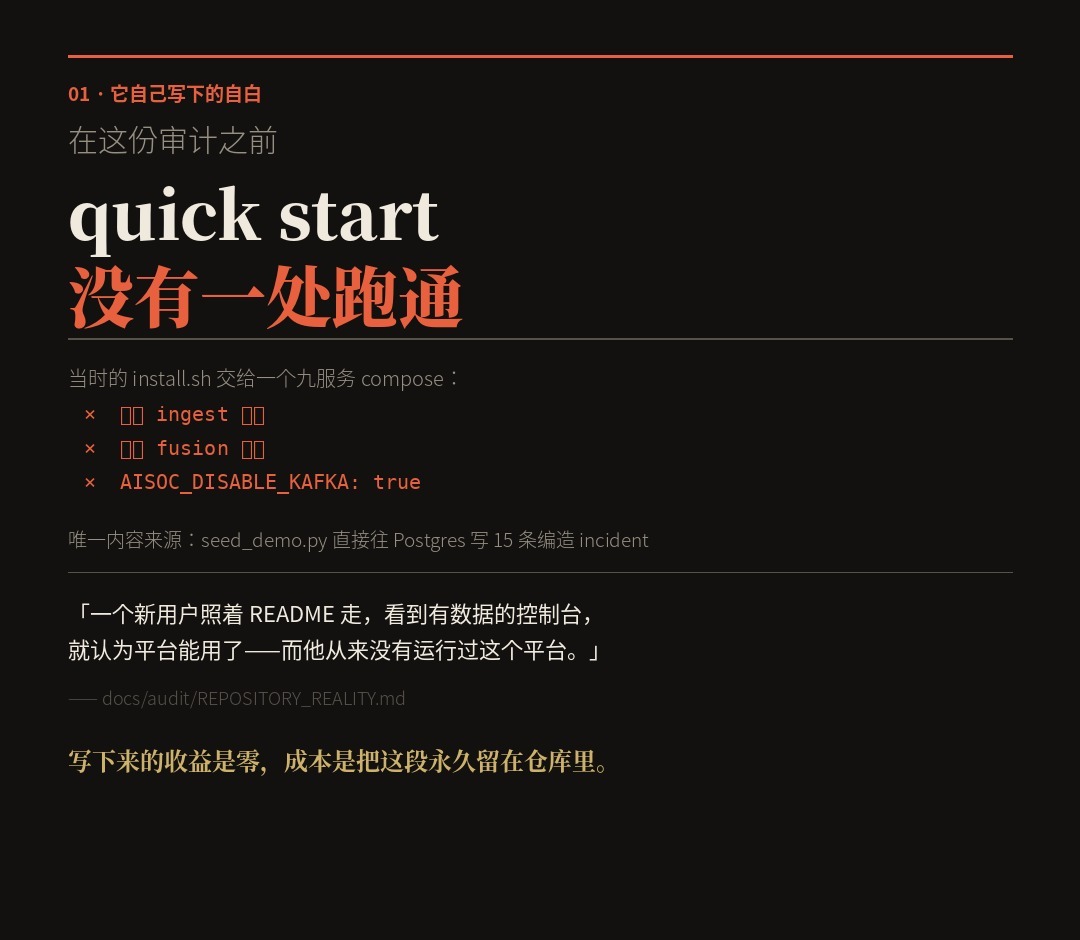
在这份审计之前,文档里那条 quick start 没有一处真的跑通了。
./install.sh交给一个九服务的 compose 文件,其中没有 ingest 服务、没有 fusion 服务,而且AISOC_DISABLE_KAFKA: true。它唯一的内容来源是seed_demo.py往 Postgres 里直接写了 15 条编造的 incident。
一个新用户照着 README 走,看到一个有数据的控制台,就认为平台能用了——而他从来没有运行过这个平台。
后面还有一句更狠的:
单就这一条,解释了关于”数据是编造的””架构无法验证”的那些反复出现的反馈。
我读到这里停了一下。大多数开源项目不会写这种段落——它等于把早期版本的”演示效果”定性成了一次误导。而写下来的收益是零,成本是把这段永久留在仓库里。
所以这篇文章的骨架变了:我不打算复述它能干什么,我想看看它是怎么把”能干什么”钉死的。
二、它到底干什么:三句话说完
- 收:91 个可点选接入的 connector,加上 4 个专门读真实云环境的 collector
- 判:2,966 条可执行检测规则跑在事件流上,命中的归并成 incident
- 查:Agent 读告警、读关联的兄弟告警、读实体上下文、读同签名历史判定,然后出结论
技术栈不复杂:二十个服务树(14 个 Python、4 个 Go、2 个 TypeScript)挂在一个 Next.js 控制台后面,Kafka 是脊柱,Postgres 装告警/案件/防篡改审计链,Redis 和 Qdrant 在 core 里;full profile 再加 ClickHouse(事件湖)、Neo4j(实体图)、OpenSearch(全文检索)。
两个部署档:
- core:
make up,16 个服务,约 8 GB,跑完整链路——不需要任何凭据 - full:
make up-full,22 个服务,约 12 GB,加事件湖和实体图
“不需要任何凭据”这句是关键,下面会讲。
三、最能说明它性格的三个数字
数字一:2,966 / 7,407
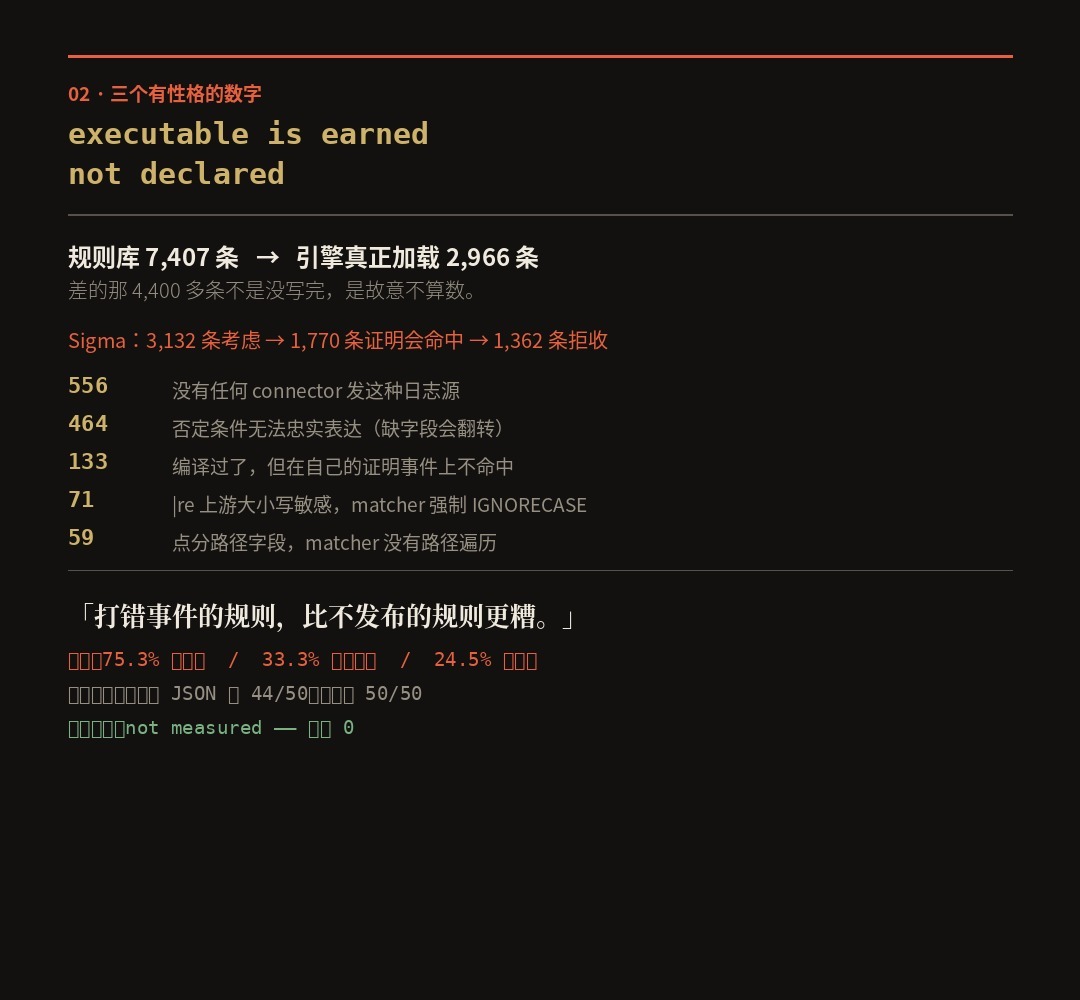
规则库里有 7,407 条,引擎真正加载 2,966 条。
差的那 4,400 多条不是”没写完”,是故意不算数。项目定的规矩叫”executable is earned, not declared”——一条规则要进入编译后的规则集,必须把一个厂商形状的真实事件回放进真实 connector 和真实引擎,看着它真的命中。不能从目录里有没有这个文件推断,也不能从 enabled: 标记推断。
而且这个证明是可以失败的:--prove-gate 会把 Windows connector 撤掉,要求全部 1,687 条 Windows 规则同时静默。撤了还在响,说明这些规则根本不经过那条链路。
Sigma 那部分做得更绝:
| 项 | 数量 |
|---|---|
| 考虑的 Sigma 规则 | 3,132 |
| 编译并证明会命中 | 1,770 |
| 拒收 | 1,362 |
拒收原因列得清清楚楚:
- 556 条 —— 没有任何 connector 会发出这种日志源
- 464 条 —— 否定条件无法忠实表达(缺字段会导致语义翻转)
- 133 条 —— 编译过了,但在自己的证明事件上不命中
- 71 条 ——
|re在 SigmaHQ 上游是大小写敏感的,而这个 matcher 强制 IGNORECASE - 59 条 —— 字段是点分路径,matcher 没有路径遍历
- 还有 30 / 17 / 14 / 10 / 7 / 1 条,各有各的原因
报告里那句话是整篇文档里我最认同的:
拒收是刻意的。一个”差不多对”的翻译改变了规则的含义,而打错事件的规则比不发布的规则更糟。
这里的诚实度也很具体:test 状态的 1,599 条照发(在 SigmaHQ 里 test 只是”被 review 过、社区在用”,不是警告),experimental 的 125 条照发但打标签,只有 deprecated 和 unsupported 直接拒收。
顺带一个细节,说明它连法律义务都当技术问题处理:Sigma 的 DRL-1.1 要求规则命中时标明作者。这个字段长期没被读,所以每条规则只署名了一个仓库、没署名任何个人。结果是 Florian Roth(Sigma 的作者本人)提了 issue #1680 才关掉。 现在 1,770 条规则 100% 带作者名,而且有个 check_detection_attribution.py 会在构建时检查任何 DRL-1.1 规则缺作者就直接失败。
数字二:44/50 和 50/50
make up 会顺带拉起一个 Ollama,跑一个固定的 ~2GB 的 llama3.2:3b-instruct-q4_K_M,纯 CPU 推理。
所以默认安装出来的 triage 结论是真的——真的模型、真的 token 计数、真的写进 Investigation Ledger,不是 stub。
但它不吹这个模型。README 里的原话:在 50 条告警上,约束成 JSON 之前,它给出可用输出 44 次;约束之后 50 次。
更重要的是另一句:“这里从来没有跑过任何托管模型服务——没有可用的 key,所以每个模型的成绩那一行写的是 not measured,不是 0。”
这一句是分水岭。绝大多数项目的 benchmark 表里,”没测”和”测了得 0 分”长得一样。它把这两件事分开了。
数字三:75.3% / 33.3% / 24.5%
告警降噪这个指标,几乎所有 SOC 产品都会报一个漂亮数字。AiSOC 报三个:
- 75.3% —— 老的归并算法
- 33.3% —— 生产口径的归并 key
- 24.5% —— 在”检测形状”的数据集上,而且是在修掉一个缺失标识符、让分组变窄之后
README 里那句是:”不舒服的方向赢。”
我看完的反应是:24.5% 才是那个能拿去跟厂商对比的数。前两个是同一个系统的不同切法,最后一个是被挑刺之后修正的结果。
四、Agent 那部分:它怎么被关在笼子里
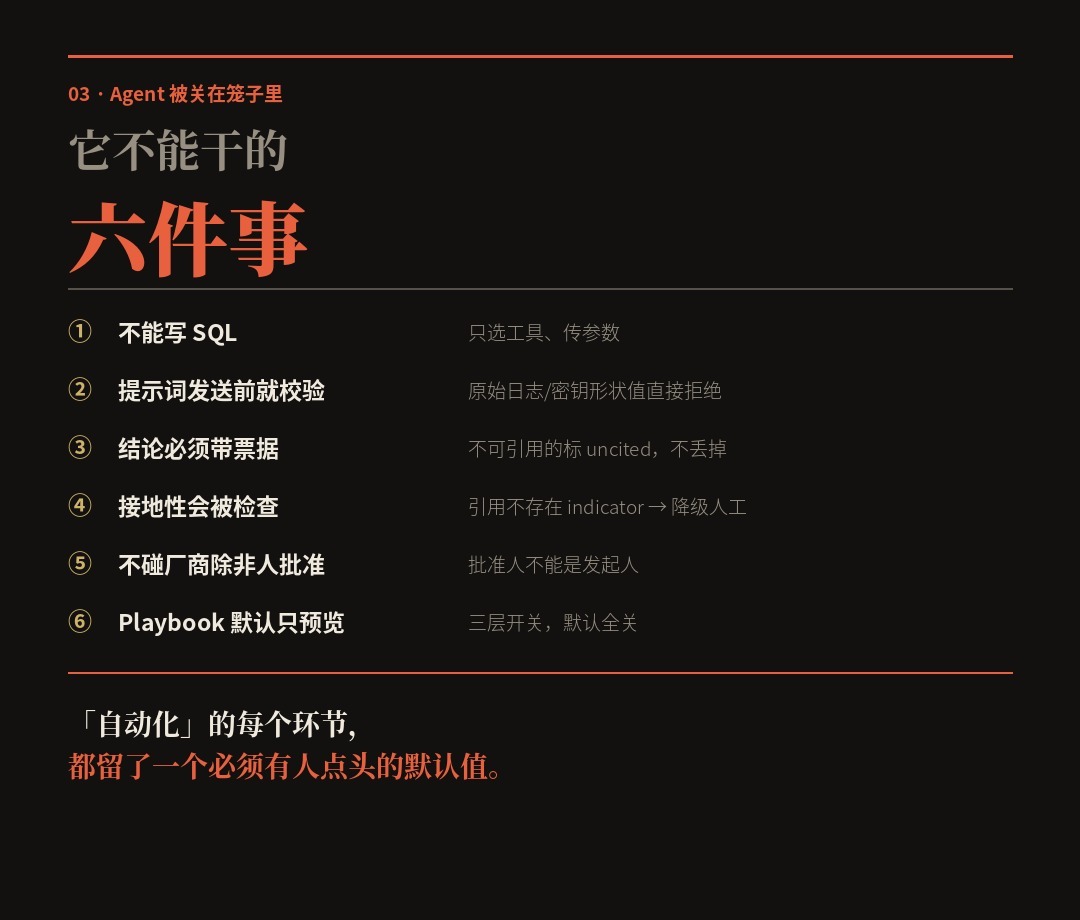
这可能是最实用的一节。因为”AI 分诊告警”这个说法人人会讲,难的是讲清楚它不能干什么。
它的约束是层层叠的:
① 它不能写 SQL。 模型只能选工具、传参数。lake 查询、图遍历、情报查询都是 typed tools,“the model picks the tool and passes arguments; it never writes SQL”。
② 提示词在发送前就被校验。 原始日志、OCSF payload、形似密钥的值直接拒绝,不是发出去之后再脱敏。
③ 结论必须带票据。 copilot 会把每个可核查的论断引用到 ledger 里对应的条目,不能引用的标成 *uncited* 而不是丢掉。任何调查都能导出成签名的证据包——字节一致、prompt 存成 digest、OCSF 1.9.0 格式。
④ 接地性会被检查。 如果结论引用了一个证据里根本没有的 indicator,这条结论降级到人工复审,而不是自动关闭。
⑤ 不碰任何厂商,除非有人批准。 每个响应步骤在派发时按自己的能力契约评级——所以”批准了一个 playbook”不等于”批准了它里面恰好含有的所有动作”。而且批准人必须持有对应权限等级,且不能是发起这个动作的人。
⑥ Playbook 默认只预览。 三个开关必须同时同意——部署级、租户级、playbook 级——而且每一个的默认值都是关。少一个都只跑预览,计划附在告警上。审批步骤是持久化暂停:跑到那一步挂起进 Postgres,重启后还在,审批后继续,超时则带一个记录在案的结果过期,而不是一直挂着。
这套设计的核心思路,我觉得可以概括成一句:“自动化”的每一个环节都留了一个”必须有人点头”的默认值。
五、为什么”不需要凭据也能出真结果”这件事重要
这是我认为整个项目最有价值的工程决定。
core profile 不需要任何外部凭据就能完成”真实事件 → 真实告警”的完整链路。原因是:
- 模型随网关一起发(Ollama + 本地模型)
- 有一个真实外部 feed 随包发:
services/threatintel轮询 CISA KEV 目录(公开、无需 API key),几分钟内就把真实数据填到 Threat Intelligence 页面 - 其余能配的都留空
这就解决了一个长期问题:安全产品的 demo 环境通常是假的。你看到的告警是 seed 进去的,你点的按钮背后是 mock。而这个项目的 make smoke 是这样的:
$ make smoke
[PASS] raw telemetry accepted by ingest
[PASS] event traversed the spine and became an alert
[PASS] alert is retrievable by id from the API
...
PASS: 10/10 stages
10 个阶段,真实的 ingest API、真实的 Kafka、真实的检测、真实的关联、真实的 Postgres,然后从公开 API 把告警读回来。每一步报 PASS 或 FAIL。
而且它的”不给假象”做得挺细:新租户登录后不是看到一个全零的仪表盘,而是一个 setup wizard,状态是从你自己的数据里读的;点 “Load sample data” 载入的 5 个场景走的是真实 connector 用的同一条 ingest 路径,不是插行;而且它们会拒绝载入到已经有真实告警的租户里,也不会把 setup 标记成完成。
六、那 5 个”跑起来才发现的 bug”
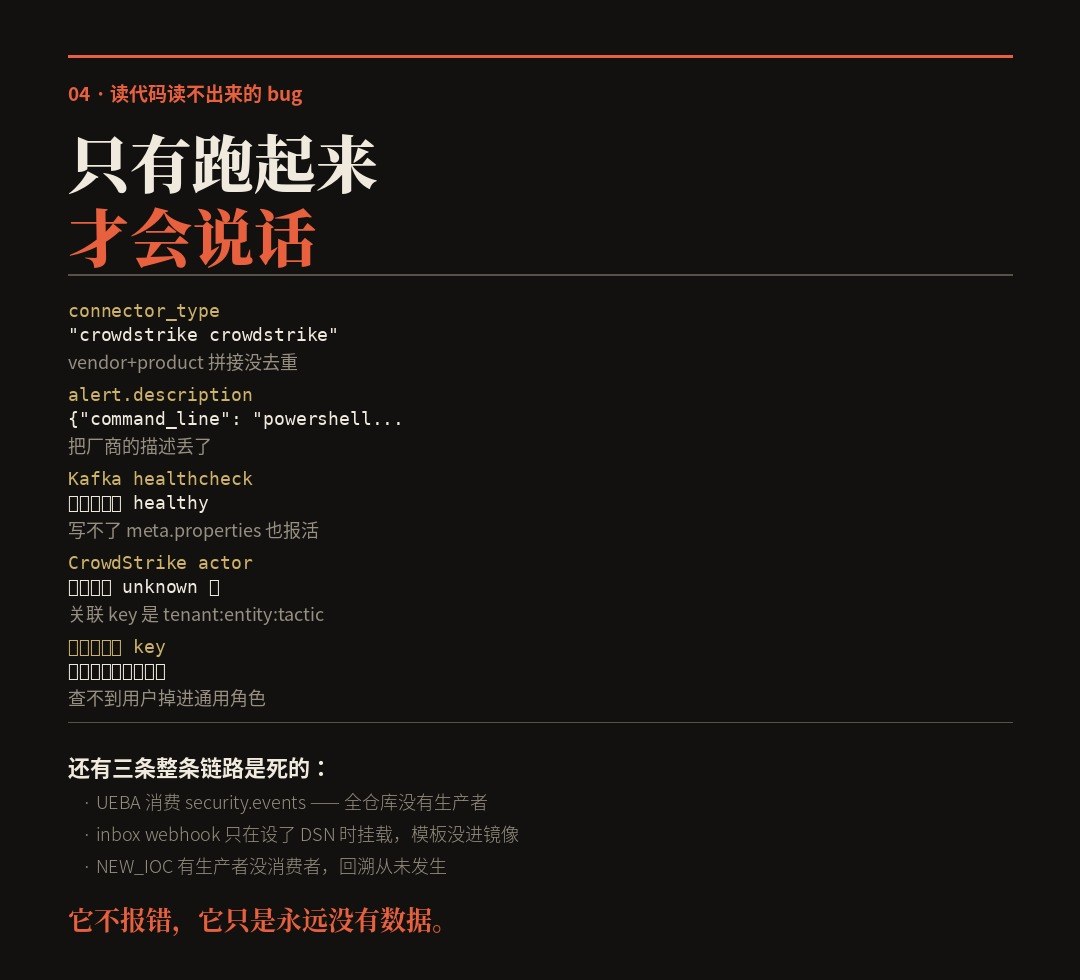
这一节是我决定写这篇的真正原因。REPOSITORY_REALITY.md 里有一节叫”Known defects found by running it”,开头写着:”These were not visible from the code alone.”
① 每条告警的 connector_type 是 "crowdstrike crowdstrike" —— vendor 和 product 拼接时没去重,而且同一个 helper 有两份拷贝。修了。
② 告警的 description 是序列化后的整个事件 —— str(raw_data),所以控制台在”一句话描述”的位置显示了 {"command_line": "powershell.exe -nop ...,把厂商自己的描述丢了。修了。
③ Kafka 的 healthcheck 在一个根本不能服务的 broker 上会通过。 当 Docker VM 磁盘满时,Kafka 写不了 meta.properties、拒绝所有请求,compose 仍然报它 healthy。
④ CrowdStrike 的告警到 fusion 时没有 actor。 这条的自我纠错最值得看:报告里一开始写的是”缺 normalizer profile”,然后自己指出这是误诊——connector 发的是 canonical envelope,走的是 canonical 路径,OCSF 2001 是对的。真正的毛病有两个:connector 从没读过 behaviors[].user_name(Falcon 把执行身份放这儿);canonical 字段映射只认 actor 这个拼法,而 68 个 canonical connector 里有 40 个用 actor、11 个用 username 或 user,那 11 个映射到了空处。
而后果比”少一列”严重得多:因为 fusion 的关联 key 是 {tenant}:{entity}:{tactic},缺 actor 会让所有受影响的告警关联进同一个 unknown 桶。
⑤ 已停用用户的 API key 还能继续认证。 这条最狠。测会话的话根本发现不了——get_current_user 每个请求都重读 users.is_active,停用立刻生效。但 _resolve_api_key 走的是另一条路:它用 is_active == True 查属主用户,查不到就掉进一个通用 api_service 角色而不是拒绝。于是一个离职的人给自己签发的每个 key 都会永久有效。
修的时候还发现,光加 is_active 不够——那个检查是可逆的,重新启用账号会让停用前签发、还没过期的 token 全部复活。所以同时加了会话吊销时间戳,对着新的 iat claim 检查。
这五条没有一条能靠读代码发现。 它们全都需要”真的把它跑起来,然后看它说了什么”。
七、同样的自查,还发现了三个”整条链路是死的”
这部分比 bug 更严重,因为它们是”接线接错了”:
- UEBA 消费的是
security.events这个 topic,而仓库里没有任何服务生产它(ingest 写的是aisoc.raw_events)。所以 UEBA 从来没评过分、从来没发过ueba.anomalies,fusion 那个 UEBA 置信度加权一直是死的——尽管它默认开着。 - ingest 的 inbox webhook 只在设了
DATABASE_DSN时才挂载,而 compose 从没设过;模板文件也没拷进运行时镜像,所以就算设了 DSN,每个模板也都会 503。现在改成go:embed进二进制——”一个目录不可能从镜像里缺失”。 aisoc.threat_intel(NEW_IOC)有生产者没消费者:CISA KEV 每发现一个新 indicator 就发一次事件,没有任何人订阅,所以”新情报命中你已收集的历史”这件事从来没发生过。现在 API 侧的retro_hunt_consumer会消费它,扫每个 opt-in 租户的事件湖。而这里还有个陷阱:pipeline 构造函数的默认 topic 是threat-intel-events,那是不可达的(服务 lifespan 会用KAFKA_TOPIC_THREAT_INTEL覆盖它),所以按签名写出来的消费者会读一个空 topic,然后一直保持健康。
最后这句,是我认为这类系统最难查的一类 bug:它不报错,它只是永远没有数据。
八、它明确说”不”的部分
## What AiSOC is not 这一节,只有四条,但每条都很硬:
- 不是开箱即用的 SIEM 替代品——它做关联和调查,不做长期日志留存和合规检索
- 看不到你没接的遥测——没有资产发现
- 默认不自主——响应需要显式策略授权 + 人工批准
- demo 和 sample incident 不是真实 incident,benchmark 数字是”底座自洽性度量”,不是活的 agent 准确率
还有一节叫 ## Unverified,用”说而不是猜”的口吻列:
- 活的 agent LLM 路径没有验证(没有 provider key),只验证了确定性离线路径;所有 benchmark 行都标
substrate: true,不能读成活的 agent 准确率 - Kubernetes/Helm 只在 kind 上试过:三节点 kind 集群、8 CPU、15.6 GiB、
values-ha.yaml;三个 Kafka broker 组 KRaft quorum、两个 ingest 两个 fusion、1 万个事件全部变成告警行、中途 kill 一个 fusion pod 不丢不重
然后紧接着”同一口气说完”:
UNVERIFIED: 没有试过任何托管 K8s(EKS/GKE/AKS),没有试过裸金属;kind 节点是同一内核上的容器,所以这不是多机证据;release 前面没有 ingress controller 或云负载均衡;PVC 在这个 run 里是关掉的;NetworkPolicy 需要支持它的 CNI,没有验证;托管 Postgres 和 ClickHouse 没用到;最长一次只跑了几分钟,所以关于持续运行、compaction、日志增长、滚动升级一无所知。
“chart 能装、能扛住一次 pod kill”不等于”Kubernetes 生产就绪”。
这段我是逐字读完的。写到这里的人很清楚一件事:“我们试过”和”它能用”之间隔着多少东西。
九、如果你要试:三个必须知道的事
① 硬件不是开玩笑的。 core 要 Docker Compose v2 + 8 GB 内存 + 20 GB 空闲磁盘(在 Docker VM 里,不是宿主机),加 python3 3.9+ 和 bash。首次启动要下载一个 ~2 GB 的模型进 volume,只有 make clean 能清掉。make doctor 会把这些全查一遍,而且是去查询每个数据存储,不是问容器起没起。
② 会生成 15 个密钥。 make up 会自动生成 .env 和里面的 15 个 secret——凭据库、会话签名 key、5 个服务间凭据、4 个数据存储密码——然后创建一个管理员账号,密码生成在你的机器上、只显示一次、不存任何地方。丢了就 make bootstrap ARGS=--reset-password。
③ 端口被占不会挡住安装。 它会换一个空闲端口、告诉你原来那个被谁占了、并把控制台地址一起换掉。文档里给的实测数是:5432 和 11434 都被占的情况下,干净 clone 到登录进控制台 64 秒。
还有个线上环境要注意的点:生产级栈里交互式 API 文档是关掉的(/docs 不可用),规格在 docs/openapi.yaml。
十、它和那些”AI SOC”的区别在哪
我读完的判断是:区别不在模型,在度量。
这类产品的常规卖法是”我们的 AI 能自动关掉 80% 的告警”。AiSOC 的做法是:
- 每个结论的评分卡必须写明是哪个模型真正服务了这次判断,网关证明的或自报的,都要带 provenance 状态;缺失归属、零次真实调用、或走了确定性兜底的 run,不允许被宣传成某个具名模型的成绩
- 分母必须公开,而且”不舒服的方向赢”
- 未测量的写
not measured,永远不写0 - 回放是时间冻结的:历史回放的证据截断在检索查询里执行,不是靠 prompt;而且回放不能执行真实动作,变更边界是写适配器
- 新情报套到旧遥测上是一个独立模式,而且它发现的东西永远不会被算成”当初的预测”
第五条我特别喜欢。因为”用新情报回溯老日志”和”当时就预测到了”,是两个完全不同的能力,绝大多数产品会把前者说成后者。
最后
REPOSITORY_REALITY.md 开头有一句方法论,我觉得可以当整篇的结论:
下面所有标 WORKING 的东西,要么在活的栈上跑过,要么追溯到一个真实路径上的调用者。凡是无法验证的,它就说无法验证。这里没有任何一条是从”文件存在”推断出来的。
一个 6,741 星的项目,把”我早期误导过用户”和”我的 K8s 只在 kind 上跑过几分钟”写进仓库,商业上不划算。
但它换来的是另一种东西:你读它的 README 时,可以相信那些数字。
在这个领域——安全、AI、自动化——最稀缺的不是能力,是”哪些数字可以信”。
项目地址:https://github.com/beenuar/AiSOC 自查报告:https://github.com/beenuar/AiSOC/blob/main/docs/audit/REPOSITORY_REALITY.md
(顺带说一句:作者是 beenuar,开发由 Cyble 资助,但按 README 的说法——”没有 Cyble 专属功能、没有门禁模块、没有遥测”,MIT 协议。)

itadol5j
暂无介绍....
没有啦 (T▽T)
延伸阅读:
AiSOC:6741 星的开源 AI SOC,先学会了对自己说实话
AiSOC 现 6741 星。它最特别的地方不是 AI 分诊,是那份 REPOSITORY_REALITY 自查报告——...

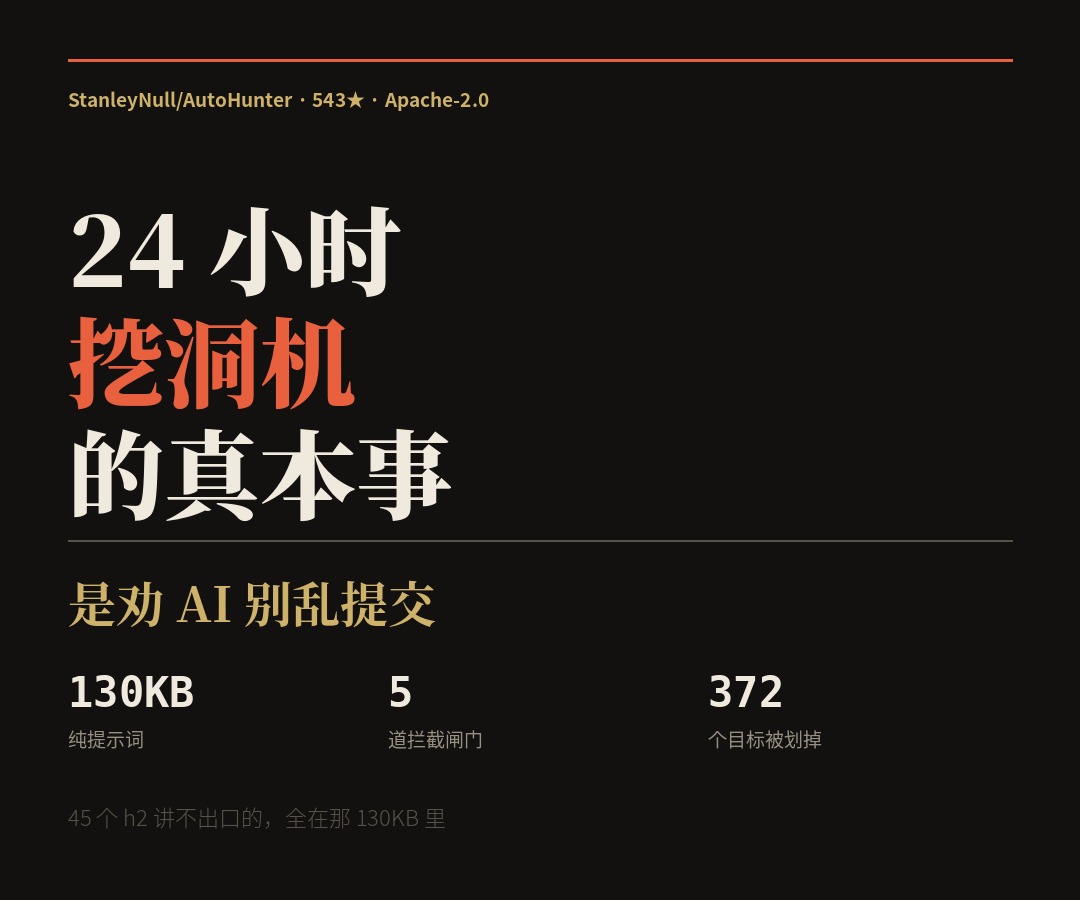
AutoHunter 拆解:24 小时挖洞机的真本事,是劝 AI 别乱提交
StanleyNull/AutoHunter 仓库全量过了一遍:130KB 纯提示词、五道拦截闸门、真实 nmap/nu...
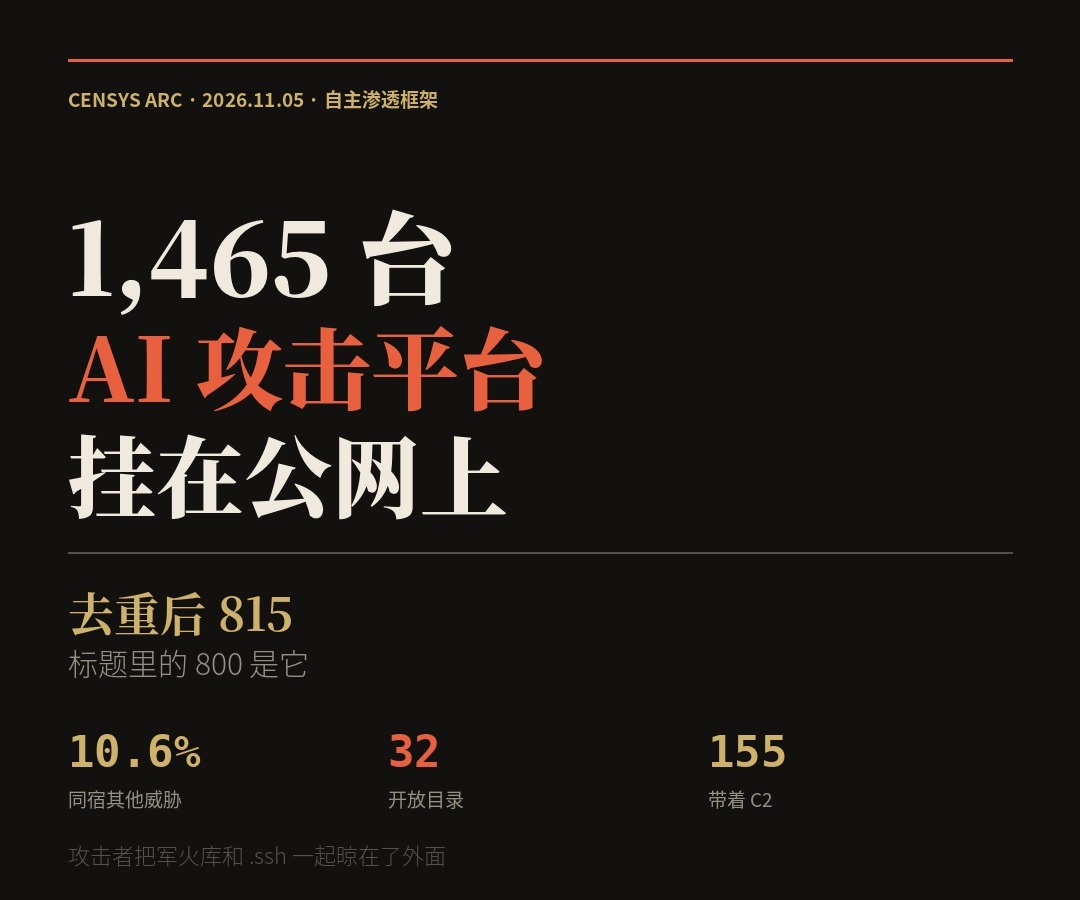
超800个Artex实例暴露公网:AI渗透测试工具反成风险入口
Censys 11月5日报告:1,465台主机在公网跑着 ARTEX 控制台,去掉650台同构模板后约815个独立部署—...
最强的矛也成了最强的盾:GPT-6 Cyber 发布,但成绩单里有四栏是往下走的
把 GPT-6 Cyber 的发布稿、11 月 5 日 System Card、Linux 内核研究报告和 Mozill...
一个星号吃掉所有密码:OpenSSH「sshole」CVE-2026-123158 排查与止血
musl + 无 PAM + 一个密码字段为 * 的账号 + 一个真 $6$ 哈希,四条凑齐就能用 257 字节以上的任...