GLM5、Kimi 2.5、Minimax M2.5、千问、豆包,国产大模型选哪个?
随着国产大模型的快速发展,GLM5、Kimi 2.5、Minimax M2.5、千问、豆包等产品纷纷崛起,让用户在选择时犯了难。今天我们就来详细对比这几款国产大模型,帮助你找到最适合自己的那一款。

各模型简介
- GLM5:智谱AI出品,擅长代码和推理
- Kimi 2.5:月之暗面出品,主打长文本处理
- Minimax M2.5:MiniMax出品,多模态能力突出
- 千问:阿里巴巴出品,开源生态丰富
- 豆包:字节跳动出品,集成生态优势
核心能力对比
各模型在不同维度上各有优势:
- 📝 文本生成:GLM5 和千问表现稳定
- 📚 长文本:Kimi 2.5 依然是长文本处理的天花板
- 🖼️ 多模态:Minimax M2.5 在图片理解方面领先
- 💻 代码能力:GLM5 和千问 Qwen-Coder 表现出色
- 🔧 开源生态:千问开源版本最受开发者欢迎

如何选择?
根据你的使用场景:
- 如果你需要长文本分析,首选 Kimi 2.5
- 如果你注重代码开发,推荐 GLM5 或千问
- 如果你需要多模态理解,考虑 Minimax M2.5
- 如果你喜欢开源生态,千问是不错的选择
- 如果你在字节系产品中使用,豆包集成更方便
总结
没有最好的模型,只有最适合的模型。建议大家根据实际需求和使用场景来选择。国产大模型的竞争日益激烈,未来还会有更多惊喜等着我们。
不妨多尝试几款模型,找到最适合自己的那一款。毕竟,AI的时代,选择权在我们手中。
选择国产大模型,让AI服务中文用户

itadol5j
暂无介绍....
延伸阅读:
Anthropic 放宽 Claude 访问限制:向认证安全人员开放 CVP 三级权限,红队档近乎零拦截
2026 年 10 月 6 日,Anthropic 宣布扩展其 Cyber Verification Program(C...

VAPT 到底是做什么的?NIST SP 800-115 拆解漏洞评估与渗透测试的边界
安全圈里 VAPT(Vulnerability Assessment and Penetration Testing,漏...
AIAIA 是什么?港府《伦理人工智能框架》里的 AI 应用影响评估模板拆解
做 AI 治理文档的人大概都见过这个词:AIAIA——AI Application Impact Assessment,...
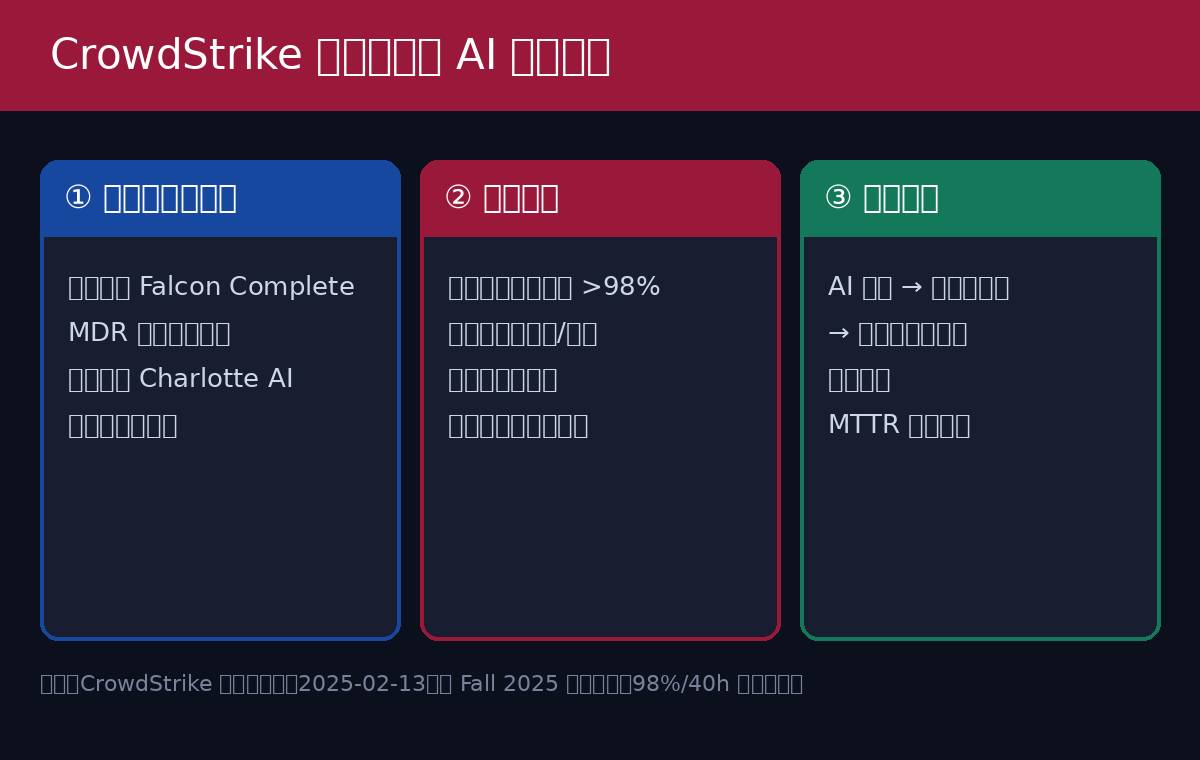
安全圈都在谈Agentic SOC:CrowdStrike 凭什么敢让 AI 做判断?
最近半年,安全圈的会议圆桌、厂商发布会、甲方 CISO 的朋友圈,出现频率最高的词大概就是 Agentic SOC(代理...
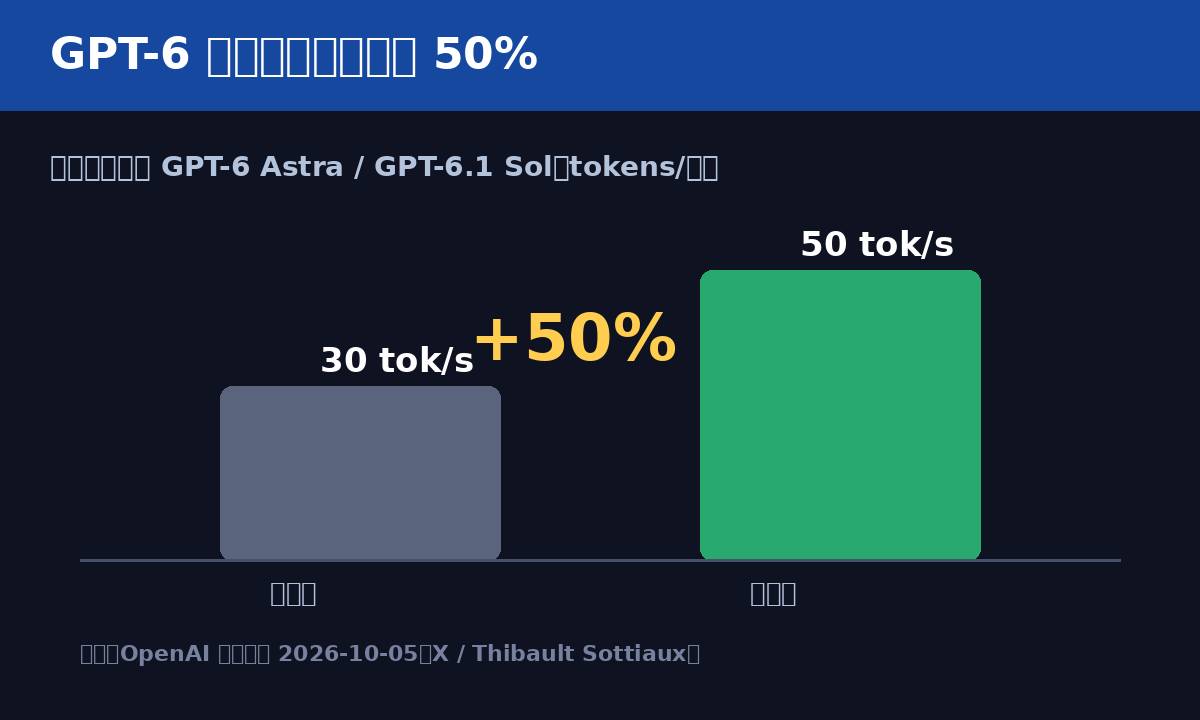
ChatGPT 推出文字水印,GPT-6 提速 50%
很少有 AI 厂商敢笃信「以数量换质量」,OpenAI 偏偏是其中之一。继当年连开 12 天发布会之后,10 月 5 日...