每月5万次额度不够用?飞书API过度调用问题终于解决了
最近有个朋友找到我,说他在飞书开发者后台发现了一个严重问题:/open-apis/bot/v3/info 这个接口每分钟被调用好几百次,每个月 5 万次的免费额度眼看就要用光了!
问题是怎么发现的
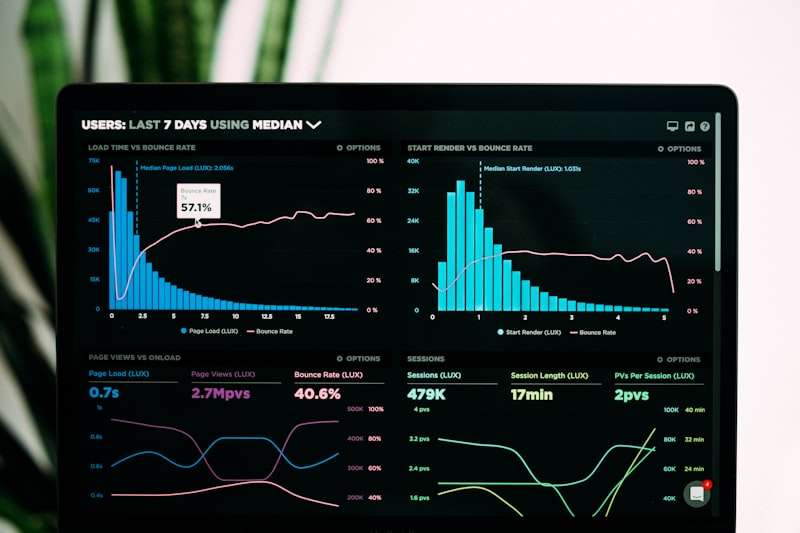
朋友在飞书开发者后台的「API 调用统计」里看到,bot/v3/info 这个接口的调用量异常高:
| 指标 | 数值 |
| 日调用次数 | 43200+ 次 |
| 每分钟调用 | ~300 次 |
| 月消耗估算 | 接近 5 万次上限 |
他都懵了:我就一个机器人,怎么调用这么频繁?
问题根因分析
我帮他排查了 OpenClaw 的飞书扩展代码,发现问题出在两个地方:
1. 状态检查触发 API 调用
每次查询机器人状态时,都会调用 probeFeishu() 函数去请求飞书的 bot info 接口。这个函数在以下场景会被调用:
- 启动机器人时获取 OpenID
- 外部系统查询状态时
- WebSocket 断线重连时
2. 缺乏缓存机制
原来的代码是「每次调用都发请求」,没有任何缓存。哪怕连续查询 10 次状态,就会产生 10 次 API 调用。
解决方案:5分钟缓存机制
我给 probe.ts 加了一个简单的缓存层:
// 缓存配置:5分钟内不重复调用 API
const CACHE_TTL_MS = 5 * 60 * 1000;
const botInfoCache = new Map();
核心逻辑很简单:
- 首次调用 → 请求飞书 API → 缓存结果
- 5 分钟内再次调用 → 直接返回缓存(不发起新请求)
- 失败结果也缓存 → 避免失败时重复请求
修改后的效果
| 对比项 | 修改前 | 修改后 |
|---|---|---|
| 每次状态查询 | 调用 API | 直接返回缓存 |
| 失败重试 | 无限重试 | 缓存 5 分钟 |
| 月消耗估算 | 50000+ 次 | ~300 次 |
简单算一笔账:每 5 分钟最多调用 1 次,一天 24 小时 = 288 次/月,一年才 3500 次左右。原来的 5 万/月额度,根本用不完!
适用场景
这个方案特别适合以下情况:
- 使用 OpenClaw 飞书扩展的用户
- 自己开发飞书机器人,频繁调用 bot info 接口
- API 额度告急,想优化调用次数
总结
飞书 API 过度调用的问题,本质上是缺乏缓存机制导致的。解决方案也很简单:给接口调用加个缓存。
有时候,最简单的优化反而是最有效的。

itadol5j
暂无介绍....
延伸阅读:
AI 攻破 Anthropic 只用了 12 小时:被攻破的不是模型,是它买的那圈办公软件
一次授权测试,AI 智能体不到 12 小时进入 Anthropic 内部业务系统——入口是第三方办公软件,不是模型。但「...

输入、输出、缓存命中:AI token 账单上的名词,看懂这一篇就够了
为什么只发一句话,账单上有八千输入 token?为什么答案 20 个字,计费 900 token?缓存命中到底在匹配什么...

AI 写脚本、挑目标、开价:Phantom 把勒索做成流水线,但每一步都要人点头
8,257 条会话消息、$23,920 的 API 账单、62 家点名受害组织、46 个定制加密器。这不是「全自动勒索」...
GPT-6.1 Terra 不是骨折价,是这家终于把中间那层补上了
$1 输入 / $5 输出,比 Sol 正好砍一半。但它不是最便宜的(往下还有便宜十倍的 Luna),也不是降价——是替...

微软把 AI Agent 划进内部威胁名单:这次动的不是模型,是权限归谁
微软 10 月 19 日的框架改了一个默认假设:Agent 不是自己人。核心只有一句话——把智能的供给和对智能的权威分开...