Gemini 4 Argon 发布:1M 输出 token、半价叫板 Opus,但你暂时用不了
9月30日,Google DeepMind 正式发布 Gemini 4 Argon,官方定位是”下一代前沿智能”。这是 Gemini 4 系列的第一个模型,也是 Google 自今年 2 月 Gemini 3.1 Pro 之后,时隔七个月推出的第一款旗舰。中间这段时间 Google 只发了几个 Flash 系列的小模型,一度被外界认为在前沿模型竞赛里掉了队。Argon 就是回应——但它没有对所有人大开大门。
先说最重要的一件事:你现在用不了
Argon 发布当天,只面向 Google Fairwind 计划里的”可信网络防御者”开放。这个计划 9 月 2 日启动,面向各国政府与国家级网络机构、医疗/电信/能源/金融等关键基础设施运营方、核心技术平台,以及做防御性基准测试的学术实验室。申请方需要经过审查、必须使用抗钓鱼的多因素认证,且不得分享或转售访问权限。官方称目前有超过 650 家合作机构。
接下来才轮到付费 API 客户和 Google AI Ultra 订阅用户,然后是开发者、企业和普通消费者,官方说法是”尽快”,但没给具体日期。更关键的是,API 模型 ID 至今没有公布,也没有模型卡和知识截止日期。所以你看到”$2 输入”这种价格,只能理解为官方公布的预期商业定价,不代表今天就能调用。
顺带一提,这也跟 OpenAI、Anthropic 的做法一致——OpenAI 的 Daybreak、Anthropic 的 Project Glasswing,都是把最强的网络安全能力先关在受控通道里。Google 还参加了美国政府的前沿模型发布前自愿审查流程。
1M 输出 token:这次赌的是”长”
Argon 最硬的技术指标不是上下文,而是输出上限从 64K 提到了 1M token,Google 说这是业界领先。注意,是输出,不是输入。
这个区别对做 Agent 的人很重要。以往大家关心”能读多少”,现在关心的是”一次能持续干多久”。一个大型代码迁移任务,可能要反复看仓库、提改动、跑测试、读编译器输出、改方案、再看新报错。输出预算大,模型就不用过早收手、把控制权还给人。Google 的说法是:当模型有空间”深度思考、单次生成几十万 token”,一次解决难题的能力会上一个台阶。
但别把它当成万能药。输出天花板高,不代表它记得住更早的细节、选得对工具、补丁就正确、速度就更快——这些取决于输入上下文、Agent 框架、任务本身和验证环节。而且一个高上限也允许你烧掉一笔钱换来一次失败的尝试。把 1M 当成每个请求的默认预算,大概率不是好工程。按任务设额度、记录实际消耗、对没有可测进展的尝试及时止损,才是用法。
跑分:赢在广度,不是全胜
Google 公布的对比表里,对手是 GPT-6 Astra、Claude Fable 5.1 和 Claude Opus 5.5。综合媒体的统计:在披露的 18 项基准里,Argon 单独第一的有 12 项、并列第一 1 项;Astra 单独第一 3 项,Opus 5.5 单独第一 2 项。也就是说,三大前沿模型里 Argon 拿到的最多榜首,但比赛依然胶着。
领先的地方:
- DeepSWE v1.1(真实长周期软件工程)77.9%,高于 Opus 5.5 的 74.2% 和 Astra 的 74.1%
- Vals Index(按美国 GDP 权重衡量的金融/编程/法律/税务经济影响)68.9%,第一
- AutomationBench(Zapier 的端到端业务执行)51.3%,第一,比 Opus 高 8.8 个点
- Harvey 法律 Agent 基准19.6%,而 Astra 只有 5.4%、Opus 5.5 只有 3.8%——倍率很夸张,但注意绝对值仍然不到 20%,”从很低基数出发的大幅提升”容易显得比实际更确定
- LVBench(长视频理解)91.7%,SOTA
- CWE-bench v1(漏洞修复)68%,与 Astra 并列第一
落后的地方,同样要摆出来:
- FrontierSWE v2:Astra 65.5% vs Argon 55.0%,差 10.5 个点
- Terminal-Bench Science 0.1:Astra 68.1% vs Argon 57.6%,同样差 10.5 个点
- Terminal-bench 4.0:Opus 5.5 的 66.4% vs Argon 57.4%,差 9 个点
- PostTrainBench:Opus 49.3% vs Argon 45.3%
这就是为什么”选谁”依然取决于你的活儿长什么样。DeepSWE 领先不代表 FrontierSWE 也领先,两套基准抽的仓库、任务长度、语言、工具行为都不一样。如果你的负载更像 FrontierSWE 或终端密集型任务,就没有理由把 Astra 和 Opus 移出候选。
第三方那边,Artificial Analysis 给出 Intelligence Index 53 分,与 GPT-6 Astra 持平,只落后 Claude Opus 5.5 和 Sonnet 5.5;作为对照,Gemini 3.1 Pro 是 30 分。Fello AI 还提到它是 Artificial Analysis 测过的头部模型里幻觉率最低的。同时彭博报道,一些 Google 内部员工认为它在真实编程工作上仍有吃力。
Google 自己已经在重度使用
官方举了几个内部案例,这是全文里最有信息量的部分,因为它们是真实生产环境的落地,而不是实验室跑分:
- 量子算法优化:帮助量子计算团队优化关键应用里子程序的时空资源(qubit × gate),有一个案例在几分钟内超过已发表基线 40%
- 内存效率:一组 Argon Agent 分析全机队 profiling 遥测,自动找出并应用内存优化,铺开后释放超过 300 TiB 内存,预计总节省 500 TiB 到 1 PiB
- C/C++ 转 Rust:从 re2、libgav1 这类核心库的几万行,一路到 Fuchsia OS Zircon 内核的 80 万行以上。这些系统太关键,所以大规模重写在上生产前要走严格的自动化+人工审计、仿真测试和评审
最具体的是 libgav1——Google 开源视频解码器。Argon Agent 接手一个已有的 Rust 移植版,通过多轮 profile-guided 实验、研究编译器输出,替换了 32K 行 SIMD 代码,产出编译器能自动向量化的安全 Rust。结果是内存安全的解码器,比原 Rust 移植版快 2.7 倍,视频输出完全一致。
网络安全:Argon 的第二个主战场
Argon 被专门训练来做网络安全防御,能力是自主发现、验证并修复关键软件漏洞。对可信防御者和 Google 内部团队,Google 会去掉网络安全护栏发布,让他们用满前沿级的防御能力。
已披露的战绩:Wiz 通过它的 Scan for Good 计划用 Argon 免费保护关键公共基础设施,模型在全球医院使用的医疗软件里发现了一个暴露敏感个人信息的严重漏洞,而之前的前沿模型都没发现。此外在 Google 内部的综合漏洞基准上,Argon 在横跨 20 种编程语言的复杂代码库里找出了一批暴露面;在 Wiz 内部的黑盒渗透测试基准上,它在发现攻击面、识别漏洞、产出 PoC 证据这几项上都超过了 Gemini 3.8 Flash Cyber。
Fairwind 计划的第一批交付,是 Gemini 3.8 Flash Cyber 搭配 CodeMender 框架,帮防御方发现、验证和修复漏洞。
定价:半价开场,之后翻倍
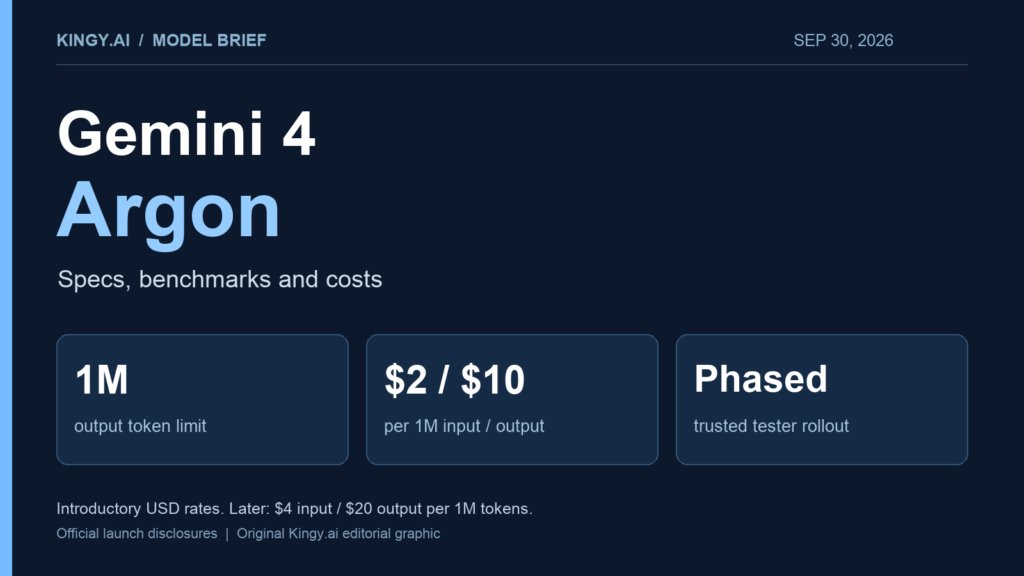
引入期价格是每百万输入 token 2 美元、输出 10 美元,缓存输入按输入价的 95% 折扣,也就是约 $0.10/百万缓存输入。引入期结束后涨到 4 美元输入 / 20 美元输出,缓存输入约 $0.20。Google 没说这个”引入期”有多长,不过行业惯例是——有时候这种”促销价”会一直留着当正式价。
放在同一张价格表里就看得清楚:引入期的 Argon 是 GPT-6 Astra($10/$50)的五分之一,是 Claude Opus 5.5($4/$20)的一半。这个定价给了 Google 两个不同的故事——促销期它是最便宜的头部模型之一,促销结束就和 Opus 5.5 同价了。
发布前的安全闸门
Google 在四个方向加码了前沿安全措施:
- 防滥用:设计上拒绝有害的网络与 CBRN 请求,同时保留正当的双用途科研;改进了监控模型内部激活来识别滥用的技术。护栏经内部和外部红队用人工+自动化攻击方法做了鲁棒性测试
- 防提示注入:Google 称 Argon 是”迄今对间接提示注入最有韧性的模型”。Gray Swan 的 IPI 基准上攻击成功率 0.7%,对比 Opus 5.5 和 Fable 5.1 的 1.0%、GPT-6 Astra 的 8.5%、GPT-6 Sol 27.0%、GLM 5.3 31.5%、Grok 4.8 高达 51.8%——这个差距相当悬殊
- 监控目标偏离:监控 Argon 的思维链和动作,必要时中断执行。Google 还在训练过程中用了类似系统,跑偏就告警给专门的应急响应团队,并特意避免把发现回流进训练,以免塑造出会规避监控的推理方式
- 加固系统:按”Agent 控制路线图”,在高风险训练或评估开始前,把沙箱环境隔离并封存
其中”故意不把监控发现喂回训练”这一条,是这份公告里最值得品的一句——它指向一个真问题:如果你用监控结果去训练模型,模型可能学会的是”如何不被监控发现”,而不是”如何不发散”。
怎么看这次发布
对企业来说,这次发布的意义不在于”又一个聊天机器人”,而是 Google 在 OpenAI 和 Anthropic 持续施压几个月后,重新证明自己还坐在前沿牌桌上。它选的三个落点——软件开发、专业知识工作、网络安全运营——恰好是企业已经在花钱的地方。
但它不需要”全胜”就能改变竞争格局。在 18 项里领先或并列 13 项,已经足够让 Google 主张自己”在广度上领先”;而它落后的那几项——FrontierSWE v2、Terminal-Bench Science、Terminal-bench 4.0——也提醒大家,OpenAI 和 Anthropic 各自仍有明确的技术强区。
实用的结论只有一句:模型选型还是取决于你的工作负载。拿你真实的活儿去试点,别拿一张好看的跑分表来选型。真正的分水岭是 Argon 什么时候对开发者、企业和消费者开放——那才是这场发布从新闻变成生产力的时刻。
前沿竞赛没有终点,只有下一轮。

itadol5j
暂无介绍....
没有啦 (T▽T)
延伸阅读:
Gemini 4 Argon 发布:1M 输出 token、半价叫板 Opus,但你暂时用不了
9月30日,Google DeepMind 正式发布 Gemini 4 Argon,官方定位是"下一代前沿智能"。这是 ...

下一代 SOC 怎么建:一文讲透 ASOP(Agentic Security Operations Platform)
SOC(安全运营中心)这个词,做安全的人都不陌生。但这两年它有点尴尬:SIEM 收集日志,EDR 抓终端,AI SOC ...
分享一些 Jev 的有趣应用:一个不做答案、只做判断的 AI 模型
最近 AI 圈冒出一个不太一样的模型——Jev。它不跟 GPT、Claude 抢"写答案"的活,反而盯着一个被忽视的位置...
负载均衡 LoadBalance 详解:也称之为 F5,以及真实案例介绍
做运维和安全的,几乎都绕不开一个词——负载均衡。而一说负载均衡,很多人脑子里蹦出来的第一个设备就是"F5"。有意思的是,...
CyberStrikeAI 部署实录:简单的工具部署也要讲细节
最近在折腾 CyberStrikeAI,一个基于 Go 写的 AI 原生安全测试平台。本以为"一键部署"嘛,clone ...