安全圈都在谈Agentic SOC:CrowdStrike 凭什么敢让 AI 做判断?
最近半年,安全圈的会议圆桌、厂商发布会、甲方 CISO 的朋友圈,出现频率最高的词大概就是 Agentic SOC(代理化安全运营中心)。而真正把这个词定义成行业叙事的,是 CrowdStrike。问题也随之而来:SOC 里让 AI 自动分流告警、判断恶意与否,出了错谁负责?CrowdStrike 凭什么敢让 AI 做判断?
先看清背景:响应窗口从”周”压缩到”秒”
CrowdStrike 在 Fall 2025 发布中给出的判断是:攻击者正在 AI 化,突破时间(breakout time)已经从小时级缩到分钟级,分析师的反应窗口被压缩。SOC 团队每天淹没在告警、工单队列和重复调查中——靠人海战术排序误报,已经跑不过机器发起的攻击。这是 agentic SOC 被提出的一线压力:不是想让 AI 替代人,而是人已经处理不完。
第一个底气:数百万条专家决策的训练数据护城河
让 AI 做判断,最怕的是判断质量没有依据。CrowdStrike 给出的答案藏在它最不起眼的资产里:Falcon Complete Next-Gen MDR 服务。过去十多年,这支”黄金标准”托管检测与响应团队在真实客户环境里做了数百万次人工分诊决策——每一条都是带上下文、带专家标注的对抗样本。
Charlotte AI 正是用这些数据训练的,而不是通用互联网语料。官方在 Detection Triage 新闻稿里强调:与在宽泛知识库上训练的通用模型不同,Charlotte AI 基于专有数据集,判断依据来自真实对手战术。换句话说,它敢让 AI 学着”拍板”,是因为 AI 学的是一线安全专家多年积累的判断本身。这就是数据飞轮的第一环:训练数据来自人类专家,而不是公开文本。
第二个底气:有界自治(Bounded Autonomy),边界由客户划
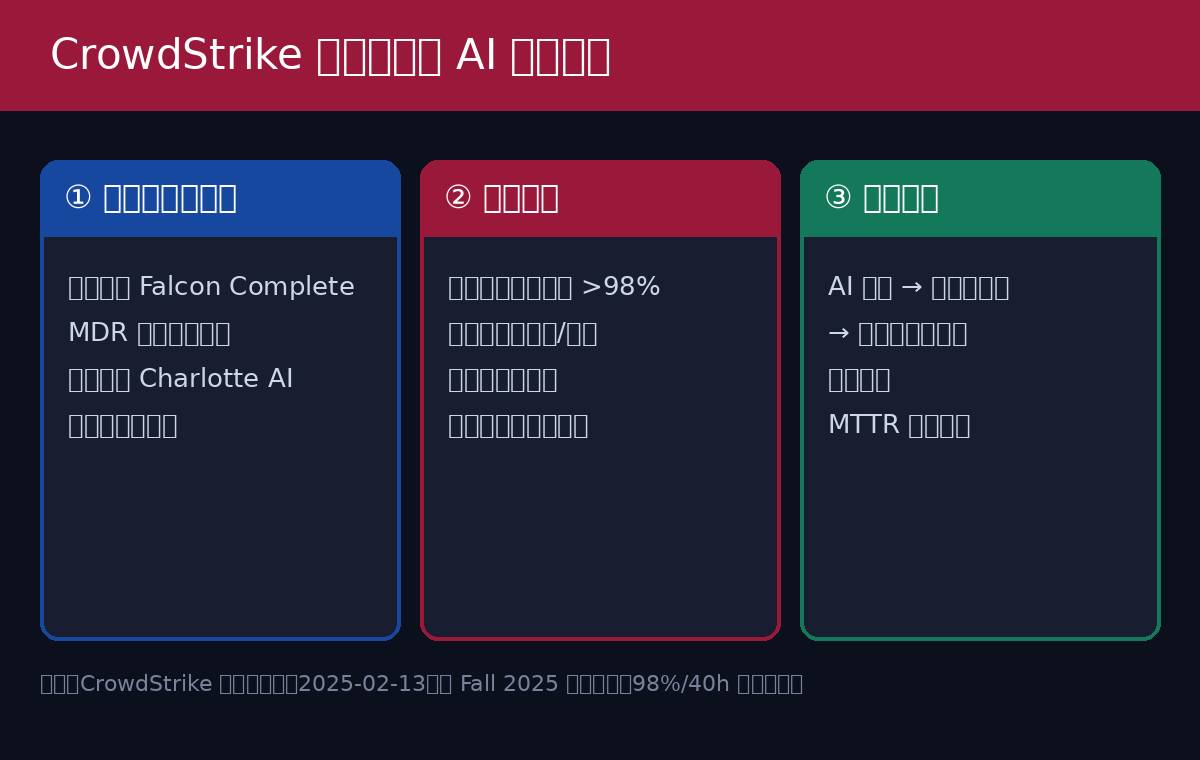
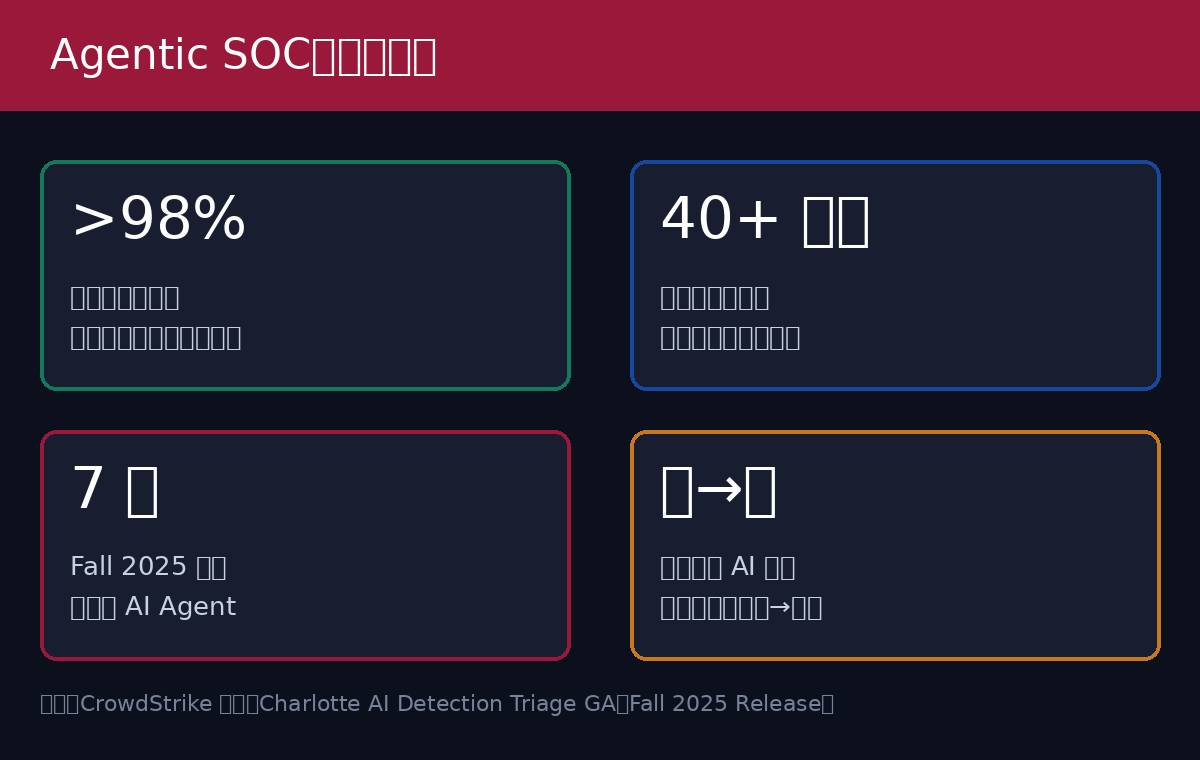
这是整个故事里最关键的工程设计。2025 年 2 月 GA 的 Charlotte AI Detection Triage,官方口径是:在客户定义的有界自治模型下运行,检测分诊准确率超过 98%,平均每周为 SOC 消除 40 小时以上的手工工作。
注意”有界”两个字:AI 不是拿到一把万能钥匙,而是安全团队自己定义什么时候、以什么方式允许自动化动作发生——从分诊到最终响应,护栏内置,人类保留完全监督权。CrowdStrike CTO Elia Zaitsev 的说法很直白:让组织”控制何时以及如何发生自动化动作,保持 AI 可信、可问责、处于人类代理之下”。
这套设计回应了甲方最大的顾虑:不是 AI 行不行,而是出了事能不能兜住。高置信度的低危告警让 AI 直接关单;涉及处置动作(隔离主机、封禁账号)则升级给人类审批。AI 做的是”按你划的线内自主判断”,不是”无人驾驶”。
第三个底气:分析师复核构成闭环,越用越准
有界自治还带来一个副产品:每一次人类复核、推翻、修正 AI 的判断,都会回流成新的训练信号,形成官方所说的”闭环反馈流程,持续改进安全结果”。AI 判断 → 专家校准 → 数据回灌,模型在人机协作中不断逼近专家水平。这也是为什么 CrowdStrike 在 Fall 2025 把分析师的定位从”操作员”抬升为”编排者(orchestrator)”——人指挥一支会推理、决策、行动的 agent 舰队,而不是人肉过滤告警。
 数据层与 Agent 军团:光有判断还不够
敢让 AI 判断,前提是 AI 看得懂全局。Fall 2025 发布中,CrowdStrike 同步推出了三块拼图:
- Enterprise Graph:统一端点、身份、云、SaaS、XIoT 和第三方工具遥测的 AI-ready 数据层,官方自称”行业最丰富的 AI 就绪数据层”,配单一查询语言,人和 agent 都能即时调用每个信号。
- 七个任务型 Agent:暴露面优先级、恶意软件分析、威胁狩猎、关联规则生成、搜索分析、工作流生成、数据转换——分别对应 SOC 里最耗人力的七类流程。
- Charlotte AI AgentWorks(2026 年 3 月上线生态):让安全团队用自然语言自建、测试、部署专属 agent,自带企业级治理;把”造 agent”的能力交给客户自己。
再叠加 Threat AI(自称行业首个代理化威胁情报系统)、Agentic MDR(RSA 2026 上发布,Falcon Complete 分析师亲自编排智能体对抗 AI 加速的威胁),以及 AIDR(AI 检测与响应,反过来保护企业自己用的 AI)——判断力、数据、编排、治理四层齐备,才构成”敢”的完整逻辑。
冷静一句:98% 是厂商口径
值得提醒的是,98% 准确率、每周省 40 小时均为 CrowdStrike 官方宣称,基于其内部评估与客户协作数据,尚未见第三方独立验证。安全决策的误报代价天然不对称:放过一个真阳性的成本,远高于多审一个误报。所以行业当前的共识姿态是:让 AI 干”排序、分流、摘要”这类高容错环节,把”关停、处置、定性”留给有界自治框架内的人类审批。Agentic SOC 不是无人驾驶,而是有安全员盯着的自动驾驶。
一点观察
CrowdStrike 的”敢”,本质上是十年 MDR 数据积累 + 有界自治工程设计 + 人机闭环的组合拳。它真正卖的不是”AI 会判断”,而是”AI 按专家的判断学、在你划定的边界内判断、并且每次判断都可被人类校准”。对甲方来说,评估 agentic SOC 的清单也可以照这三条来问:训练数据从哪来?边界谁定义?闭环怎么转?——答不上这三问的”AI 安全运营”,多半只是聊天机器人换了个皮肤。
信息来源

itadol5j
暂无介绍....
延伸阅读:
VAPT 到底是做什么的?NIST SP 800-115 拆解漏洞评估与渗透测试的边界
安全圈里 VAPT(Vulnerability Assessment and Penetration Testing,漏...

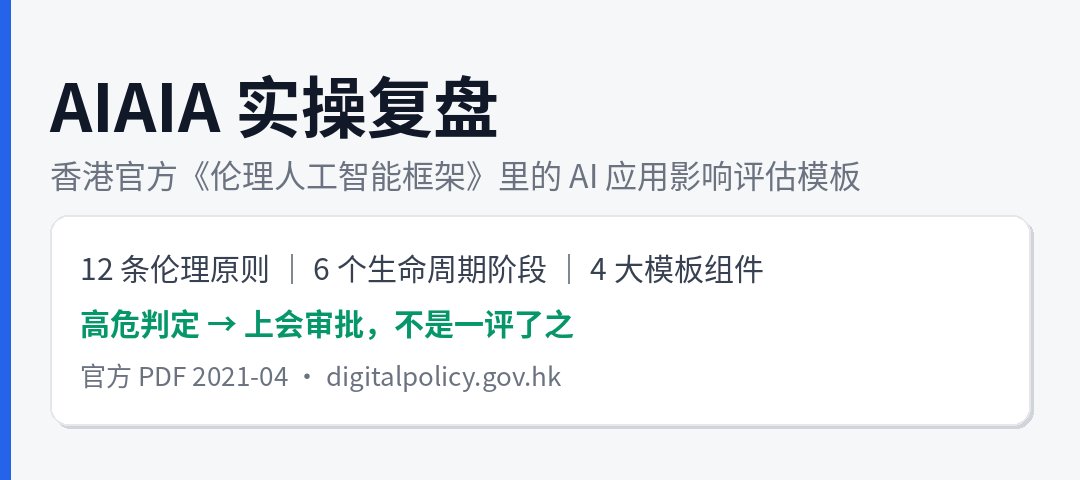
AIAIA 是什么?港府《伦理人工智能框架》里的 AI 应用影响评估模板拆解
做 AI 治理文档的人大概都见过这个词:AIAIA——AI Application Impact Assessment,...
安全圈都在谈Agentic SOC:CrowdStrike 凭什么敢让 AI 做判断?
最近半年,安全圈的会议圆桌、厂商发布会、甲方 CISO 的朋友圈,出现频率最高的词大概就是 Agentic SOC(代理...
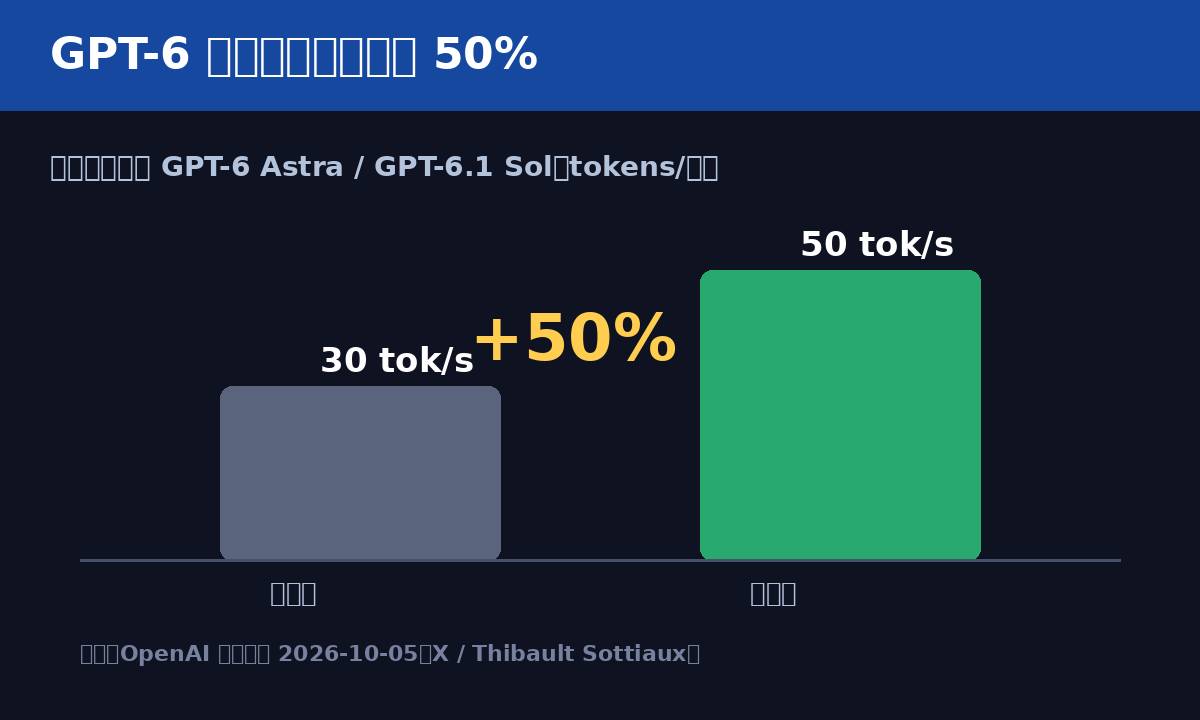
ChatGPT 推出文字水印,GPT-6 提速 50%
很少有 AI 厂商敢笃信「以数量换质量」,OpenAI 偏偏是其中之一。继当年连开 12 天发布会之后,10 月 5 日...
Jev 被请下王座:StartLux 中国开源决策模型冲上第一,3 天做出五档规格
9 月 30 日,上海 AI 公司 StartLux(原点星辉)发布了完全开源的决策模型 StartLux-Decisi...