ChatGPT 能一键出 GIF 了:表情包自由是真的,但自由的边界比你想象的窄
11 月 4 日,OpenAI 发了 ChatGPT Images 2.6。
官方公告的第一句是「GIFS!」——全大写加感叹号。这个措辞在 OpenAI 的发布史里不常见。
功能本身很简单:给一句话,或者传一张图,ChatGPT 直接还你一个动图 GIF。生成完之后可以调播放速度、逐帧编辑、分享出去循环播放。
公告里配的例子是那句经典的「can you make a gif of a cat dancing?」。
朋友圈里已经开始刷「表情包自由了」。这话有一半是对的,另一半藏在一份没人看的文档里。
我把官方公告、开发者社区的发布帖、The Verge 的报道,还有第三方整理出来的 API 参数表都过了一遍。这篇想说的不是「这个功能很酷」,而是三件更值得琢磨的事。
一、先说清楚它到底给了什么
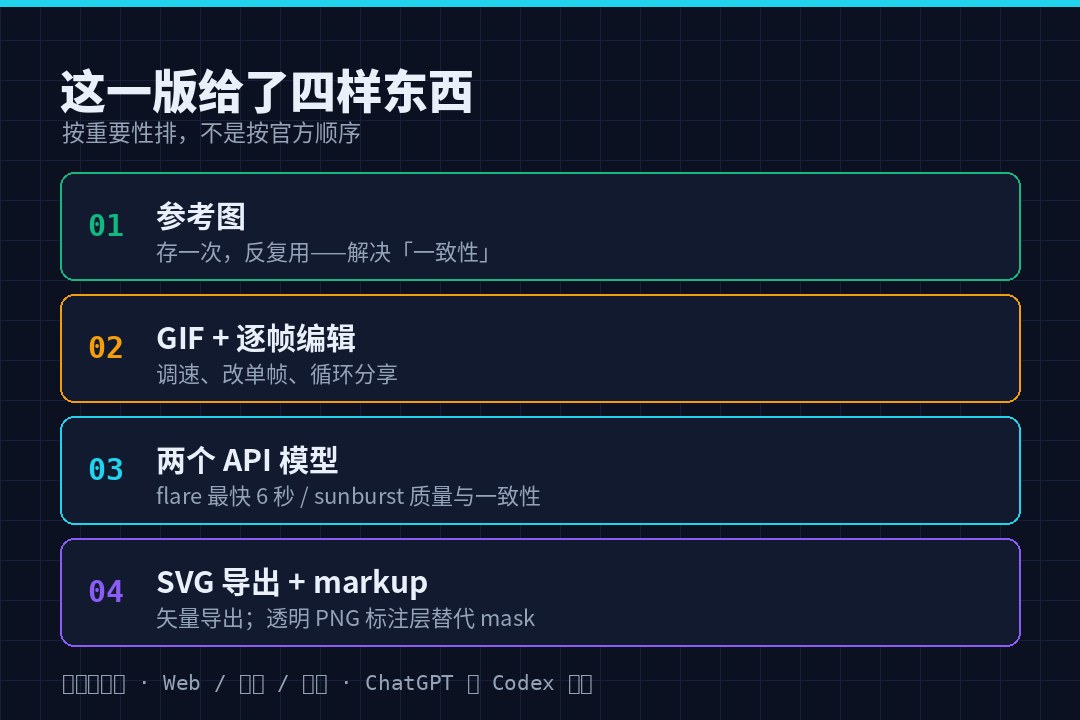
除了 GIF,这次一共四样东西,我觉得按重要性排是这样的:
第一,GIF 生成 + 逐帧编辑。 一句话或一张图 → 动图。可以调速、可以单独改某一帧、可以逐帧查看。这是首次——在这之前 ChatGPT 没法一步直接出 GIF,得先出几张图再自己拼。
第二,参考图(Reference images)。 这个我认为是全场最实用的:把你自己的照片、宠物的照片、某个角色的图存一次,之后每次创作直接调用,不用重复上传。它解决的是「一致性」问题——同一个形象,可以反复用在不同的创作里。
第三,API 上线两个新模型。 gpt-image-2.6-flare 主打速度,最快 6 秒出图;gpt-image-2.6-sunburst 主打质量和编辑一致性,另外支持 SVG 导出。官方说整体生成速度比上一代快 50%。
第四,SVG 导出和图像标注(markup)。 生成的图可以导出成矢量 SVG;编辑时可以传一张透明 PNG 当作「标注层」,在上面画不透明的批注,替代原来的 mask 机制。
覆盖范围:所有 ChatGPT 和 Codex 用户,Web、桌面、移动端全有,所有订阅档位都能用。
还有一个数字值得单独拎出来:OpenAI 说现在每周生成超过 40 亿张图,横跨 ChatGPT 和 API。9 月发 Images 2.5 时这个数字是 30 亿。
七周,从 30 亿到 40 亿。
二、为什么 2026 年了还在做 GIF
这是我最想聊的一段。
GIF 是 1987 年的格式。256 色、没有半透明、压缩算法老旧、文件还大。技术上它比 WebP、AVIF、APNG 全都落后一个时代。
那 OpenAI 为什么不做「动图」,偏要做「GIF」?
答案不在技术侧,在分发侧。
微信的表情包是 GIF。微博的动图是 GIF。Twitter/X 的动图是 GIF。Discord 的表情是 GIF。几乎所有的论坛、评论区、聊天软件的自定义表情,标准答案都是 GIF。
你去看微信的表情包商店,去看 QQ 的表情收藏,去看任何一个「斗图」场景——那个格式叫 GIF。它不是最好的格式,它是唯一被全链路支持的格式。
这件事在别的地方已经演过一遍:HEIC 比 JPEG 好得多,但用户还是要 JPEG;Opus 比 MP3 好得多,但播客还是 MP3。 格式的生死从来不取决于技术指标,取决于「有没有一个环节不支持你」。
所以 OpenAI 做 GIF 这个决定,本质是一个产品判断:要进入「表情包」这个使用场景,就必须说 GIF 这门方言。
这也解释了为什么他们把「逐帧编辑」放在那么显眼的位置。表情包的创作流程是这样的:想出个梗 → 做出画面 → 调一下节奏,因为笑点全在节奏上 → 发出去。
节奏这件事,只有逐帧和调速能做。一张静图做不到,一段视频又太重。
所以「GIF + 逐帧 + 调速」不是一个功能组合,是一个完整的工作流闭环。 这是我觉得这次更新里最见设计功力的地方——他们不是加了个导出格式,是把表情包的生产链路整条搬进来了。
三、然后是那个没人讲的边界
现在说另一半。
我去翻了 API 的参数规范(这部分媒体报道基本没写),把 GIF 的限制整理出来,是这样:
| 参数 | 取值 | 说明 |
|---|---|---|
output_format | gif | 生成和编辑都支持;svg 只支持生成 |
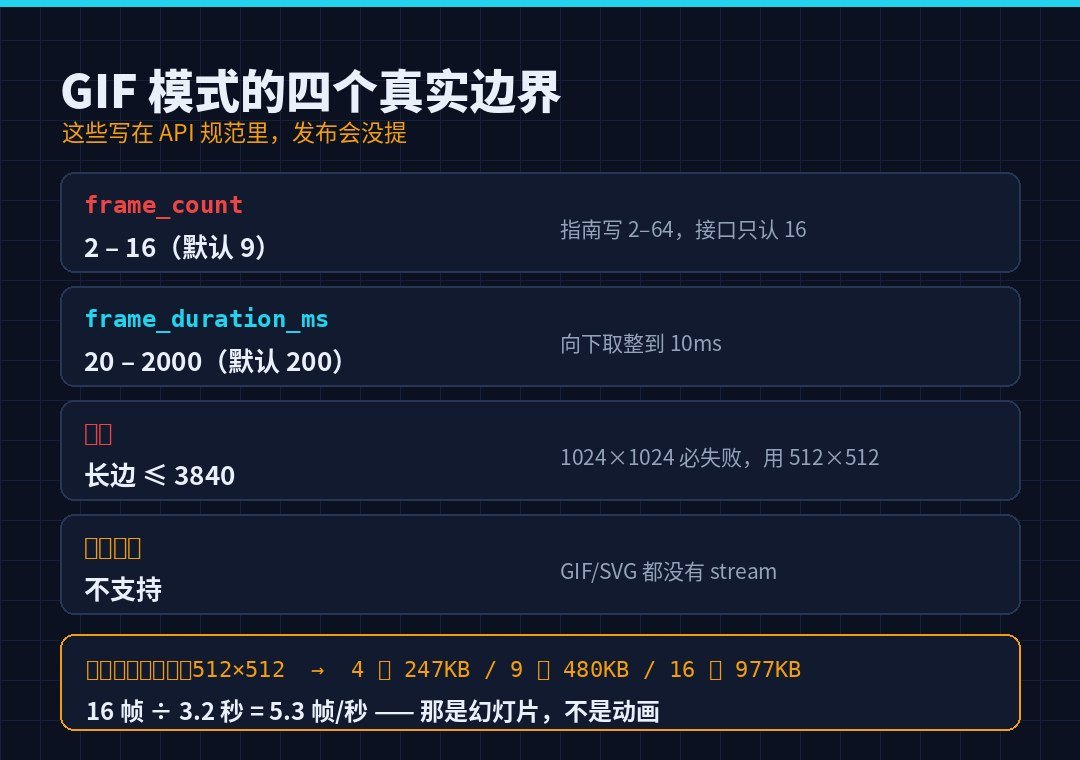
frame_count | 2–16,默认 9 | 只对 GIF 有效 |
frame_duration_ms | 20–2000,默认 200 | 只对 GIF 有效,向下取整到 10ms |
| 单片尺寸 | 长边 ≤ 3840 | 帧拼成一张 sheet 后不能超限 |
| 流式输出 | 不支持 | GIF 和 SVG 都不支持 streaming / partial_images / output_compression |
第一个坑:16 帧封顶,而且文档自己写错了。
官方 GIF 指南里写的是 frame_count 支持 2–64,但 API 参考和实际端点强制 16。第三方实测报了 17、20、32、64 帧全部失败,16 帧成功。
报错长这样:
Invalid 'frame_count' for GIF output. Received 40.
Use an integer from 2 to 16, or omit 'frame_count' to use 9.
文档说 64,接口只认 16。 这种不一致在发布首日制造了一批「我按文档写的为什么不 work」的困惑。
第二个坑更致命:1024×1024 做不了 GIF。
因为 GIF 的实现方式是把所有帧拼成一张大图(sheet)再编码,所以帧数 × 分辨率会迅速撞上像素预算。实测报错是:
No supported sheet fits 9 GIF frames at size '1024x1024'.
Invalid size '4096x2048'. The longest edge must be less than or equal to 3840.注意:降低帧数也没用。 就算只做 2 帧,1024×1024 拼起来长边也是 4096,照样超 3840 的上限。所以 1024 这个最常用的尺寸,在 GIF 模式下直接不可用。
能用的尺寸是 512×512。实测数据:4 帧约 247KB,9 帧约 480KB,16 帧约 977KB。
第三个限制:没有流式。 GIF 和 SVG 都不支持 stream、partial_images、output_compression。想要进度条,没有。
第四个:SVG 是另一套规矩。 必须显式传 svg.model(因为生成流程是「先用图像模型画参考图,再由另一个模型写 SVG 代码」),而且 n 只能是 1,多张不行。
还有一个新参数 complexity(low / medium / high),和 quality 是两个独立维度——前者是「规划投入」,后者是「渲染质量」。而且有个已知的连锁反应:Responses API 里外层的 reasoning.effort 会被透传成图像工具的 complexity,如果你的请求打到的是 gpt-image-2 而不是 2.6,就会报 Complexity 'low' is not supported for this image model——哪怕你根本没传这个参数。
四、所以「表情包自由」到底自不自由
我给个具体判断,分三种人。
如果你只是想做个表情包发群里:基本自由了。
512×512、16 帧、默认 200ms 一帧。算一下:16 帧 × 200ms = 3.2 秒。做表情包这个长度完全够——表情包本来就不该超过 3 秒,超过 3 秒就没人看了。
分辨率也是够的。微信表情的实际显示尺寸比 512 小得多,这个规格甚至有余量。
如果你要做有点品质的动图:不自由。
16 帧意味着你做不出流畅的动作。手绘动画行业的标准是 12 帧/秒以上才不卡,24 帧才叫流畅。16 帧拆成 3 秒是 5.3 帧/秒——那是幻灯片,不是动画。
而且 512 这个尺寸,放大就糊。你没法拿它做 banner、做贴片、做任何需要清晰度的场合。
如果你是要接 API 做产品:一半自由。
好消息是这套东西在 API 里是通的,参数明确、能进流水线。坏消息是它的定位很明确——这是「草稿级 / 社交级」的动图生产,不是「成片级」的。
如果你要做高质量动图,现实的路径是:用 GIF 模式出草稿(快速试节奏、试构图),确认之后再上视频模型或者逐帧出图自己合成。
我猜这是有意为之。 如果 Images 2.6 能直接出 24fps、1080p 的动图,那 Sora 那类视频产品的定位就尴尬了。所以这个能力被刻意限制在「够用但不越界」的位置——刚好覆盖表情包,刚好不碰视频。
这不是技术限制,是产品分层。
五、比 GIF 更重要的,是「参考图」
前面聊的都是输出格式,但我觉得这次更新的重心其实在输入端。
「参考图」这个功能听起来平平无奇——不就是把图存起来不用重复上传吗?
不是。它解决的是生成式图像最根本的一个问题:一致性。
用过的人都懂那个痛:你让 AI 画一只猫,第一次很满意;第二次想让它出现在另一个场景里,出来的猫完全不是同一只。你没有「这个角色」,只有「一堆看起来差不多的猫」。
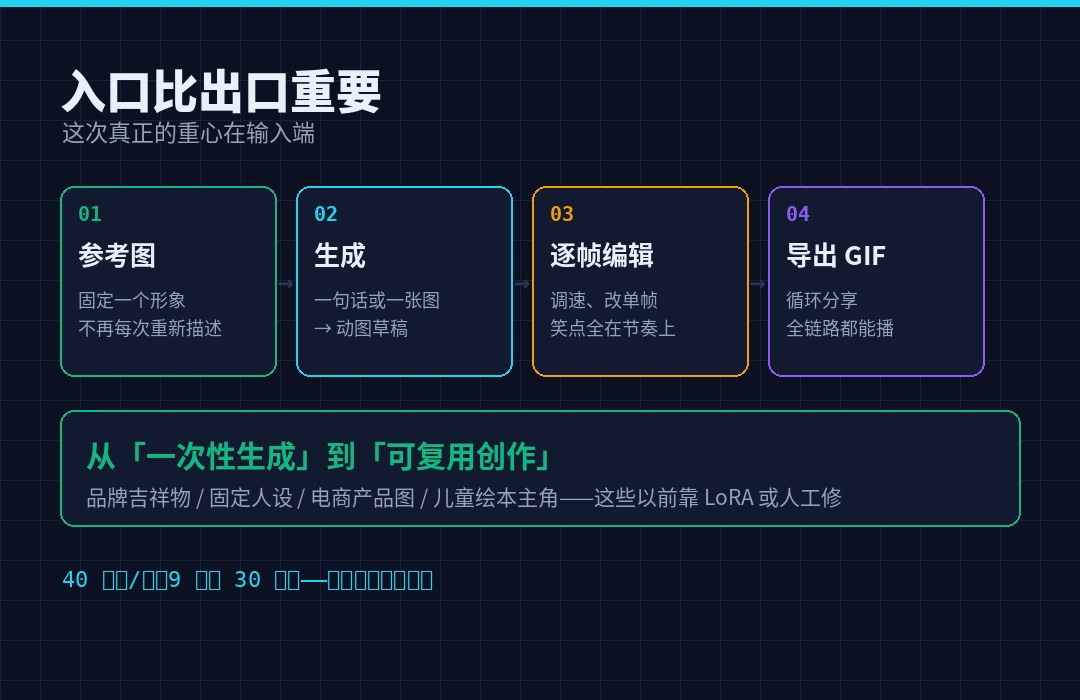
参考图把这件事从「每次重新描述」变成「每次复用同一个身份」。这是从「一次性生成」到「可复用创作」的分界线。
而这个能力,恰好是商业场景的入场券:
- 品牌做吉祥物,需要同一个形象出现在几十张物料上
- 自媒体做固定人设,需要形象稳定
- 电商做产品图,需要商品本身不变、场景随便换
- 做儿童绘本,需要同一个主角贯穿全书
这些需求以前要么靠 midjourney 的 --cref 之类的技巧硬凑,要么靠 LoRA 训练,要么靠人工修。现在变成「存一张图,然后一直用」。
配合逐帧编辑,你其实得到了一个小小的「角色动画流水线」:固定一个形象 → 生成动图 → 逐帧修 → 导出 GIF。
GIF 是这个流水线的出口,参考图是入口。入口比出口重要。
六、还有一个不太被人提的事:成本
开发者社区里有个帖子我觉得值得引一下,因为它说的是钱。
那位开发者的观察是:2.6 在 quality: low 和 medium 两档下,输出 token 的计费比 2.5 高不少。他贴了自己的估算——如果按「同样的原始成本」算,low 档要乘 4.2,medium 档要乘 3.3,high 及以上是 1.0。
他的原话挺不客气:「这看起来纯粹是为了让你做不出便宜的图,是成本乘数,不是图像算法。」
我要说明:这是社区里的个人测算和判断,不是 OpenAI 的定价说明,我没办法独立核验这组倍数。 OpenAI 的官方定价页我这轮没打开(官网对抓取返回 403)。
但他指出的现象值得留意:如果低质量档变贵了,那「快速出草稿」这件事的成本结构就变了。 而草稿恰恰是这次 GIF 功能最自然的用法。
同一个帖子里还有个观察我也觉得成立:2.6 出的图,对「可识别真人」的处理变保守了(他举的例子是把某个剧里的人物做成蒙太奇,2.5 版能认出来,2.6 版认不出来了)。这在合规上是好事,但在「做真人表情包」这个场景上是减分。
这两条合起来是个信号:便宜快速的草稿可能变贵了,可识别真人的创作可能变难了。 如果你的用法正好落在这两块,先自己测一遍成本再决定要不要迁。
七、这件事在更大的图里是什么位置
我想说的最后一点,跟 GIF 无关。
40 亿张/周这个数字,比任何功能都更能说明问题。
一周 40 亿张图,意味着平均每秒产生 6600 张。这个量级已经超过「人类创作图像」的历史总和不知道多少倍。图像生成不是「一个新功能」,它是当前 AI 最大的消费级用途之一。
在这个体量下,OpenAI 这次更新的方向就很清楚了:不是提升画质上限,是提升工作流的可用性。
- 参考图 → 解决一致性(可复用)
- 逐帧编辑 → 解决可控性(可修改)
- SVG 导出 → 解决可用性(可进设计流程)
- 两个 API 模型(快 / 好)→ 解决成本分层(可按需选)
这四件事都不是「画得更好看」,都是「更好用」。画质在 2.5 到 2.6 之间没有代际跃迁——官方说的「快 50%」是速度,不是质量。
这是一个成熟产品该有的迭代方向:从「哇它能画」转向「它能进我的流程」。
而 GIF 是这个转向最好的注脚。它不是技术前沿,它是 1987 年的格式;但它通向一个真实存在的、每天有几亿人在用的场景。
技术产品的成熟,往往表现为它开始愿意为「不够先进但足够普及」的东西做适配。
最后,几点实操建议
如果你要去试,我建议按这个顺序:
第一,先用 512×512。 别在 1024 上浪费时间,GIF 模式下它必然失败(拼图后长边 4096 > 3840)。如果内容确实需要更大,生成完再放大。
第二,frame_count 控制在 16 以内。 官方指南写的 2–64 是错的,接口只认 2–16,默认 9。
第三,先想节奏再想画面。 表情包的笑点 90% 在节奏上。16 帧配 200ms 是 3.2 秒,如果梗需要更快,把 frame_duration_ms 降到 100 甚至更低(下限 20),帧数不用加。
第四,去买「一致性」而不是「画质」。 花时间把参考图建好(自己、宠物、固定角色),这个投入的回报周期比追新模型长得多。
第五,如果接 API,记得去掉 stream、partial_images、output_compression。 GIF 和 SVG 都不支持,留着会直接报错。
至于「表情包自由」这个说法——我觉得可以改成更准确的一句:
你自由了,但自由的范围是 512 像素、16 帧、3 秒。在这个框里,你可以随便造;出了这个框,你还是得回去用别的工具。
知道框在哪,比以为框不存在要好。

itadol5j
暂无介绍....
没有啦 (T▽T)
延伸阅读:
ChatGPT 能一键出 GIF 了:表情包自由是真的,但自由的边界比你想象的窄
ChatGPT Images 2.6 在 11 月 4 日上线,一句话或一张图直接出 GIF,能调速、能逐帧改。但 AP...

Android 11月补丁:216 个洞、23 个严重,零点击 RCE 在列——先查这三个数再点升级
Android 2026 年 11 月安全公告修了 216 个 CVE,23 个 Critical,最严重的是 Fram...
AI Agent 出事那天,你多半找不到「现场」:一份能照着跑的应急响应方案
Agent 出事那天,没有进程树、没有内存镜像、甚至说不清是哪台机器——传统应急的三大支柱在这里全部失效。一份可以照着跑...
552B 的模型,每次只叫 8B 起床:把 DeepSeek V4.1 Flash 的 MoE 讲成人话
552B 总参数、8B 激活,差 69 倍,两个数字却能同时成立——中间那个东西叫 MoE。用一家 384 个部门的公司...
李佳琦首卖Token,阿里92年副总裁站台:这场直播真正上链接的不是Token
李佳琦今晚首卖 Token,阿里最年轻副总裁陈宇森站台。但算完账你会发现:20 万亿 Token 折成钱是几千万级预算,...