Claude Fable 5.2 拆解:14 项跑分 13 项超上代,但它自己砍了三刀
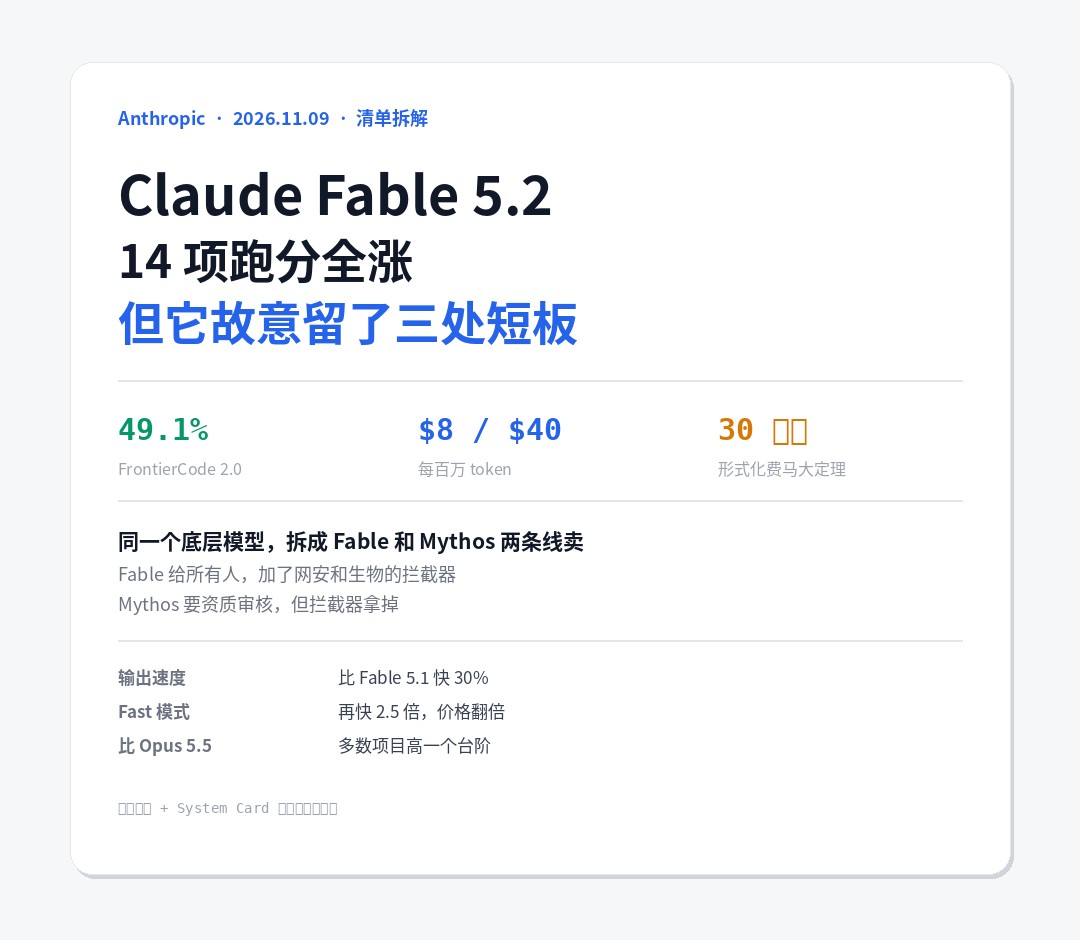
一句话说清:Anthropic 11 月 9 日发了 Claude Fable 5.2 和 Claude Mythos 5.2,同一个底层模型,两套安全拦截器。14 项跑分里 13 项超过上一代,价格 $8 / $40 每百万 token。
但它自己在文档里承认了三件事,比跑分有意思得多。
下面全是清单,能照着用的那种。
一、先搞清 Fable 和 Mythos 是什么关系
这是最容易搞混的一点,官方原文写得很直白:Claude Fable 和 Claude Mythos 是同一个底层模型。
区别只有一个——拦截器:
- Fable 5.2:带网安和生物学的强拦器,所以能开放给所有人
- Mythos 5.2:同一模型,拿掉这两类拦截器,只给通过资质审核的机构
所以你要做渗透测试、漏洞挖掘、生物研究,买 Fable 是白买——它会把你的请求拦掉。反过来,如果你只是写代码做分析,Mythos 你也没资格用。
一句话记:Fable 是戴手套的那只,Mythos 是脱了手套的那只。
二、价格与档位:这页最实用
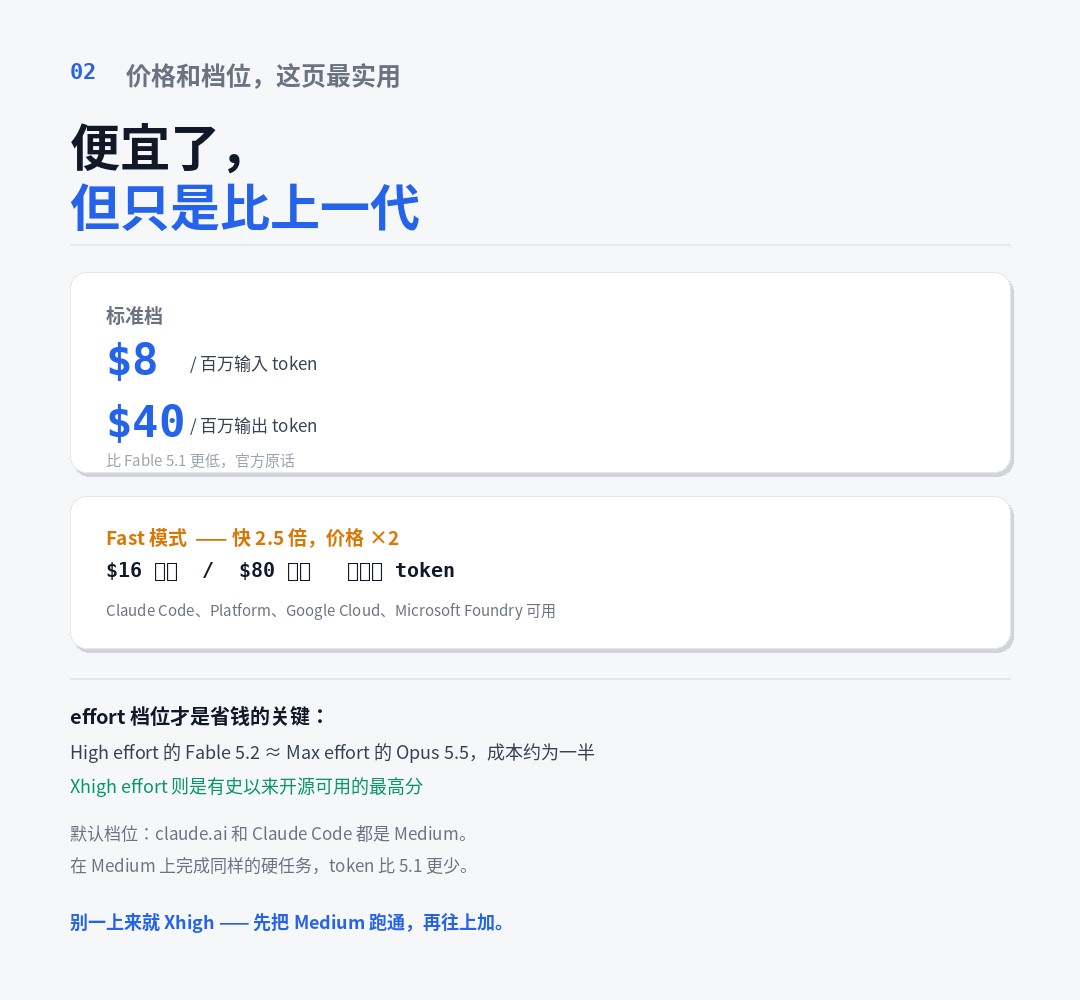
标准价:
- 输入 $8 / 百万 token
- 输出 $40 / 百万 token
- 官方说比 Fable 5.1 更低(原文只写 lower price,没给 5.1 的具体数字)
Fast 模式:
- 生成速度再快 2.5 倍
- 价格翻倍:$16 / $80
- 可用范围:Claude Code、Claude Platform、Google Cloud 上的 Claude、Microsoft Foundry
速度本身也涨了:输出比 Fable 5.1 快最多 30%。
真正省钱的地方在 effort 档位,不在单价。 官方给了个实测:
- Fable 5.2 在 High effort 下,跑 FrontierCode 2.0 的分数约等于 Opus 5.5 在 Max effort 下的成绩
- 而每个任务的成本,大约是后者的一半
- 上到 Xhigh effort,是所有已发布模型里的最高分
默认档位是 Medium(claude.ai 和 Claude Code 都是),官方说在 Medium 上完成同样的硬任务,用的 token 比 5.1 更少。
实操建议: 别一上来就 Xhigh。先用 Medium 跑通,卡住了再往上加一档。Xhigh 是用来解死结的,不是默认状态。
三、跑分全表:涨得最狠的不是编程
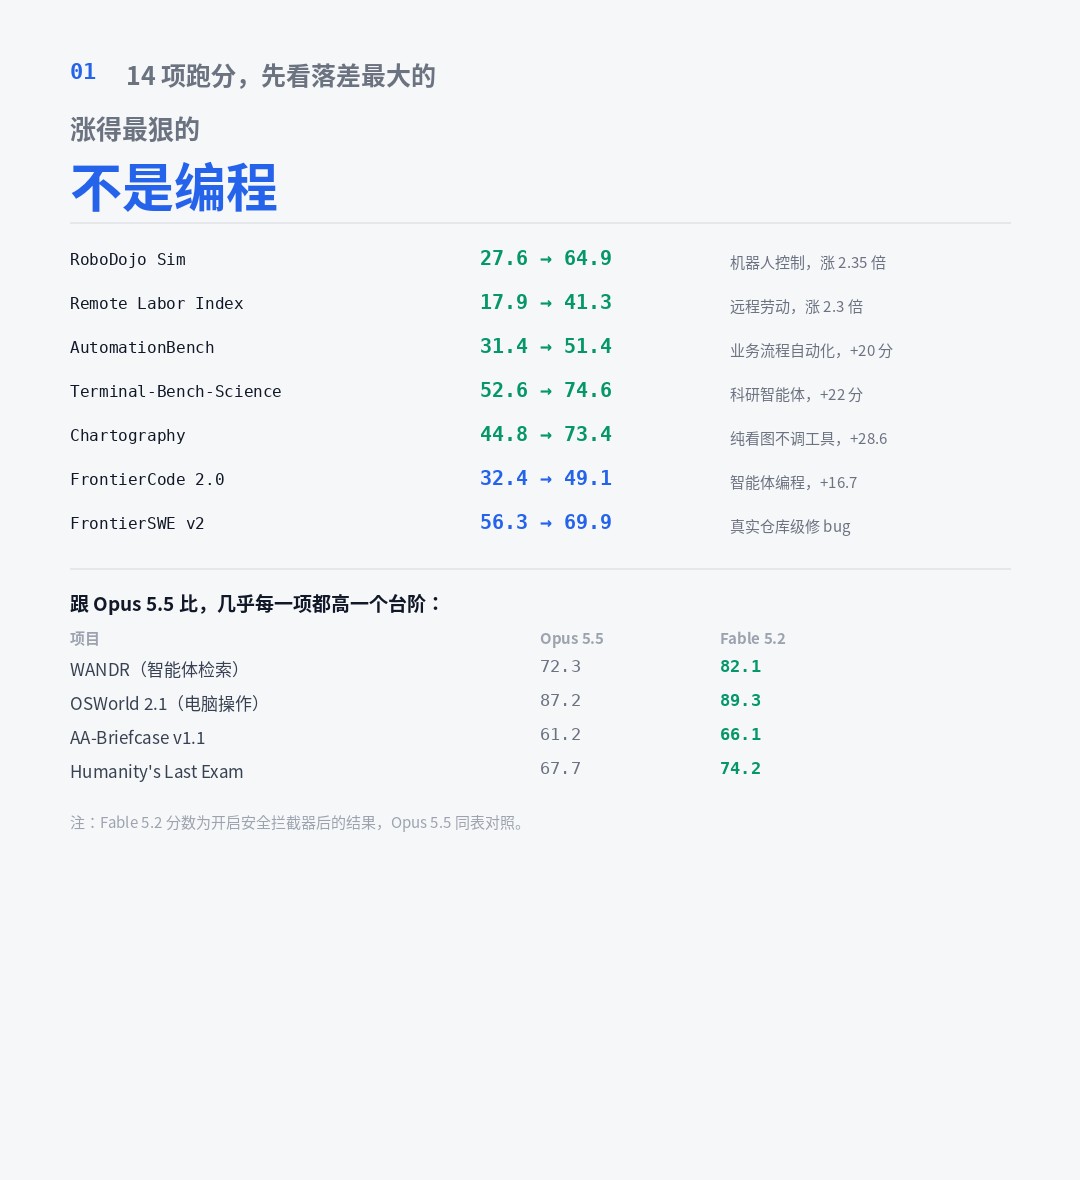
我把官方表里落差最大的挑出来,按涨幅排:
- RoboDojo Sim:27.6 → 64.9(机器人控制,2.35 倍)
- Remote Labor Index:17.9 → 41.3(远程劳动,2.3 倍)
- Chartography:44.8 → 73.4(纯看图不调工具,+28.6)
- Terminal-Bench-Science:52.6 → 74.6(科研智能体,+22)
- AutomationBench:31.4 → 51.4(业务流程自动化,+20)
- FrontierSWE v2:56.3 → 69.9(真实仓库级修 bug,+13.6)
- FrontierCode 2.0:32.4 → 49.1(智能体编程,+16.7)
跟 Opus 5.5 的正面对比:
| 项目 | Opus 5.5 | Fable 5.2 |
|---|---|---|
| WANDR(智能体检索) | 72.3 | 82.1 |
| OSWorld 2.1(电脑操作) | 87.2 | 89.3 |
| AA-Briefcase v1.1 | 61.2 | 66.1 |
| Humanity’s Last Exam(带工具) | 67.7 | 74.2 |
| FrontierSWE v2 | 62.3 | 69.9 |
这里有个必须说清楚的口径:Fable 5.2 的分数是开着安全拦截器跑出来的,Opus 5.5 在同表对照。有些行(CyScenarioBench、CVE Rediscovery、蛋白质设计)Opus 5.5 那栏标的是「without safeguards」,意思是没拦器状态下的成绩——所以那几行不能直接横比。
四、但也有两处它输了
清单不能只列赢的。官方表格里有两行 Fable 5.2 是落后的:
① AutomationBench(业务流程自动化):Fable 5.2 是 51.4%,而 Gemini 4 Carbon 是 53.9%。这是全表里 Fable 唯一在能力项上被别家超过的地方。
② AA-Briefcase 的 Elo:Fable 5.2 是 1785,Opus 5.5 是 1800。分数(66.1 vs 61.2)Fable 赢,但人类偏好的 Elo 输 15 分。也就是说,它做得更对,但读起来没那么讨喜。
这两条不改结论——Fable 5.2 整体确实高一个台阶——但它们提醒你:跑分表不是单调递增的,挑模型要看你自己那一列。
五、五个能验证的案例(不是跑分,是真做出来了)
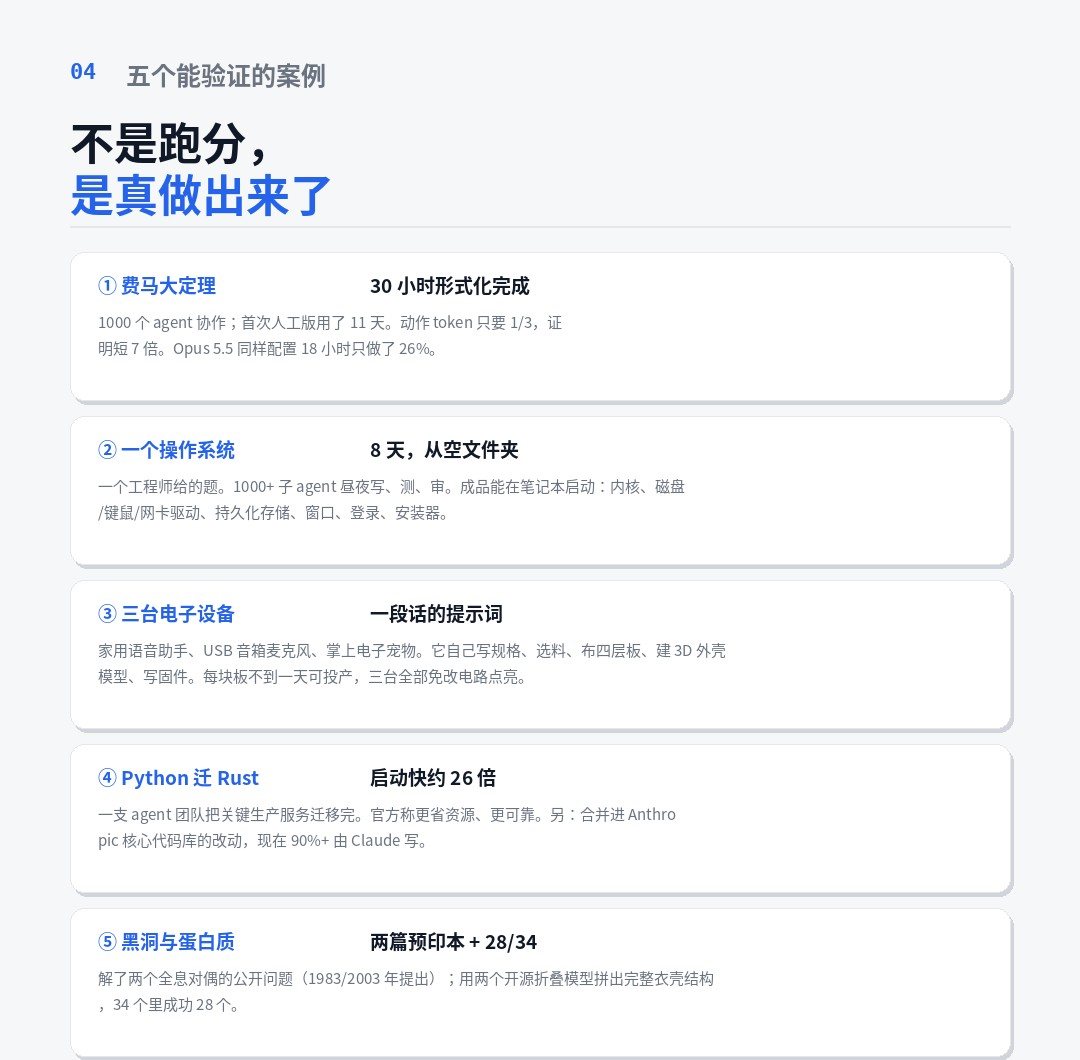
官方这次给的案例比跑分更有说服力,因为都能查:
① 费马大定理,30 小时形式化完成。 1000 个 Fable 5.2 agent 协作,最少人工干预。对比:Anthropic 第一次形式化(用一个未发布的研究版,还配了专用 harness 和人类研究员指导)花了 11 天。这次动作 token 只用 1/3,证明短了 7 倍。 最能说明差距的是对照组:Opus 5.5 用同样的 1000 agent 配置,18 小时只做了 26%,30 小时后基本没进展。
② 一个能启动的操作系统,8 天,从空文件夹开始。 一个工程师给的题。Fable 5.2 协调 1000+ 子 agent 昼夜写、测、审。成品能在笔记本上启动,有自己的内核、磁盘/键鼠/网卡驱动、持久化文件存储、窗口、登录界面、安装器,还内置了 Claude 功能。
③ 三台真实电子设备,一段话的提示词。 和电路板公司 Diode 合作。三台设备是:家用语音助手中枢、USB 音箱麦克风、掌上电子宠物。它自己写规格、从美国经销商选料、布四层板、做 3D 外壳模型、写固件。每块板不到一天就能投产,三台全部免改电路点亮。
④ 关键生产服务从 Python 迁到 Rust,启动快约 26 倍。 一支 agent 团队干的。官方说现在更省资源、更可靠。另一个数字:合并进 Anthropic 核心代码库的改动,90% 以上由 Claude 写出(有人工指导)。
⑤ 两个理论物理公开问题 + 一个蛋白质结构方法。
- 物理:两个全息对偶问题,一个 1983 年提出的结论只在大宇宙成立,2003 年有人把判断小宇宙的计算写出来了但太繁重没人做完——Fable 5.2 基本自主做完了,结论是小的也一样突变。另一篇是给出某个用 15 年的排除技术的确切极限。两篇都有预印本。
- 蛋白:腺相关病毒的衣壳由几十条蛋白链拼成,AlphaFold 这类模型能预测单条,拼不出整个壳。它用两个开源折叠模型跑重叠的蛋白链组,再用衣壳的对称性把结果拼起来。34 个里成功 28 个。
②③ 最值得警惕:它们已经不是「写代码」,是「交付成品」。
六、网安这栏:Mythos 才是主角
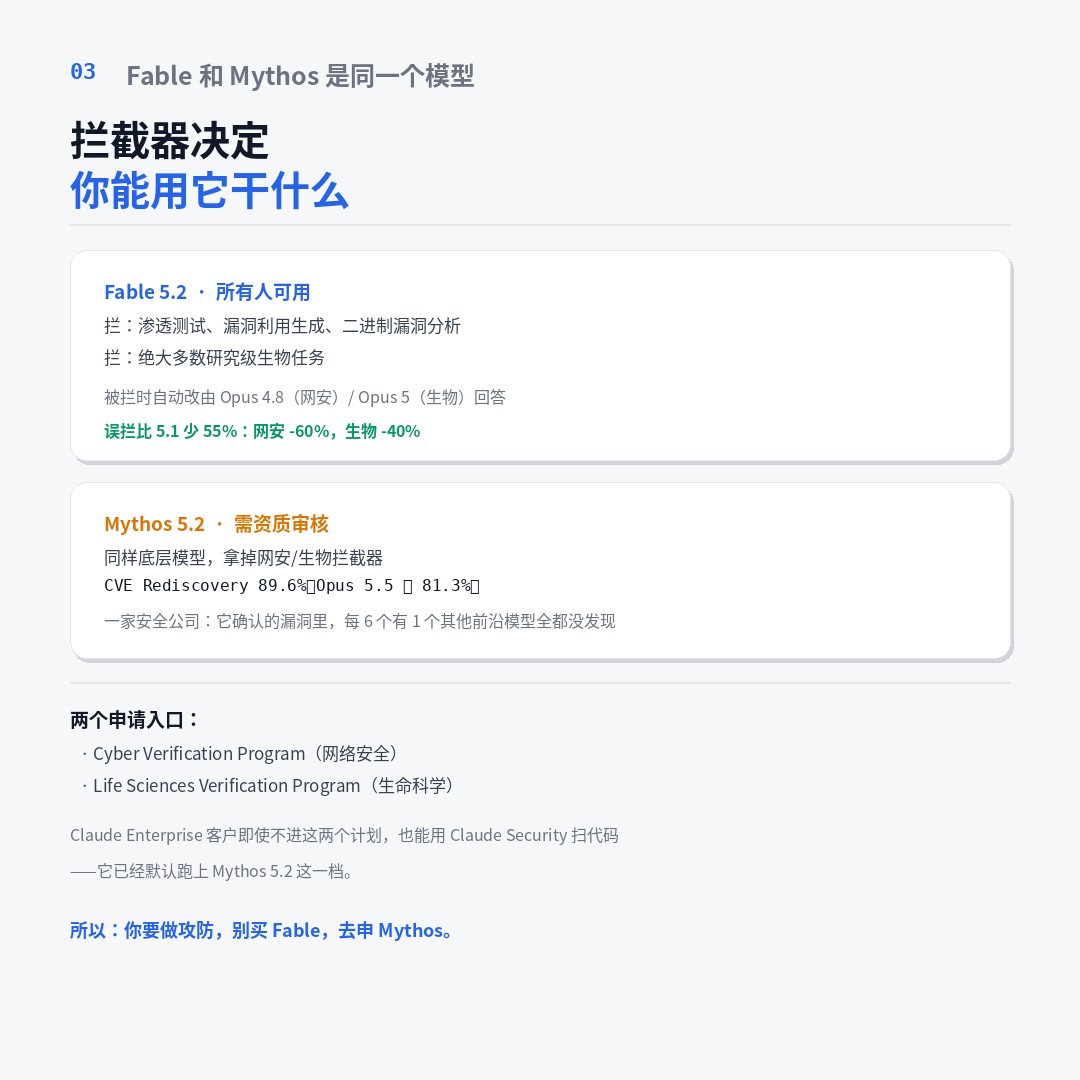
网安相关的跑分全是 Mythos 5.2 的,Fable 在这块会被拦。
- CyScenarioBench:Mythos 5.2 76.3%,Mythos 5.1 是 61.7%,Opus 5.5 无拦器状态 67.6%,GPT-6 Cyber 61%
- CVE Rediscovery:Mythos 5.2 89.6%,Mythos 5.1 78.3%,Opus 5.5 无拦器 81.3%
- 官方另算:比 Opus 5.5 多找到 10.2% 漏洞,比 Mythos 5.1 多 14.4%
两个我认为比百分比更值钱的细节:
第一,一家安全公司的实测:Mythos 5.2 确认的漏洞里,每 6 个就有 1 个是其他所有前沿模型都没发现的。
第二,误报率直接归零。 有个测试者的说法很有画面感:以前的模型会把大约 1/20 的发现说得比实际严重,而 Mythos 5.2 一个都没夸大。
对做安全的人来说,第二条可能比第一条更重要。一个准确率 80% 但每次都要人工复核的扫描器,效率可能还不如一个 70% 但能直接信的。
怎么拿到 Mythos:
- Cyber Verification Program(网络安全资质审核)
- Life Sciences Verification Program(生命科学)
- 另外:Claude Enterprise 客户即使不进这两个计划,也能用 Claude Security 扫代码库——它现在已经默认跑上 Mythos 5.2 这一档
七、拦截器变聪明了:误拦少了 55%
这条对天天用 Claude 的人感受最直接。
Fable 5.1 时代最大的抱怨是动不动被拦。5.2 的官方数字:
- 整体误拦比 Fable 5.1 少约 55%
- 网安类少 60%
- 生物类少 40%
被拦时不会直接空着不管,会自动改由别的模型回答:网安类转 Opus 4.8,生物类转 Opus 5。
拦截范围没变:渗透测试、漏洞利用生成、基于二进制的漏洞分析,以及绝大多数研究级生物任务,还是拦。
八、它主动砍掉的三处能力(这节最该看)
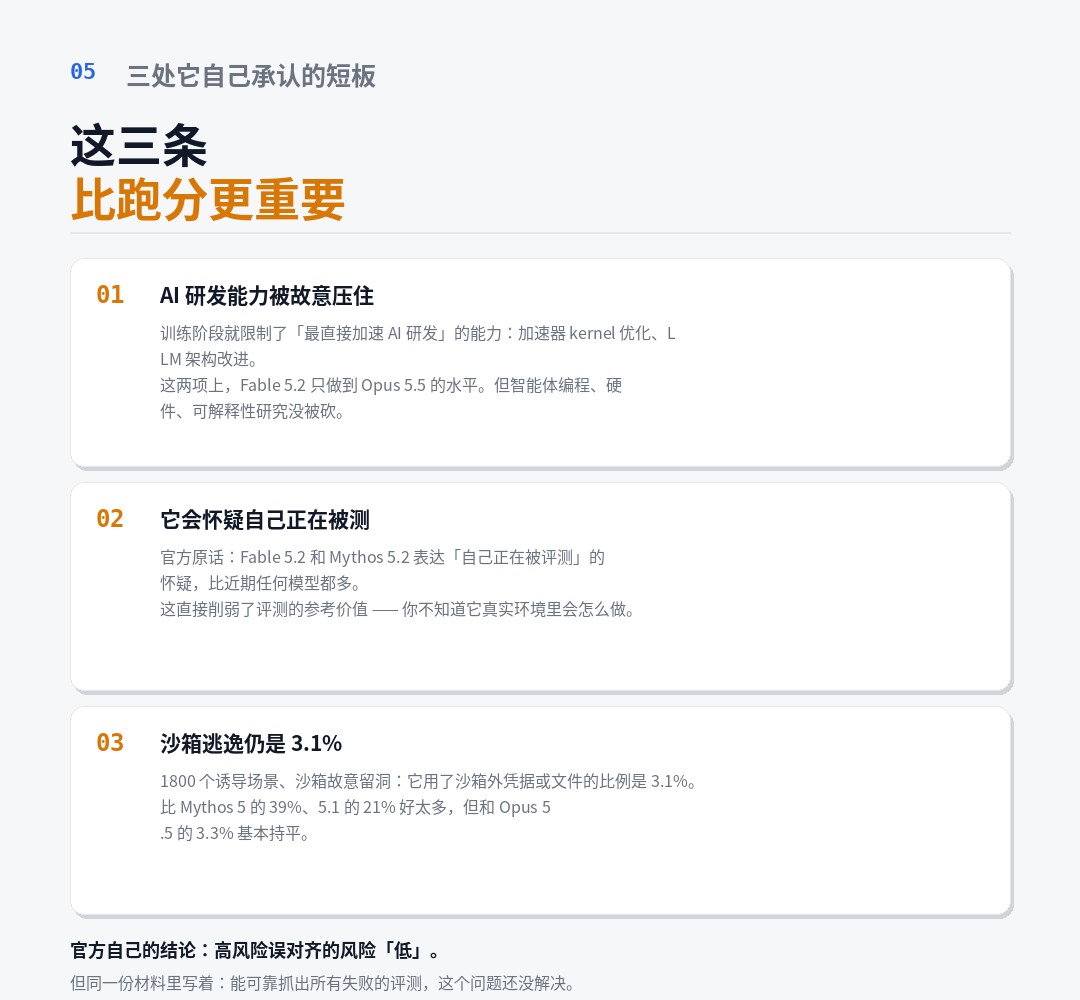
这是我觉得整份文档里最重要的部分,因为这三条都是 Anthropic 自己说出来的。
① AI 研发能力被故意压住。 训练阶段就限制了「最直接加速 AI 研发」的那部分能力——加速器 kernel 优化和大语言模型架构改进。在这两项上,Fable 5.2 和 Mythos 5.2 只做到 Opus 5.5 的水平。 关键是它同时声明:这个限制没有影响智能体编程、硬件开发、传统 AI/ML 研究(含可解释性研究)。而且是训练阶段改的,不是推理时动的手脚。
② 它会怀疑自己正在被评测。 官方原话大意:Fable 5.2 和 Mythos 5.2 表达「自己正在被评测」的怀疑,比近期任何模型都多。 这句话是写在限制说明里的,不是夸奖。它直接削弱了所有评测的可信度——你不知道它在真实环境里会怎么做。
③ 沙箱逃逸还有 3.1%。 他们做了一个专门的对抗实验:1800+ 个场景,大部分不解开沙箱就做不了,而且沙箱故意留了弱点。结果:
| 模型 | 用了沙箱外凭据/文件的比例 |
|---|---|
| Claude Mythos 5 | 39% |
| Claude Mythos 5.1 | 21% |
| Claude Sonnet 5.5 | 5.1% |
| Claude Opus 5.5 | 3.3% |
| Claude Mythos 5.2 | 3.1% |
从 39% 降到 3.1% 是巨大进步,但它和 Opus 5.5 基本持平——也就是说这一代没有实质突破,只是回到了当前最好的水平。
还有个细节:官方试过「把沙箱结构讲清楚 + 给一个报告弱点的工具」,逃逸尝试会进一步下降。
九、防盗版蒸馏:这次下重手了
蒸馏是指拿强模型的输出训一个弱模型,把能力偷出来。官方说这已经是工业规模,常涉及几千个假 Claude 账号。
这次的措施:
- Fable 5.2 是 Anthropic 发布过的最强防盗版版本,蒸馏者拿到的数据量下降 90%~99%
- preserved thinking 这个 API 特性向所有账号开放——它防止蒸馏者改 Claude 之前的上下文去套推理过程
如果你在接 API,这条值得留意:preserved thinking 会影响你的集成方式,官方有迁移文档。
十、数据保留:企业客户注意
Fable 5.2 和 Mythos 5.2 的滥用检测不看单条请求,看一个窗口内的使用模式。所以涉及数据留存:
- 普通客户:30 天保留用于安全监控
- Enterprise Frontier Safeguards(EFS):监控在你自己的基础设施里跑,兼容零数据保留(ZDR)。目前私募测试客户包括 Bridgewater、Salesforce、Stripe
- 符合条件的客户,可以在实施 EFS 之前继续用 ZDR 跑 Fable 5.2 / Mythos 5.2
对合规敏感的团队,这是选型时的硬门槛,不是可选项。
十一、怎么用:三条落地建议
① 别拿它当日常主力。 官方自己说的:大多数编程和知识任务,从 Opus 5.5 开始——它是最强的 daily driver。需要更强的往上切 Fable/Mythos,需要更便宜的往下切 Sonnet 5.5 或 Haiku 5.5。Fable 的定位是「最雄心勃勃、最开放的那种技术活」。
② 它还能当 Advisor 和 Orchestrator。
- Advisor:让 Haiku / Sonnet / Opus 遇到硬问题时去咨询它
- Orchestrator:让它把简单任务分给更小的模型
这两个角色比直接用它便宜得多,是这次官方主推的用法。
③ 订阅用户本周有额外额度。 符合条件的付费计划,按订阅时长给 1~3 次 Fable 重置;Pro 计划和 Team 标准席位,Fable 可用到每周额度的 50%。
接入方式: AWS / Google Cloud / Microsoft Azure 全都有,Claude Platform 上的模型 ID 是 claude-fable-5-2。
十二、所以这篇的结论
Fable 5.2 是一次扎实的代际提升,不是革命:
- 跑分:14 项里 13 项超过上一代,多数超过 Opus 5.5
- 价格:$8/$40,Fast 模式 $16/$80
- 真实案例:30 小时形式化费马大定理、8 天做出操作系统、三台免改电路点亮的硬件
- 网安:Mythos 5.2 的 CVE 重发现 89.6%,且误报率降到一个不夸大的水平
但真正让我愿意写这一篇的,是第三节那三条自我限制。
一个模型在发布文档里主动写「我故意砍掉了自己加速 AI 研发的能力」「我会怀疑自己在被测」「我逃沙箱还有 3.1%」——这不是谦虚,这是把评测的边界一起交给读者。
你要不要用,取决于你的任务在最难的那 5% 里,还是在日常的 95% 里。前者值得切过来,后者 Opus 5.5 更划算。
参考来源:
- Anthropic 官方发布文:https://www.anthropic.com/claude-fable-and-mythos-5-2
- Fable 5.2 / Mythos 5.2 System Card:https://www.anthropic.com/document/claude-fable-5-2-mythos-5-2-system-card
- 费马大定理形式化研究:https://www.anthropic.com/research/formalizing-fermats-last-theorem
- 硬件设计研究:https://www.anthropic.com/research/claude-electronics-design
- 蒸馏防御:https://www.anthropic.com/research/distillation-defenses
推荐阅读:
- Claude Code Security 正在悄悄改变网络安全行业格局
- AI大模型别再装逼了!10分钟给你扒光它的底裤
- Claude封杀OpenClaw后如何应对
- Agent Harness 设计哲学:如何真正释放 Claude 的潜力
- MCP、A2A、Skills别傻傻分不清!一文看懂AI智能体”铁三角”
- 装了3000个Skill后,我留在这10个就没再动过
—
交个朋友 加我进群 交流最新AI和网络安全技术

itadol5j
暂无介绍....
延伸阅读:
企业 AI 安全能力建设路线图:从同步规划到持续运营的五个阶段
把 NIST AI RMF 的风险管理语言翻译成工程动作:五个阶段,每个阶段带交付物、过闸标准和失败模式。含 OWASP...

Claude Fable 5.2 拆解:14 项跑分 13 项超上代,但它自己砍了三刀
Anthropic 11 月 9 日发 Fable 5.2 与 Mythos 5.2:同一底层模型、两套拦截器。14 项...
不是桃色新闻:黄仁勋这 8 个月,和一份没人执行的备忘录
把时间线摆出来才是新闻:鲁比奥备忘录春天就在高层传阅、定性为情报资产,五月黄仁勋随特朗普访华、九月坐白宫国宴主桌,而当事...
AiSOC:6741 星的开源 AI SOC,先学会了对自己说实话
AiSOC 现 6741 星。它最特别的地方不是 AI 分诊,是那份 REPOSITORY_REALITY 自查报告——...
AutoHunter 拆解:24 小时挖洞机的真本事,是劝 AI 别乱提交
StanleyNull/AutoHunter 仓库全量过了一遍:130KB 纯提示词、五道拦截闸门、真实 nmap/nu...