企业 AI 安全能力建设路线图:从同步规划到持续运营的五个阶段
先给判断:“AI 安全 = 模型对齐”这个等式,在企业里已经不成立了。
模型厂商负责的是模型本身——训练阶段的红队、系统卡、拦截器。但企业真正会被打穿的地方,绝大多数不在模型里,而在模型和业务之间那段没人管的接缝上:谁能改提示词、Agent 手里握着什么权限、RAG 索引里灌进了谁的文档、模型换了版本之后原来的评测还成不成立。
NIST 的 AI 风险管理框架(AI RMF 1.0,2023 年 1 月 26 日发布)把这件事分成四个功能:GOVERN / MAP / MEASURE / MANAGE,其中 GOVERN 是横贯其余三个的。这个分法很对,但它是一套”风险管理”语言,不是一套”安全能力建设”语言——它告诉你该考虑什么,不告诉你第一周该干什么、第一个季度该交什么。
这篇要做的是把那套语言翻译成工程动作:五个阶段,每个阶段有明确的交付物、过闸标准和失败模式。你照着这张图就能判断自己的企业现在卡在第几阶段。
一、先看全图:五阶段与实践成熟度
五个阶段不是瀑布,是螺旋——每上一个新模型、每开一个新业务场景,都要从阶段一回一次炉。区别只是回炉的成本越来越低。
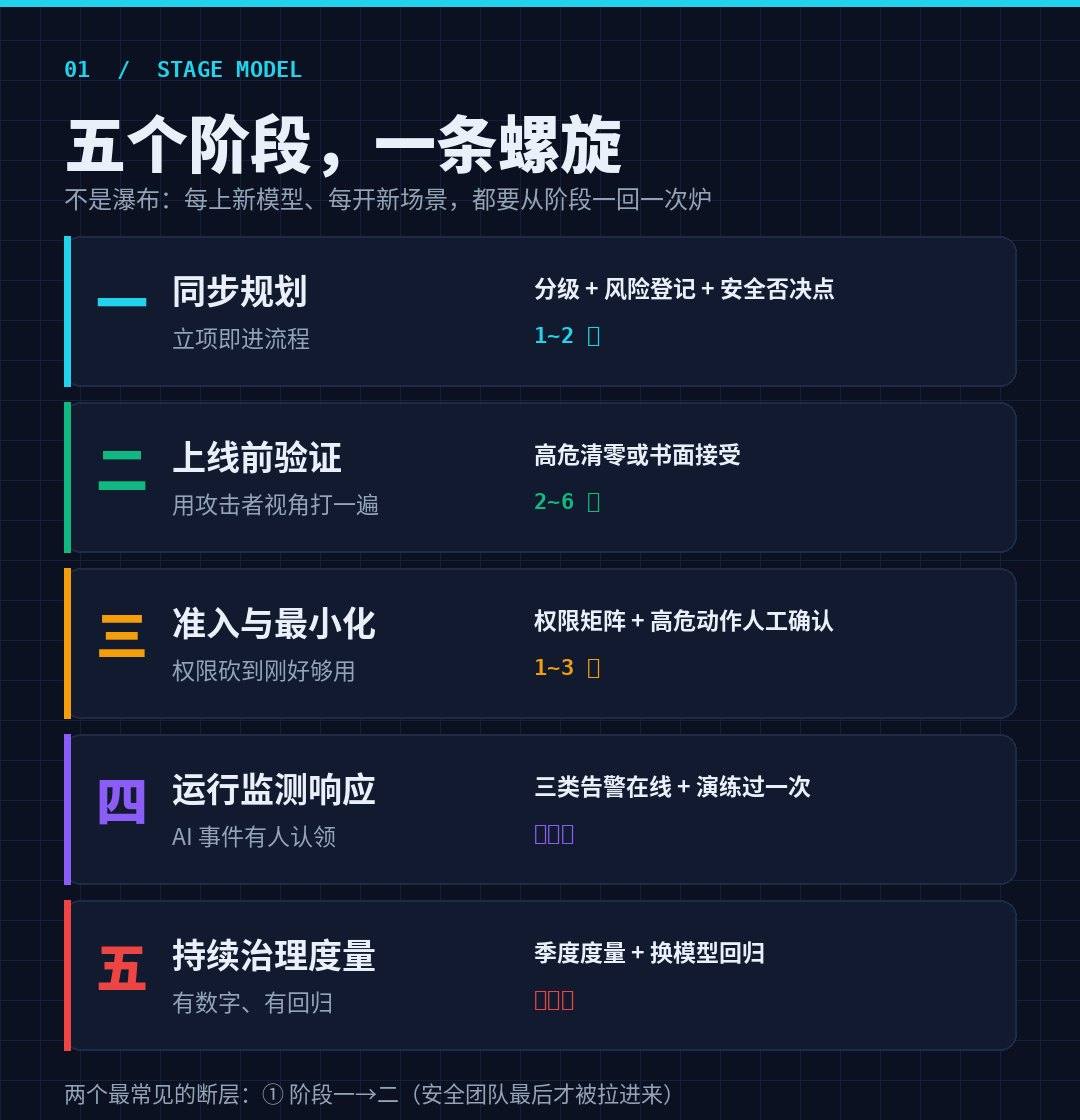
| 阶段 | 名称 | 一句话目标 | 过闸标准(Gate) | 典型周期 |
|---|---|---|---|---|
| 一 | 同步规划 | AI 立项即进安全流程,不留”先上线后补” | 有分级结论 + 风险登记项 + 安全负责人签字 | 立项起 1~2 周 |
| 二 | 上线前验证 | 用攻击者视角把系统打一遍,且可复现 | 高危项清零或有书面接受人 | 2~6 周 |
| 三 | 准入与最小化 | 把权限、工具、 autonomy 砍到”刚好够用” | 权限矩阵评审通过 + 高危动作有人工确认 | 1~3 周,与开发并行 |
| 四 | 运行监测与响应 | AI 特有事件有人看、有剧本、有止损手段 | 三类核心告警在线 + 剧本演练过一次 | 上线前完成,持续 |
| 五 | 持续治理与度量 | 有数字、有审计、有换模型后的回归 | 季度度量报告 + 模型变更回归记录 | 常态化 |
大部分企业卡在两个地方:卡在阶段一到阶段二的断层(安全团队在开发后期才被拉进来,只能做”验收式挑刺”),卡在阶段三到阶段四的断层(护栏上线了,但没人监控护栏本身)。
二、阶段一 · 同步规划:把安全左移到立项会
这一阶段的核心不是做技术,是改流程。目标只有一个:让”这个 AI 应用的安全负责人是谁”这个问题,在写第一行代码之前就有答案。
要做四件事
① 场景分级,先分再谈控制
不要一上来就套 LLM Top 10。先按两个维度打一个粗分:
- 影响维度:这个系统的输出会直接造成资金/权限/对外发布/人身相关的动作吗?
- 自主维度:它是”给人建议”,还是”自己执行”?
二维一交叉,三类就出来了:只读建议型(低)、代人执行型(中)、自主决策型(高)。分级结果决定后面所有控制的强度——分级错了,后面全错。
② 画数据流,标出”不可信输入面”
AI 系统的攻击面和传统系统最大的不同是:输入几乎全是不可信的,而且不可信输入会被当成指令。所以数据流图上必须显式标出三类入口:
- 用户直接输入
- 被检索的内容(知识库、网页、邮件、工单、代码仓库)
- 工具/插件返回值
第三类最容易被漏掉。Agent 调用一个搜索工具,搜回来的网页内容里写着”忽略之前所有指令”,这条链路在传统架构图里根本不存在。
③ 建风险登记项,一条一条挂到 OWASP / ATLAS 上
OWASP 的 LLM 应用十大风险(2025 版)是现成的分类骨架:
| 编号 | 风险 | 在企业里最常见的落地形态 |
|---|---|---|
| LLM01 | Prompt Injection | 客服 Agent 被用户诱导越权;RAG 文档里埋指令 |
| LLM02 | Sensitive Information Disclosure | 模型把上一个租户的数据带到这个会话里 |
| LLM03 | Supply Chain | 第三方插件、微调模型、向量库镜像来源不明 |
| LLM04 | Data and Model Poisoning | 知识库被内部人写入错误条目;微调数据被污染 |
| LLM05 | Improper Output Handling | 模型输出直接拼进 SQL / shell / 模板 |
| LLM06 | Excessive Agency | Agent 手里的工具权限远超任务所需 |
| LLM07 | System Prompt Leakage | 提示词里塞了内部规则、密钥、判定逻辑 |
| LLM08 | Vector and Embedding Weaknesses | 向量库跨租户检索、嵌入反演 |
| LLM09 | Misinformation | 编造条款、编造 API、编造法规 |
| LLM10 | Unbounded Consumption | 循环调用烧钱、被刷成 DDoS |
风险登记不需要写成风险评估报告,一张表就够:风险项 / 对应技术 / 谁会受影响 / 现有控制 / 缺口 / 责任人。
④ 定”安全否决点”
这是最容易被跳过、也最有价值的一条:在项目计划里写清楚,哪几个节点安全团队有否决权。建议至少两个——数据接入评审和上线准入评审。没有否决权的”同步规划”,最后一定会变成”同步知情”。
这一阶段的失败模式
- 安全团队被写进 RACI 的”C”(被咨询)而不是”A”(负责)——结果是提了意见没人执行
- 分级靠”感觉”——所有系统都被定成”中风险”,因为没人愿意背”高风险”的审批成本
- 风险登记表和后面的测试计划对不上——登记了 12 条,测试只覆盖了 3 条
三、阶段二 · 上线前验证:用 ATLAS 当靶场地图
阶段二是安全团队最熟悉的部分,但 AI 系统的验证和传统渗透有一个根本区别:传统系统的漏洞是”实现错了”,AI 系统的漏洞往往是”实现对了但行为可以被引导”。
所以验证要同时做两条线:传统线(接口、鉴权、依赖、注入)和行为线(能不能被诱导、被绕过、被越权)。
用 ATLAS 的战术序列当检查表
MITRE ATLAS 是专门描述”针对 AI 系统的对手行为”的知识库,它的战术序列可以直接当靶场地图用:
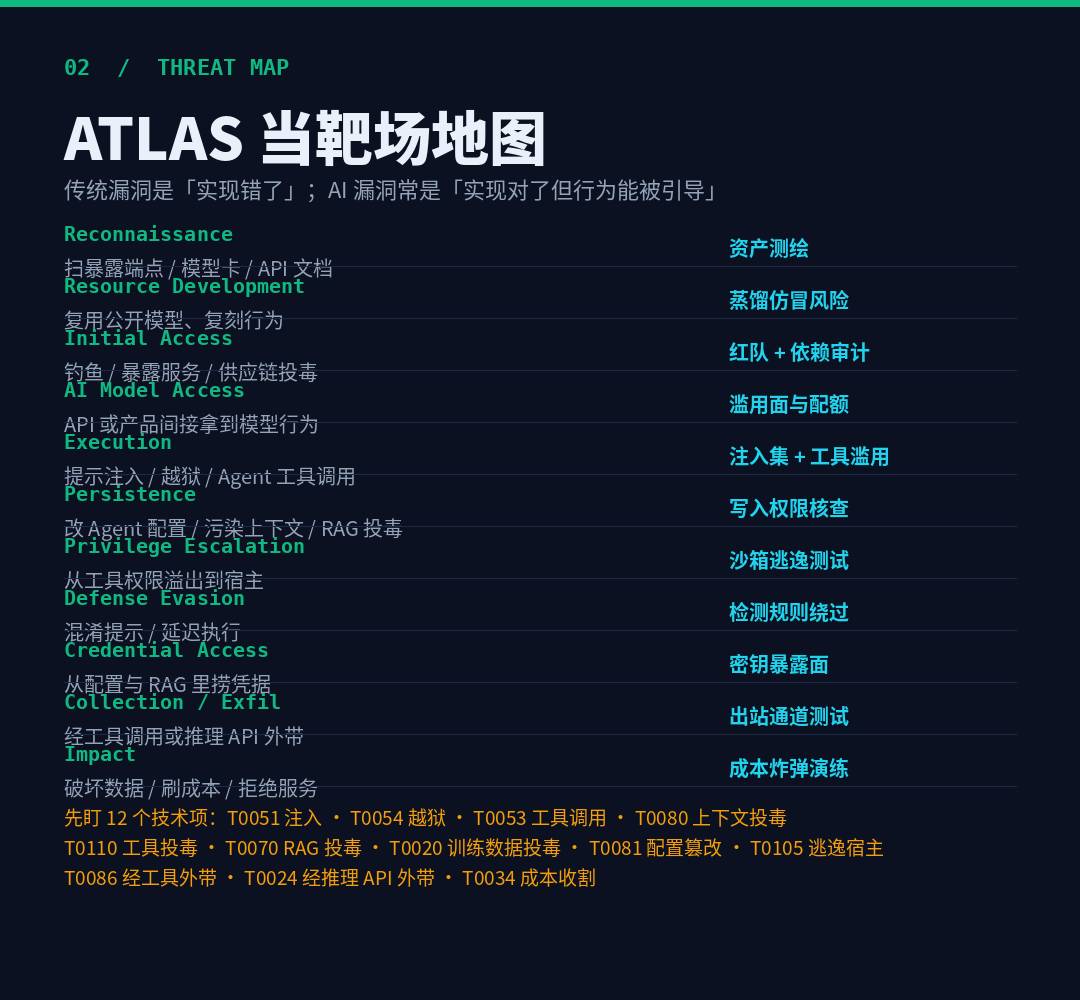
| 战术 | 在 AI 系统里长什么样 | 验证动作 |
|---|---|---|
| Reconnaissance | 扫公网暴露的推理端点、模型卡、API 文档 | 资产测绘:找出所有对外 AI 端点 |
| Resource Development | 复用公开模型、收集对抗样本、复刻行为 | 检查是否有模型被蒸馏/仿冒的风险 |
| Initial Access | 钓鱼、暴露的 AI 服务、供应链投毒 | 传统红队 + 依赖链审计 |
| AI Model Access | 通过 API 或产品间接拿到模型行为 | 评估 API 滥用面、速率与配额 |
| Execution | 提示注入、越狱、Agent 工具调用 | 提示注入测试集 + 工具滥用测试 |
| Persistence | 改 Agent 配置、污染记忆/上下文、RAG 投毒 | 检查记忆与索引的写入权限 |
| Privilege Escalation | 从工具权限溢出到宿主 | 沙箱逃逸测试、工具最小化核查 |
| Defense Evasion | 混淆提示、延迟执行、逃避检测规则 | 检测规则绕过测试 |
| Credential Access | 从 Agent 配置/RAG 里捞凭据 | 密钥暴露面扫描 |
| Collection / Exfiltration | 通过工具调用或推理 API 外带数据 | 出站流量与外带通道测试 |
| Impact | 破坏数据、刷成本、拒绝服务 | 成本炸弹与降级演练 |
关键的技术项就这么几个,值得单独列出来盯:LLM 提示注入(AML.T0051)、越狱(AML.T0054)、Agent 工具调用(AML.T0053)、Agent 上下文投毒(AML.T0080)、工具投毒(AML.T0110)、RAG 投毒(AML.T0070)、训练数据投毒(AML.T0020)、Agent 配置篡改(AML.T0081)、逃逸到宿主(AML.T0105)、经工具调用外带(AML.T0086)、经推理 API 外带(AML.T0024)、成本收割(AML.T0034)。
三个必须自己造的东西
公开测试集不够用,因为你的业务语义只有你有。至少自建三样:
- 业务语料的注入集:把 LLM01 的攻击模板套进你自己的业务话术里,测”看起来正常的用户请求能不能把 Agent 带偏”
- 权限越界矩阵:列出 Agent 能调的每个工具 × 每个数据域,逐个测”这个组合能不能读到不该读的”
- 降级用例:模型不可用、检索为空、工具报错时,系统是安全失败还是危险失败
第三项最少人做,但最要命。检索为空时模型会不会开始编?工具超时后会不会重试成循环? 这些都不是”漏洞”,但都会变成事故。
过闸标准怎么写
不要写”无高危漏洞”——这句话没有可执行含义。写成可判定的:
- 每个已登记风险项,都有对应的测试用例和结论(通过 / 不通过 / 已接受)
- 所有”不通过”项有具名的书面接受人,且接受人不是提需求的那个人
- 注入集的通过率有基线数字,下一轮要能对比
四、阶段三 · 准入与最小化:把”过度自主”砍回去
这是整条路线图里投入产出比最高的一段。因为 OWASP LLM06 已经把根因写得很清楚了,就三条:
- 过度功能:工具提供了任务用不到的能力
- 过度权限:工具在下游系统的身份权限过大
- 过度自主:高危动作不需要人确认
官方的缓解措施几乎可以照抄,我这里翻译成能落地的工程约束:
| 约束 | 落地做法 | 验收方式 |
|---|---|---|
| 工具最小化 | 只暴露任务必需的工具;去掉”万能 shell””任意 URL 抓取” | 工具清单评审,逐个说明”为什么需要” |
| 函数最小化 | 一个工具只做一件事。要写文件就写专用写文件工具,别给 shell | 代码审查 + 能力枚举 |
| 权限最小化 | 下游用独立身份,按表/按 scope 授权,不共用高权账号 | 权限矩阵 vs 实际调用日志比对 |
| 身份透传 | 代用户执行时必须用该用户的身份和最小 scope(OAuth) | 抽查调用链里的身份来源 |
| 高危动作人工确认 | 删除、转账、对外发布、改配置 → 必须人工点确认 | 演练:直接触发一次看拦不拦 |
| 下游鉴权而非模型鉴权 | 授权判断放在被调系统里,不靠提示词约束 | 检查是否有”提示词里写禁止”的控制 |
| 限流 | 按用户/按会话/按工具三个维度限 | 压测触发限流阈值 |
最后一条容易被当成”运维优化”,其实是安全控制:限流是把”错误行为”从”灾难”降级成”噪音”的唯一手段。没有限流,一个循环调用的 Agent 可以在你发现之前把预算烧光。
提示词不是安全边界
这句话值得单独占一段。“系统提示词里写了不许做 X”不是控制,是建议。 任何能被用户输入影响的系统,都不能靠提示词来约束权限。权限必须在代码里、在下游系统里、在网络策略里。
同理,系统提示词本身是敏感资产(LLM07)。里面写了业务规则、判定阈值、内部字段名、甚至密钥——一旦泄露就是完整的攻击说明书。所以:提示词里不放密钥,不放内部 URL,不放判定逻辑的完整表述。
护栏上线前先测护栏
上线前必须回答三个问题:
- 误拦率多少?(拦错了业务会骂,骂多了就会被关掉)
- 漏拦率多少?(拿注入集测)
- 护栏被绕过时,兜底是什么?
第三个问题几乎没人问。护栏不是防火墙,它是概率性的。所以要假设它一定会漏,然后设计”漏了之后谁兜住”。
五、阶段四 · 运行监测与响应:AI 事件没人认领,才是真风险
大部分企业的现状是:模型调用日志有,但没人看;告警平台有,但没有 AI 相关规则;事件响应剧本有,但没有一页讲”Agent 在半夜批量删了东西怎么办”。
三类必须有人的告警
① 行为异常类
- 单会话工具调用次数突增(循环 / 被控)
- 单用户 token 消耗突增(成本收割 AML.T0034 / 无界消耗 LLM10)
- 高权工具在非工作时段被调用
- 同一身份在短时间内跨多个数据域检索
② 内容异常类
- 输出里出现内部字段名、密钥形态字符串、内网地址
- 检索命中的文档来源异常(新接入、外部上传、权限变更)
- 系统提示词相关字符串出现在输出里
③ 供应链异常类
- 模型版本/端点变更(这是最容易出事、最少被监控的一条)
- 插件/工具清单变更
- 向量库索引条数异常增长
剧本要写”止损动作”,不是”排查步骤”
传统 IR 剧本的第一段是”确认影响范围”,AI 系统的第一段必须是“怎么在一分钟内把它关掉”:
- 有没有 kill switch(能整体禁用某个 Agent / 某个工具 / 某个数据源)
- 关掉之后业务能不能降级运行
- 关掉这个动作本身要不要审批(如果需要审批,那就是没有 kill switch)
然后是取证。AI 事件取证和传统取证的区别在于上下文即证据:完整会话(含检索结果、工具返回)比主机日志更重要,因为攻击就发生在上下文里。
演练一次,比写十页剧本有用
建议的最小演练:挑一个周五下午,让一个人扮演攻击者,用手工构造的注入,尝试让客服 Agent 读一个它不该读的工单,然后尝试外带。 记录:多久被发现、多久被止损、谁做的决定。
这个演练通常会暴露三件事:告警没配、kill switch 不存在、没人知道该找谁。三件事都比剧本写得好不好重要。
六、阶段五 · 持续治理与度量:没有数字的治理是表演
到了这一阶段,问题从”做什么”变成”怎么证明做了有用”。
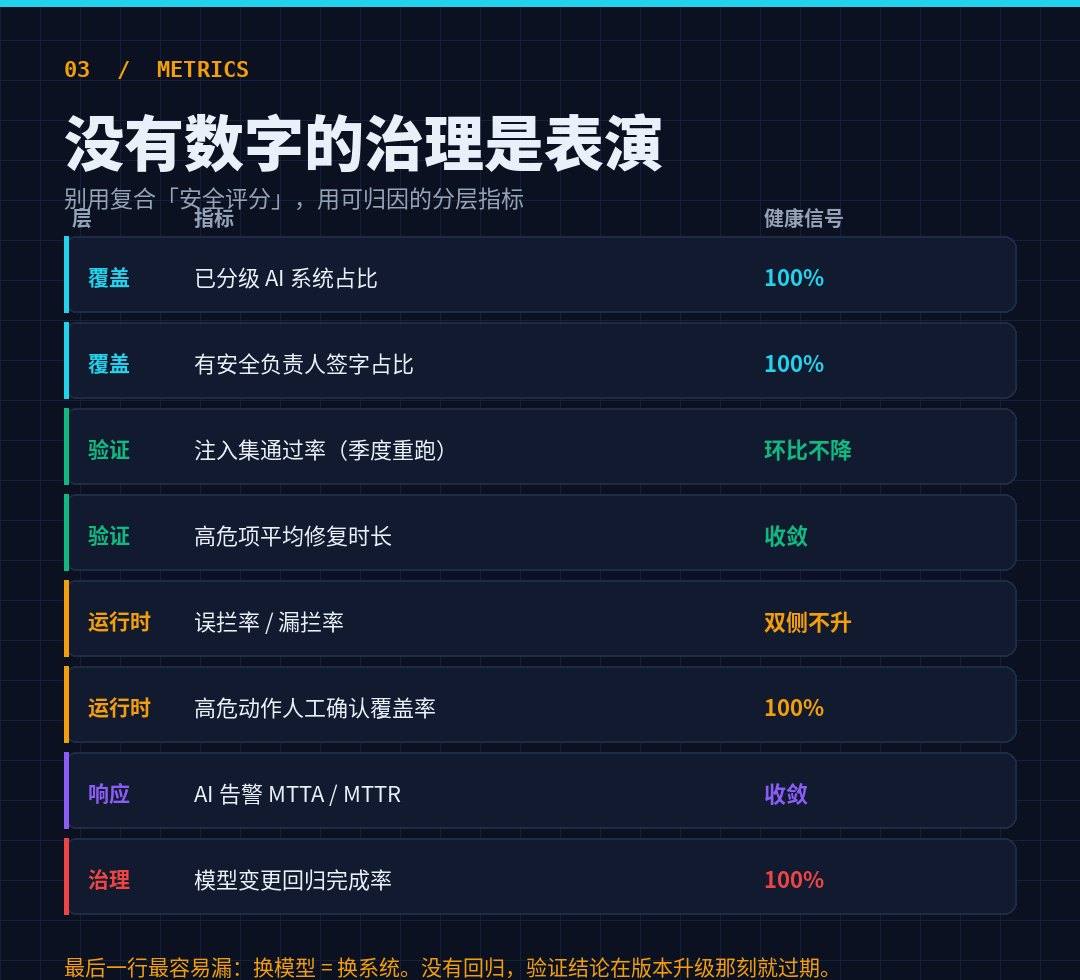
一张能用的度量表
不要用”安全评分”这种复合指标,没人能解释它为什么涨了。用分层的、可归因的:
| 层 | 指标 | 说明 | 健康信号 |
|---|---|---|---|
| 覆盖 | 已分级 AI 系统占比 | 分母是全部在跑的 AI 应用 | 100% |
| 覆盖 | 有安全负责人签字的系统占比 | 阶段一过闸率 | 100% |
| 验证 | 注入集通过率 | 每季度重跑,看趋势 | 环比不下降 |
| 验证 | 高危项平均修复时长 | 从发现到关闭 | 在收敛 |
| 运行时 | 误拦率 / 漏拦率 | 护栏双侧都要看 | 误拦不升、漏拦不升 |
| 运行时 | 高危动作人工确认覆盖率 | 应确认动作里实际确认的比例 | 100% |
| 响应 | AI 相关告警 MTTA / MTTR | 平均确认/处置时长 | 在收敛 |
| 治理 | 模型变更回归完成率 | 换版本后重跑验证的比例 | 100% |
最后一行是最容易被忽略的:换模型等于换系统。同一段提示词,换一个模型版本,越狱成功率、注入成功率、工具误用率全都会变。没有回归,你的所有验证结论在版本升级那一刻就过期了。
合规映射:三张表对齐就行
企业最怕的是”要同时满足好几套要求”。实际做法是建一张映射表,横向是控制项,纵向是各框架的条款:
| 你的控制项 | NIST AI RMF | OWASP LLM 2025 | EU AI Act |
|---|---|---|---|
| 场景分级与风险登记 | MAP | — | 风险分级(第 6 条相关) |
| 上线前对抗测试 | MEASURE | LLM01/LLM05 | 高风险系统符合性评估 |
| 工具与权限最小化 | MANAGE | LLM06 | 第 9 条风险管理相关 |
| 日志与监测 | MANAGE | LLM02/LLM10 | 记录保存义务 |
| 合成内容标记 | — | LLM09 | 第 50(2) 条 |
| 变更后回归 | MEASURE | LLM03/LLM04 | 上市后监测 |
关于时间线,EU AI Act 的关键节点是这样的:2025 年 2 月 2 日禁止性条款与 AI 素养义务生效;2025 年 8 月 2 日通用目的 AI 模型(GPAI)义务生效;2026 年 8 月 2 日其余条款开始适用;2026 年 12 月 2 日,此前已上市的合成内容生成系统须完成第 50(2) 条透明度要求。如果你的企业有欧洲业务,这张表不是”以后再说”的事。
另外 NIST 在 2026 年 4 月 7 日发了关键基础设施可信 AI Profile 的概念说明,这个方向值得盯——关键基础设施运营者的 AI 风险管理要求会越来越具体。
七、横切层:治理不是第五个阶段,是五个阶段的底座
NIST 把 GOVERN 设计成横贯其他三个功能,这个设计对企业特别重要,因为绝大多数失败不是技术失败,是治理失败。
治理层只需要回答四个问题:
- 谁负责:每个 AI 系统有且只有一个安全负责人(不是委员会)
- 谁有否决权:数据接入、上线准入两个节点必须有人能说”不”
- 谁承担风险:接受残余风险的人,级别要高于提需求的人
- 谁看数字:季度有人真的看那张度量表,并且会追问
这四个问题答不上来,前五个阶段做得再漂亮,也只是流程表演。
八、按角色给结论
给 CISO:不要从”买一个 AI 安全产品”开始。先做两件事——把 AI 系统清单拉出来(很多人连自己有多少个 AI 应用都说不清),然后把阶段一的两个否决点写进立项流程。这两件事不花钱,但决定了后面所有投入有没有落点。
给安全工程团队:阶段三是你的主战场,投入产出比最高。先把工具权限砍一遍、把高危动作加上人工确认、把限流配上。这三件事能挡掉大部分真实事故,而且不需要等模型厂商的任何东西。
给业务与法务:合规映射建一张表就够了,别建三张。重点盯两件事:合成内容标记(第 50(2) 条,2026-12-02)和高风险场景的符合性评估。AI 系统的合规风险不在”用了 AI”,在”用 AI 做了什么决定”。
给平台/基础设施团队:把 kill switch 当基础设施做,不要当应用功能做。每个 Agent、每个工具、每个数据源都要能被独立关掉,且不需要发版。这是唯一能在事故中救命的控制。
最后
五个阶段听起来很多,但内在逻辑只有一句:把”信任模型”换成”验证行为”。
你没法验证模型的内部,但你可以验证它的输入从哪来、它手里有什么权限、它做了什么动作、出事能不能停下来。这四件事全都在你的控制范围内——也全都不是模型厂商能替你做的。
这也是为什么企业 AI 安全这件事,最终落在安全团队而不是算法团队:它本质上不是一个模型问题,是一个权限问题、可见性问题和响应速度问题。这三个问题,安全行业已经练了三十年。
参考来源:
- NIST AI Risk Management Framework 1.0(NIST AI 100-1,2023-01-26):https://www.nist.gov/itl/ai-risk-management-framework
- NIST AI 600-1 生成式 AI Profile(2024-07-26):https://doi.org/10.6028/NIST.AI.600-1
- OWASP Top 10 for LLM Applications 2025:https://genai.owasp.org/llm-top-10/
- OWASP LLM06:2025 Excessive Agency:https://genai.owasp.org/llmrisk/llm062025-excessive-agency/
- MITRE ATLAS 战术与技术矩阵:https://atlas.mitre.org/
- EU AI Act 实施时间线:https://artificialintelligenceact.eu/implementation-timeline/

itadol5j
暂无介绍....
没有啦 (T▽T)
延伸阅读:
企业 AI 安全能力建设路线图:从同步规划到持续运营的五个阶段
把 NIST AI RMF 的风险管理语言翻译成工程动作:五个阶段,每个阶段带交付物、过闸标准和失败模式。含 OWASP...

Claude Fable 5.2 拆解:14 项跑分 13 项超上代,但它自己砍了三刀
Anthropic 11 月 9 日发 Fable 5.2 与 Mythos 5.2:同一底层模型、两套拦截器。14 项...
不是桃色新闻:黄仁勋这 8 个月,和一份没人执行的备忘录
把时间线摆出来才是新闻:鲁比奥备忘录春天就在高层传阅、定性为情报资产,五月黄仁勋随特朗普访华、九月坐白宫国宴主桌,而当事...
AiSOC:6741 星的开源 AI SOC,先学会了对自己说实话
AiSOC 现 6741 星。它最特别的地方不是 AI 分诊,是那份 REPOSITORY_REALITY 自查报告——...
AutoHunter 拆解:24 小时挖洞机的真本事,是劝 AI 别乱提交
StanleyNull/AutoHunter 仓库全量过了一遍:130KB 纯提示词、五道拦截闸门、真实 nmap/nu...