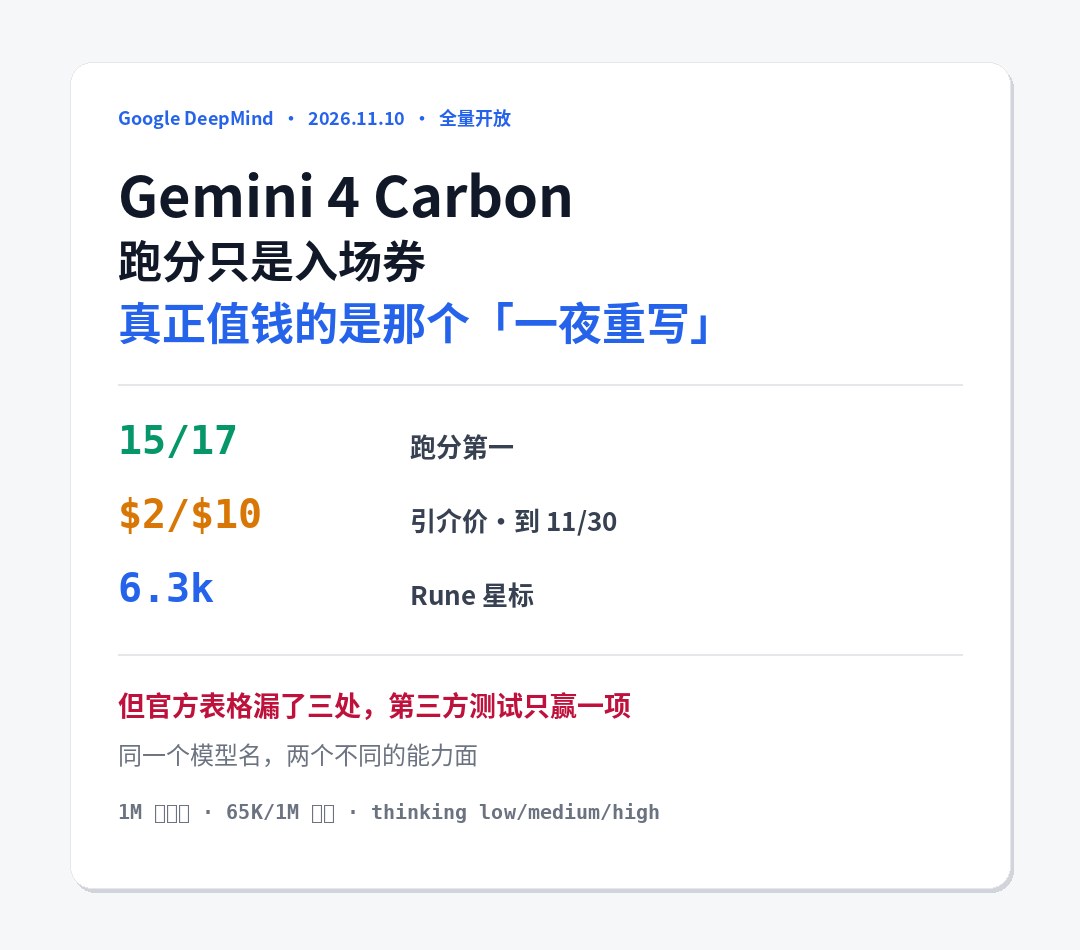
Gemini 4 Carbon 终于开放:真正值钱的不是跑分,是那个「一夜重写」
11 月 10 日,Google 把 Gemini 4 Carbon 从受控名单里放了出来。两周前它只发给一批网络安全防御团队,现在普通付费用户、企业、科研机构都能调。开发者后台、AI Studio、Gemini App、搜索的 AI 模式、Antigravity 平台、GitHub Copilot,同一天全上线。
我先去翻了定价页,再回来看跑分。这个顺序是有原因的,后面会说。
时间线说明它不是延期,是刻意压了两周
「终于开放」这个说法容易让人误会成跳票。实际节奏是这样。9 月 30 日 Gemini 4 Argon 发布,10 月 13 日开放给付费用户。10 月 28 日 Carbon 发布,只给 Fairwind 计划里的安全防御方。11 月 10 日全量放开。
从发布到全量,Carbon 用了 13 天,和 Argon 一模一样。这是一套设计好的分层投放,先把能找漏洞、能验证可利用性、能写补丁的那个版本关在防御方手里,两周之后再给所有人。
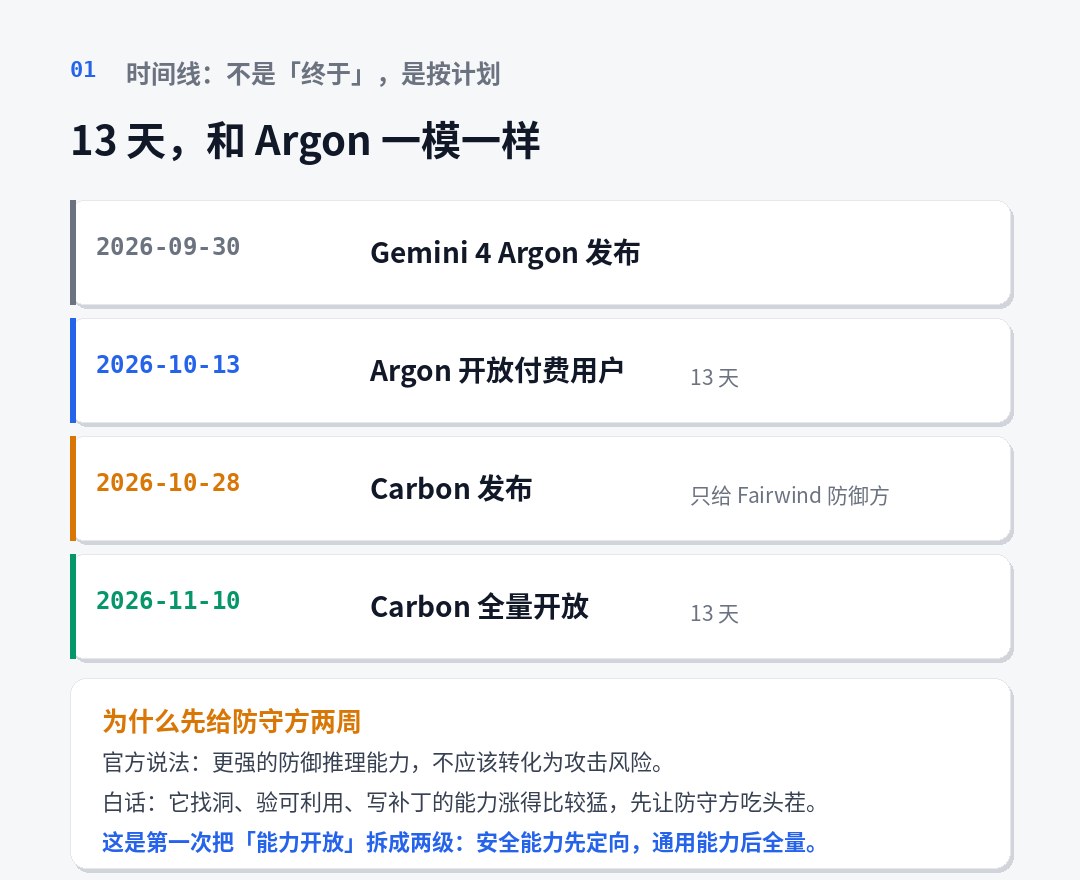
Google 在公告里写得很含蓄,「更强的防御推理能力,不应该转化为攻击风险」。翻成白话就是能力涨得太猛,得先让防守方吃头茬。
这种做法值得单独记一笔。它第一次把「能力开放」拆成两级,安全能力先定向,通用能力后全量。以后凡是主打安全的强模型,大概都会照这个走。
参数与价格,一句话说清
上下文窗口一百零四万八千五百七十六 token,输入、思考、输出共用一个池子。同步输出上限六万五千五百三十六,开 long decode 可以顶到窗口减去输入。输入支持文本、图片、音频、视频、PDF,输出只有文本。思考档位分 low、medium、high 三档,默认 medium,三档同价。
价格要在日历上画个圈。到 11 月 30 日,输入每百万 token 两块美元,输出十块,隐式缓存一毛。12 月 1 日起翻倍,四块和二十块,缓存两毛。它和 Argon 同价,所以选型从来不是钱的问题,是延迟和 token 消耗的问题。
有个细节容易忽略,思考档位不额外收费,但思考 token 按输出价算。high 档不是更贵,是更费。
官方给的定位也很干脆。Argon 管日常工程和知识工作,Carbon 专门啃把模型智力压到极限的活。复杂根因调试、架构设计、密集多模态综合、科学证明、安全审计,这几类才值得切过去。
官方 17 项里 15 项第一,但有三处裂缝
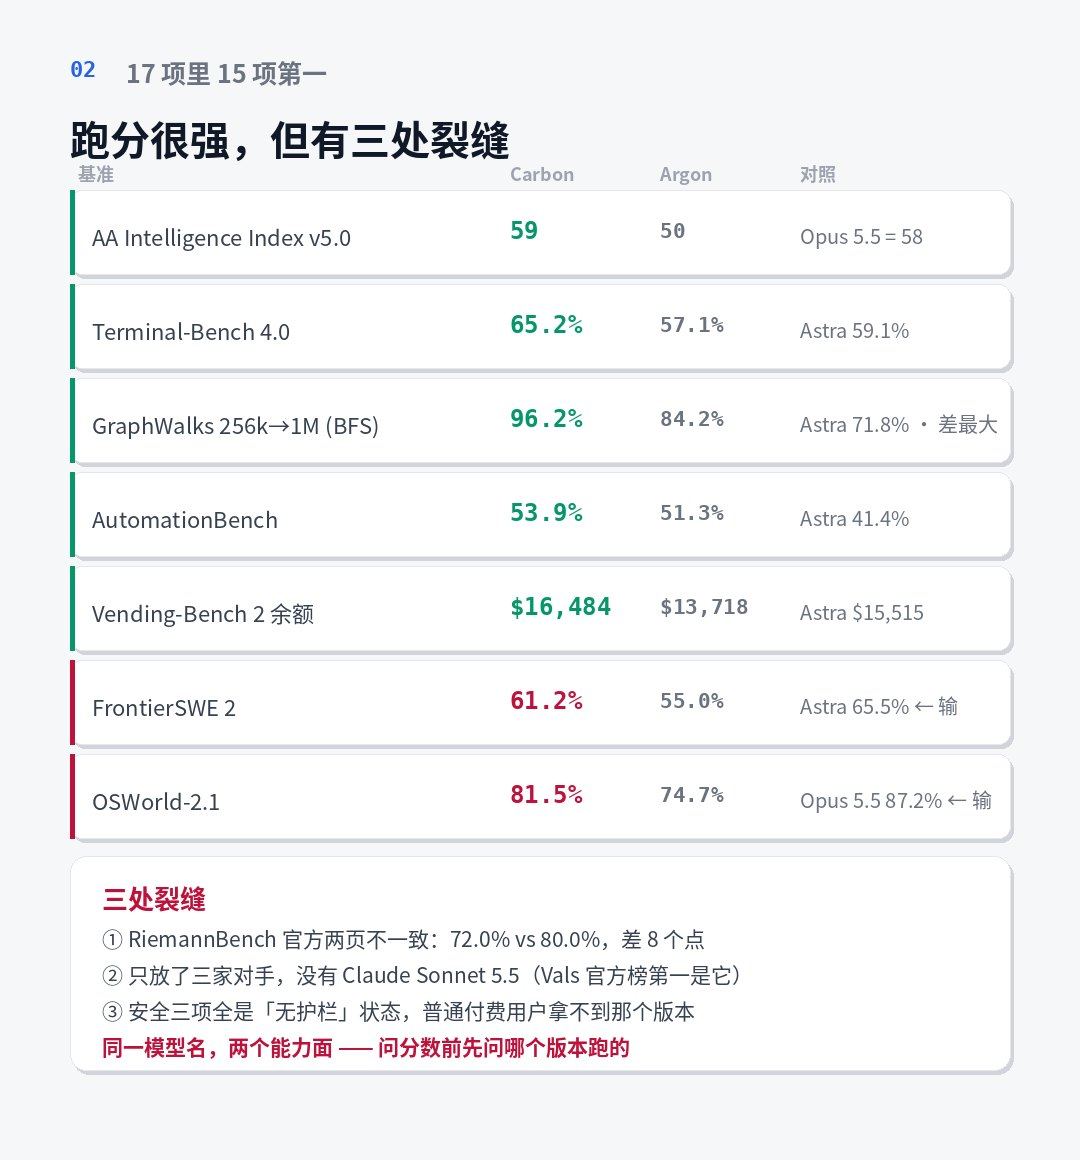
赢的地方很硬。长上下文检索那一项,它九十六点二,上一代八十四点二,差十二个点,这是全场最大的一处位移。终端任务六十五点二对五十七点一。业务流程自动化五十三点九对五十一点三。虚拟售货机那一项,期末余额一万六千四百八十四美元,对手最高一万五千五百一十五。
输的两项也明确。真实工程任务六十一分二,输给另一家的六十五分五。桌面操作系统操作八十一分五,输给对手的八十七分二。
三处裂缝官方表格没打算让你注意。
第一处,同一个模型、同一项测试,两个官方页面的数字差八个百分点。模型页写七十二,模型卡写八十,后者标了 2026 年 10 月的数据。在官方自己对齐之前,这一项不该拿来当论据。
第二处,对照表只放了三家对手,缺了刚发布的那一版。所谓「第一」取决于你选哪张榜。
第三处,安全类的三个分数是在无护栏条件下测的。普通付费用户拿到的 Carbon 带安全拦截器,跑不出那组数。
第三方测试里,它真正第一的只有一处
这一节比官方表更该看。
第三方机构独立跑完给出的结论保守得多。综合智能指数,它六十分,对手五十九分,领先一分。代码智能体指数,它五十九,对手六十二,落后三分。另一家机构的榜单,它七十分四五,对手七十分八五,落后。
三项里只赢一项,赢的那项只领先一分。这个量级在噪声区间里,不值得当成定论。
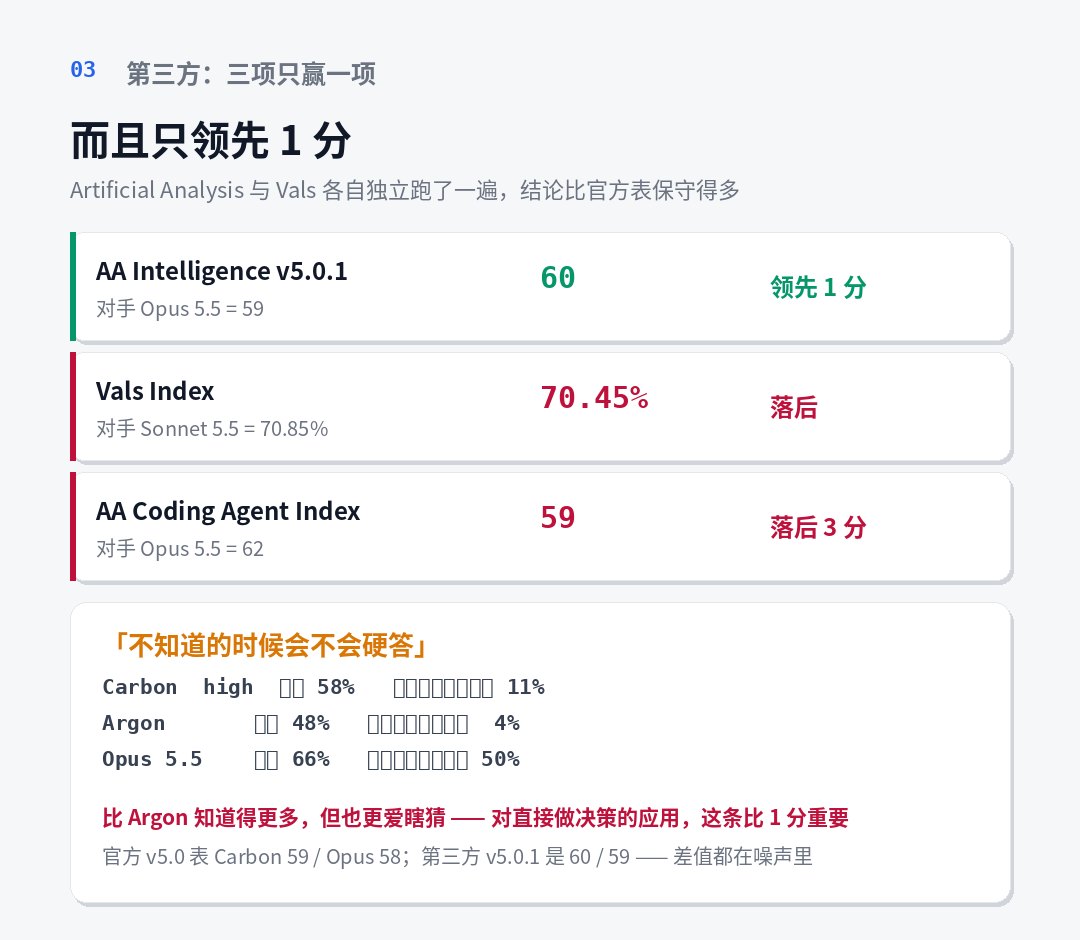
还有个数字比跑分更值得生产环境关心。第三方测了「不知道的时候会不会硬答」。Carbon 在最高档答对百分之五十八,该说不知道却说错的比例是百分之十一。上一代答对百分之四十八,说错只有百分之四。对手最高档答对百分之六十六,说错高达百分之五十。
翻成一句人话,Carbon 比上一代知道得更多,但也更爱瞎猜。相对那个宁可胡说也不认输的对手,它算克制;相对它自己的上一代,这是退步。如果你的应用拿模型输出直接做决策,这十一个点比一分差距重要得多。
那个「一夜重写」到底发生了什么
这是整篇公告里信息量最大的一段,我挖到了底。
OpenCode 的工程师 Kit Langton 在官方博客里说,团队一直搞不定界面和现有框架的一致性,下班前把需求清单丢给 Carbon。过了一夜,Carbon 从零写了一个新的 Rust UI 库,用它重写了 OpenCode 桌面应用,还带了能跑的 demo。
产品是真的。那个库叫 Rune,在 GitHub 上开源,MIT 许可,六千多 star,两百多 fork,近两千次提交。README 描述它是一个原生 GPU 渲染的 Rust UI 框架,覆盖三大桌面系统和 Web,自带渲染器、文本、布局、弹簧动画。
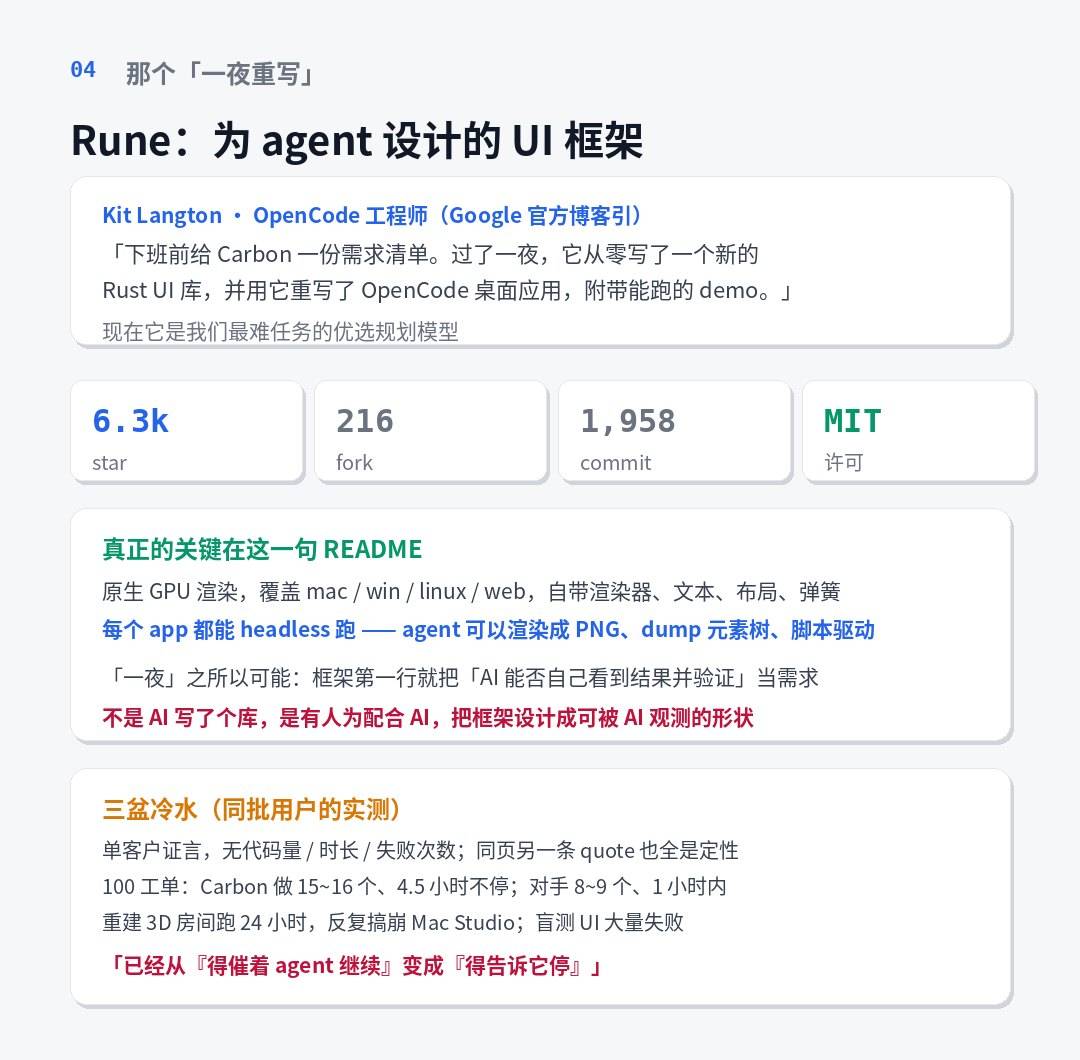
最关键的是另一句。每个 app 都能 headless 运行,agent 可以自己渲染成图片、dump 元素树、用脚本化输入驱动它。
这句话解释了「一夜」是怎么可能的。这个框架从第一行代码起,就把「AI 能不能自己看到结果并验证」当成需求写进去了。agent 写完界面能自己出图、自己比对、自己改,不需要人类截屏回传。
这才是这条证言真正的价值。不是「AI 写了一个 UI 库」,而是有人为了配合 AI,把框架设计成了可被 AI 观测的形状。
但我要泼三盆冷水。
这是单一客户证言,不是可复现实验。官方公告里它就是一段引语,没有代码量、没有时长、没有失败次数。
同一批用户里有相反记录。一家播客做了两周实测,给它约一百个工单的冻结副本,让它挑能独立完成的、每个开独立 PR。对手们一小时内做完八九个,Carbon 做了十五六个,四个半小时还没停。同一个测试者让它重建一个 3D 播客房间,跑了约二十四小时,反复把机器搞崩。测试者那句话很到位,我们已经从「得催着 agent 继续」变成「得告诉它停」。
也有明显退步。盲测界面套件上它大量直接失败,需要说「继续」最多三次。生成文件约一百 KB,对手同类只有二十五 KB。它默认排版偏信息密度堆满,文字风格比上一代差。
所以准确的结论是,Carbon 的行为特征不是更聪明,是更不肯停。长任务上是优势,交互场景里是劣势。要把它接进生产流程,第一件要配的不是提示词,是预算上限和停止条件。
多 agent 的形态也跟着变了
Carbon 开放的同一天,Antigravity 上线了群体模式预览。
它不是主 agent 派子 agent 那套。一个协调者接你的提示词,并行工人在互相隔离的 git 工作副本里干活,改动不撞车。一批对抗性验证者专门跑测试、挑 diff 的毛病。所有 agent 在一个只追加的共享消息板上协作,闲置时零 token 停住,有人需要输入立刻唤醒。
配套界面给了三样。看板看团队实时辩论,成员名单能点进任何 agent 的轨迹接管,图视图拖时间轴看团队怎么从最初需求收敛到验证过的代码。
官方建议的分工是,Carbon 当协调者、架构、安全审计、对抗验证这几个高杠杆角色,轻快模型干并行文件编辑和常规实现,因为每个 agent 可以钉不同的模型。
成本提醒官方自己写了。就算有零 token 待机和动态换模型,并行多 agent 烧配额比普通对话快得多。我自己在这台机器上让几个 agent 并行跑过活,配额掉得比预估快,这条不是客套。
安全这栏数字很好看,限定词更重要
每个数字都带括号,我一并抄上。
在模拟攻击环境里,它拦掉了自适应红队百分之九十九的攻击轨迹。每次尝试的突破率从上一代的三点一降到零点八。外部机构测的自动化攻击查询成功率,从九点八六降到二点一七。另一家跑了 132 小时、一万三千多次请求,没找到新的通用越狱。间接提示注入那个基准,攻击成功率零。
对齐那边,375 项智能体诚实度基准它过百分之九十二,上一代百分之七十。缺数据时拒绝编造百分之九十八。主动指出方法学缺陷百分之六十八。
这三组数要一起读。单独看九十九会以为问题解决了,加上「模拟环境」「某些分布上仍可改进」才知道它是概率性护栏,不是边界。真实攻击者不在那个测试分布里。
真实用途那边有三个案例。Google 内部的扫描分诊修复流程,扫描召回百分之百,分诊精确率百分之九十五,在开源仓库上比上一代再提升四分之一相对值,捞出了此前没人发现的真实逻辑缺陷。云漏洞研究团队拿它证明了某流行开源软件的两个缺陷确实可利用,帮维护者把定级改到严重并出补丁。一家安全公司的公益扫描项目,两小时内从两家大型 SaaS 供应商身上挖到 0day。
科研那边的量级更离谱。研究团队让它生成数百万行 Lean 代码,把 Signal 加密协议的安全属性数学证明,从专家团队数年压缩到数周。蛋白结构那边,在七个低同源家族上,检索到的同源序列数平均提升四十倍,不用重训模型。
三条落地判断
不要把它当 Argon 的替代品,当一次性的攻坚资源。同价但更慢更费,官方自己都说日常用 Argon。判断标准很简单,这个任务卡住过一次以上、并且需要它自己验证自己的结果,才值得切过去。
11 月 30 日之前把该跑的跑完。引介价到月底,之后翻倍。如果你的业务量能提前压测,这两周做评测和基准的成本只有之后的一半。这个时间窗和 Argon 的引介期同一天结束,不是巧合。
接进 agent 流程之前,先配停止条件。更不肯停是这一代最鲜明的行为特征,一百个工单能啃十六个,也能跑二十四小时把机器跑崩、把配额烧光。预算上限、最大循环数、自动终止条件,比提示词重要。
给做安全的人留一句。Carbon 的网络能力是分级开放的,Fairwind 计划拿的是无护栏版本,普通付费用户拿到的是带拦截器的版本。同一个模型名,两个不同的能力面。做能力评估的时候,问一句这个分数是哪个版本跑出来的,比看分数本身有用。
参考来源
- 开放公告(11 月 10 日) https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/
- 发布公告(10 月 28 日) https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon/
- 模型卡 https://deepmind.google/models/model-cards/gemini-4-carbon/
- 模型页与跑分表 https://deepmind.google/models/gemini/
- 定价文档 https://ai.google.dev/gemini-api/docs/pricing
- Antigravity 群体模式 https://antigravity.google/blog/gemini-4-carbon-in-google-antigravity
- GitHub Copilot 支持 https://github.blog/changelog/2026-11-10-gemini-4-carbon-in-github-copilot
- Rune 仓库 https://github.com/anomalyco/rune
- 第三方两周实测转述 https://finance.biggo.com/news/d9cd20e5275494cc

itadol5j
暂无介绍....
没有啦 (T▽T)
延伸阅读:
Gemini 4 Carbon 终于开放:真正值钱的不是跑分,是那个「一夜重写」
Gemini 4 Carbon 于 2026-11-10 全量开放(10-28 发布时只给 Fairwind 计划的网络...

Notepad++ 8.9.9 修了 6 个漏洞,一个 CVE 号都没给:其中第 2 条是第 1 条的修复被绕过
Notepad++ 8.9.9 于 2026-11-06 发布,一次修 6 个漏洞,官方页面六个条目全部标注 CVE 未...
企业 AI 安全能力建设路线图:从同步规划到持续运营的五个阶段
把 NIST AI RMF 的风险管理语言翻译成工程动作:五个阶段,每个阶段带交付物、过闸标准和失败模式。含 OWASP...
Claude Fable 5.2 拆解:14 项跑分 13 项超上代,但它自己砍了三刀
Anthropic 11 月 9 日发 Fable 5.2 与 Mythos 5.2:同一底层模型、两套拦截器。14 项...
不是桃色新闻:黄仁勋这 8 个月,和一份没人执行的备忘录
把时间线摆出来才是新闻:鲁比奥备忘录春天就在高层传阅、定性为情报资产,五月黄仁勋随特朗普访华、九月坐白宫国宴主桌,而当事...