76.2 万条微信全导出来喂给 AI:最难的压根不是 AI
先说结论:这件事我做成了。76.2 万条消息、3675 万字,全部落进一个本地库里,现在我可以问它任何问题。但我花了三天,其中两天不是在跟 AI 较劲,是在跟「怎么把数据拿到手」这件事较劲。
而且我必须先把一句难听的话放在最前面——那些天天喊「我的数据我做主」的口号,在微信这儿基本是句空话。你的记录确实躺在你自己的硬盘上,一个字节都没少。但你想把它读出来,得先跨过一道法律门槛,再跨过一道技术门槛。技术那道我翻过去了,法律那道,翻过去的人现在全在删库。
一、就在一年前,做这事的工具被集体清场了
2025 年 10 月 20 日,两个最有名的微信数据工具同一天发了一模一样的通知。
PyWxDump 的 README 变成了「项目移除通知」,原话大意是:收到微信官方律师函,指出核心功能存在合规风险,为规避法律问题,移除全部代码与提交历史,仓库只留一纸说明。作者最后写了句「后会有期」,然后把公众号改成了只发 Python 教程。
同一天,chatlog 的仓库也只剩一份说明,作者 Sarv 的措辞几乎一样:收到函件,代码和提交历史全部清空,不再提供任何支持。
这两个项目当时什么量级?PyWxDump 9638 星,chatlog 9177 星。都不算小。
再往后,2026 年 1 月又有消息说腾讯通过 GitHub 的 DMCA 通道一次性投诉了一批相关仓库,公开报道里提到的数字是 30 多个,其中不乏几千星的成熟项目,有维护者直接表示在法律压力下停止维护。
说白了就是一句话:让你读自己聊天记录的工具,被系统性清理掉了。
所以别急着抄什么教程。你现在能在网上找到的绝大多数「一键导出微信记录」教程,点进去要么是死链,要么是引流到付费软件,要么是几个月前就该删掉的旧仓库。我写这篇,讲的是方法,不是给你一个能跑的仓库——因为那个仓库大概率已经不在了。
二、先搞清楚:你的数据到底在哪
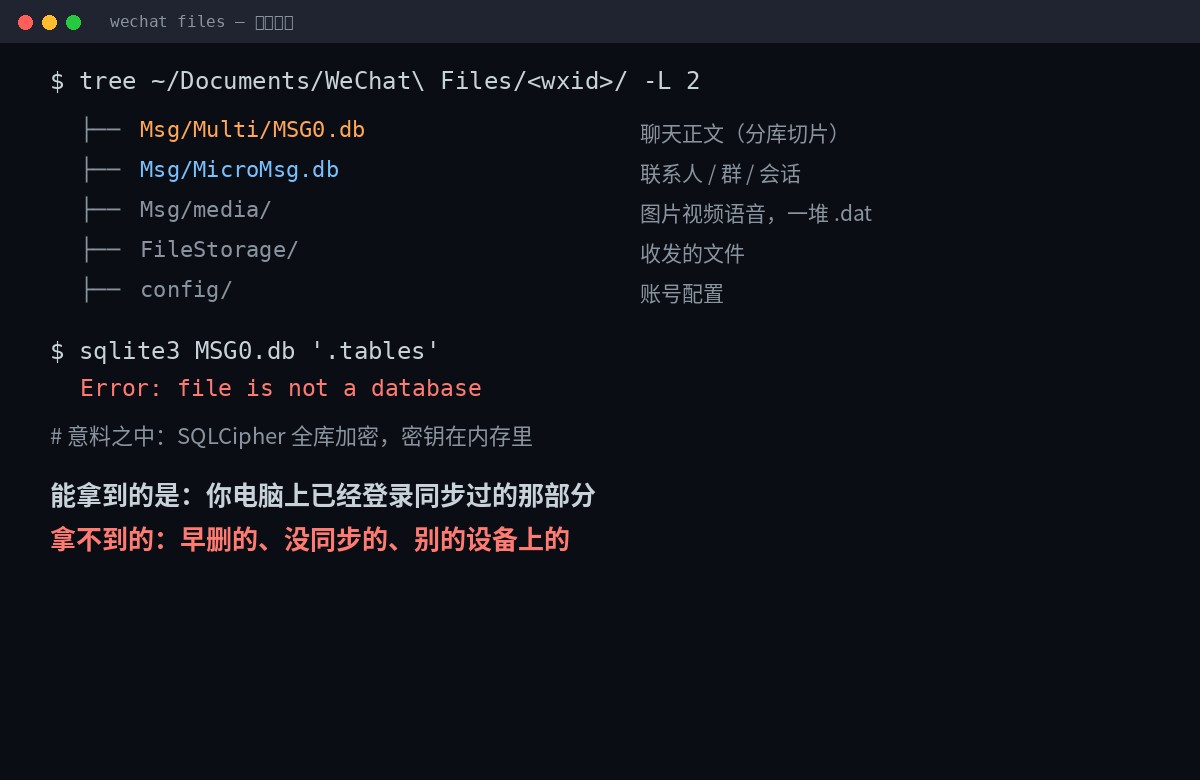
Windows 上,微信的数据目录长这样:
WeChat Files/
└── <你的wxid>/
    ├── Msg/
    │   ├── Multi/MSG0.db      # 聊天正文,分库切片
    │   ├── MicroMsg.db        # 联系人、群、会话列表
    │   └── media/             # 图片、语音、视频,一堆 .dat
    ├── FileStorage/           # 收发的文件
    └── config/                # 账号配置
Mac 上在 ~/Library/Containers/com.tencent.xinWeChat/ 下面,结构类似。微信 4.x 之后路径和库结构都调过,别拿老文章的路径硬套。
然后你兴冲冲打开 MSG0.db,会得到这个:
$ sqlite3 MSG0.db ".tables"
Error: file is not a database意料之中。整个库是 SQLCipher 加密的,密钥不存在文件里,是微信运行时从内存里算出来的。这就是为什么所有这类工具的核心步骤都叫「取密钥」——它们做的事情,本质上是去进程内存里把那把钥匙捞出来。
这一步就是合规争议的核心。你要读的是自己的数据,但你要用的手段是绕过厂商的技术保护措施。这两件事在法律上的定性,和你的直觉完全是两码事。
我给不了你合规豁免,只能把边界说清楚:本地导出自己账号的、只自己用的,和拿去传播、售卖、做服务的,性质完全不同。后面那种,别碰。
另一个现实问题:导出的是「残卷」,不是「全本」
就算技术问题解决了,你拿到的也只是这台电脑上同步过的那部分。微信 PC 端的记录是你登录期间同步下来的、或者你手动迁移过来的。
早年在别的手机上聊完就删的、换机时没迁的、存在旧设备里的,全都不在。我这次号称「十年」,实际能拼出完整对话的年份大概只有六七年,更早的只剩零散片段。所谓「十年记录」,是一堆残页缝起来的。
三、3675 万字是个什么概念
清洗完是 3675 万字,76.2 万条。平均一条 48 个字,很符合真实聊天——大部分是「在吗」「好的」「收到」「哈哈哈哈」。
这个体量,第一反应肯定是「直接塞给大模型」。我算了一下,然后放弃了这个念头。
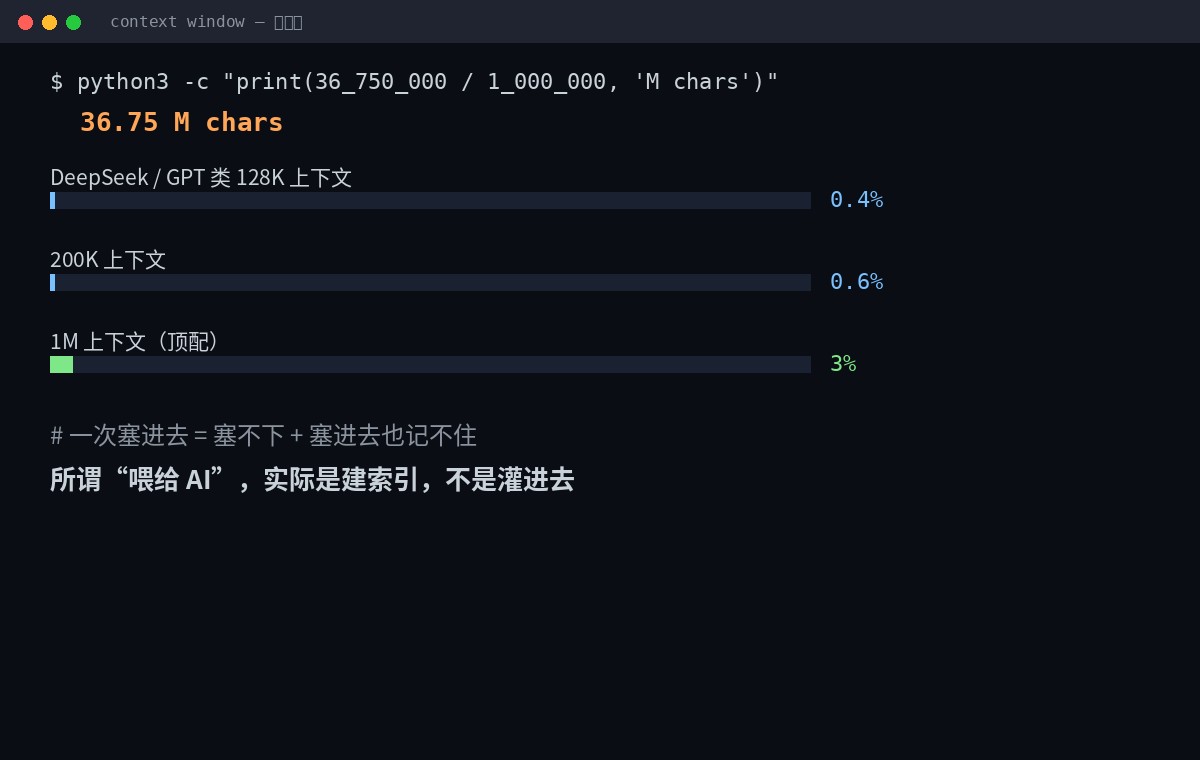
| 喂法 | 上下文需求 | 能不能塞下 |
|---|---|---|
| 主流 128K 上下文 | 约 36.75 M 字符 | 勉强 0.4%,塞不下 |
| 200K 上下文 | 约 36.75 M 字符 | 0.6%,还是塞不下 |
| 顶配 1M 上下文 | 约 36.75 M 字符 | 3% 左右,塞得下但要花大钱 |
注意,1M 上下文那一行有个陷阱:能塞进去,不等于能记住。上下文越长,模型对中间部分的注意力衰减越明显,这在业界被反复验证过。你把十年的废话全倒进去,问它「2021 年 3 月我说过要换工作吗」,它照样能一本正经地胡说。
所以「全喂给 AI」这个说法,严格讲是不准确的。我做的不是把 3675 万字灌进模型的脑子,是给它建了一个能随时翻的索引。这个区别很关键,后面所有工程决策都从这儿来。
四、我用的是这条管道
五步,一步都省不了。
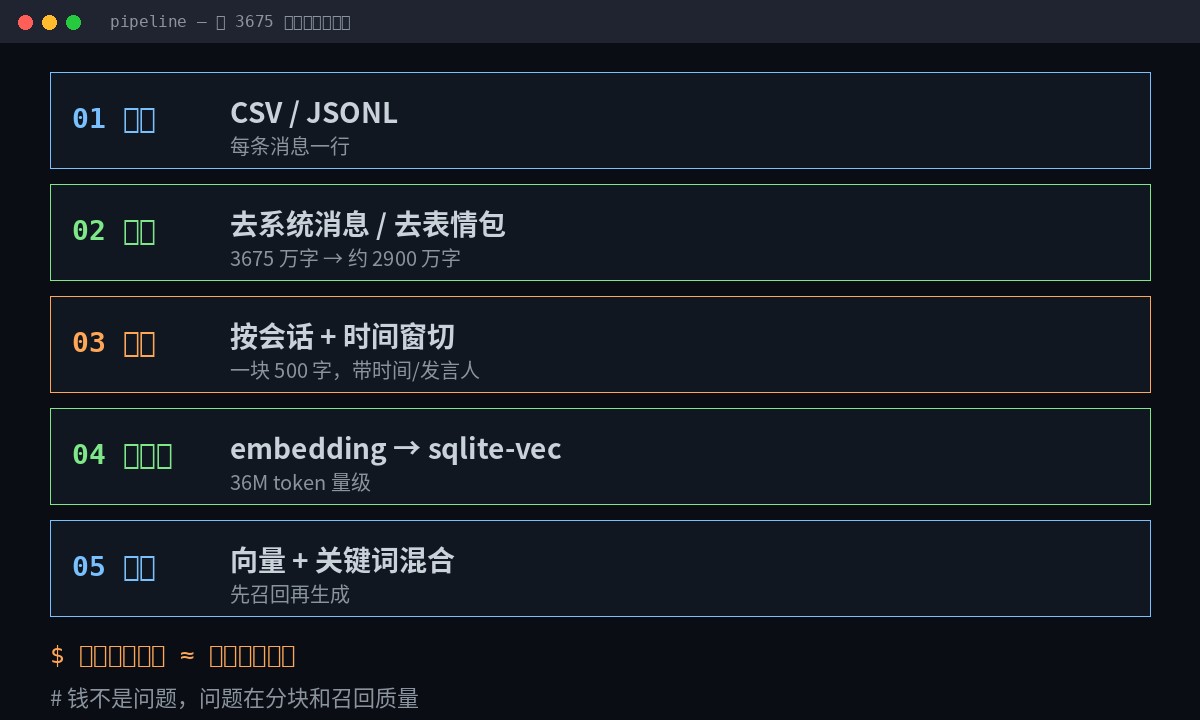
第 1 步:导出成结构化文本
目标格式很简单,一行一条,带时间戳、发言人、会话名。别导出成 HTML 或者 PDF——那些是给人看的,不是给程序看的。我要的是后面能 grep、能切块、能算时间的结构。
2021-03-14 22:17:05 | 老张 | [私聊]
2021-03-14 22:17:41 | 我   | 那个事我想了两天,还是算了
2021-03-14 22:18:02 | 老张 | 早该这样这一步没什么技术含量,但决定了后面所有环节的质量。时间戳丢了,你就永远问不了「那段时间」;发言人丢了,你就分不清谁说的。
第 2 步:清洗,砍掉一半噪音
原始数据里至少三成是垃圾:「你已添加了XXX,现在可以开始聊天了」「对方撤回了一条消息」「[图片]」「[表情]」,还有群里无穷无尽的接龙和红包提示。
我的处理原则是:系统消息全删,纯媒体占位符保留但标记类型,超短消息(少于 4 个字且无信息量的)合并进上下文。
3675 万字砍到差不多 2900 万字。别心疼,这些字留着只会污染检索结果。
第 3 步:分块——这一步最容易毁掉整个项目
新手最常犯的错,是按固定字数硬切。切成 500 字一块,切到一半正好把一段对话腰斩,前半句在你手里,后半句在下一块。检索的时候召回一半,AI 就开始编。
我的做法是按会话 + 时间窗双约束切:同一个会话内,相邻消息间隔超过 30 分钟就断开;单块控制在 400 到 600 字;每块都带上「会话名 + 时间范围 + 参与者」的头信息。
这个头信息看起来是冗余,实际上是最值钱的部分。因为用户的问题往往带时间——「去年年底」「刚毕业那会儿」——没有时间锚点,向量检索根本对不上。
第 4 步:向量化
7 万多个块,全部跑一遍 embedding。这个量级的成本,人民币两位数就够,比我预想的便宜太多。真正贵的是时间和你重跑的次数——我因为分块策略改了三版,重跑了三次。
存哪?sqlite-vec 就够了。别上来就搭 Milvus、Qdrant,一个人几万条数据,用不上那些。
第 5 步:混合检索,别只信向量
纯向量检索在聊天记录这种场景下表现很一般。原因很直白:你要找的往往是人名、地名、具体金额,这些是精确匹配的活,向量不擅长。
所以最终跑的是混合检索:向量召回一批,关键词(BM25 或直接 SQL LIKE)召回一批,合并去重,再交给模型生成答案。这一改,回答准确率的提升比前面所有优化加起来都明显。
五、我踩的五个坑,你大概率也会踩
- 以为 .db 是普通 sqlite。它不是。所有「怎么打不开」的问题都源于这一点。
- 图片和语音是 .dat。不是标准格式,每个文件头都有异或加密。想提取得单独处理,我直接放弃了——十年的图,提取价值远低于成本。
- 群聊的发言人 ID 是数字。要在 MicroMsg.db 里做一次映射才能变回昵称,不做映射的话,你导出来全是 wxid_xxxx,根本没法读。
- 同一个人的名字会变。十年里改过备注、改过昵称,同一个人在你的库里可能有四个名字。不统一,检索必错。
- 时间戳有时区问题。跨设备同步的记录时间会偏,遇到「凌晨 3 点发的消息」先怀疑时间戳,别怀疑自己记错。
六、它现在能干什么
说几个我实际问过、且答得不错的问题:
- 「2021 年我说要换工作,当时具体纠结哪几点?」——它把我跟三个人在不同时间的对话拼起来了,还原出当时的三个顾虑。
- 「老张答应过帮我做的那件事,最后做了吗?」——它找到了承诺那条,又找到了三个月后我追问、他推脱的那条。
- 「这几年我提过几次想去日本?」——数出来 7 次,附了每次的时间和上下文。
也有答得很烂的。凡是涉及「我当时是什么心情」这种主观问题,它给的全是套话。聊天记录能还原事实,还原不了感受。这一点上,AI 和你翻旧聊天记录的体验是一样的——甚至更差,因为它不会犹豫。
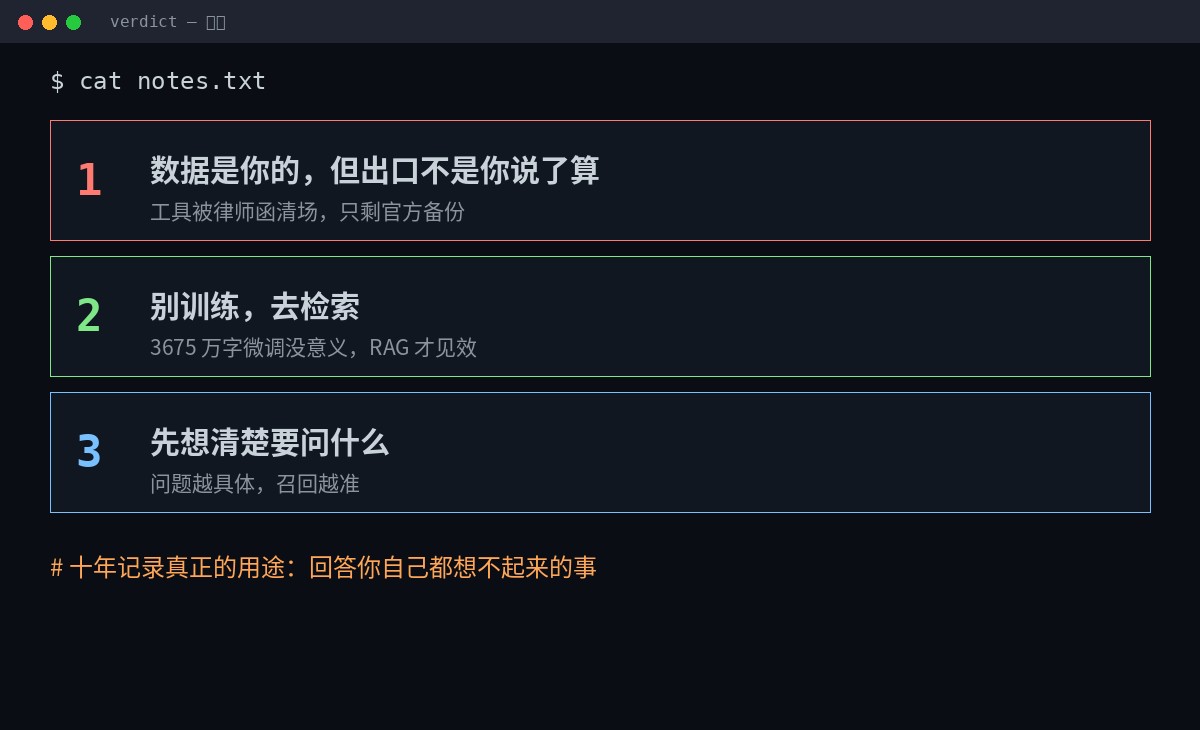
七、这件事到底值不值得做
分三种人。
- 只是想备份、怕丢的:别折腾了。微信自带「备份与恢复」,Windows/Mac 端左下角更多菜单里就有,手机端在「我 → 设置 → 聊天记录管理 → 导入与导出」。加密备份到你自己的硬盘上,够用。你要的是「不丢」,不是「能问」。
- 想找回具体某件事的:先别建库。微信自带的搜索其实不差,关键词+时间筛选能解决八成需求。剩下两成,才轮到你搭管道。
- 真的想把十年变成可对话的记忆:做。但先接受三个前提——数据是残卷、法律边界要自己守、问答质量取决于你的分块功夫而不是模型多强。
至于「喂给 AI」这件事本身,我最大的感受是:AI 不是这一步的瓶颈。
真正难的是导出、清洗、分块、对齐人名、处理时间戳这些脏活。这些活没有任何一个模型能帮你干,全是一行行代码磨出来的。等数据干净了,接个模型反而是最简单的一步。
所以别被「全喂给 AI」这个说法骗了。这不是一次技术炫技,是一次手工活。3675 万字里,值得被问到的可能只有几万字,剩下全是「哈哈哈」和「好的」。但就是那几万字,值得你花三天。
最后提醒一句:这类工具现在的处境,上面已经写清楚了。技术上能做,不等于鼓励你去做;做之前请自己把风险想清楚,尤其别把导出的数据往外传。

itadol5j
暂无介绍....
没有啦 (T▽T)
延伸阅读:
76.2 万条微信全导出来喂给 AI:最难的压根不是 AI
76.2 万条消息、3675 万字、十年记录。导出、清洗、分块、向量化、混合检索,五步管道全流程,外加五个必踩的坑。还有...

opencode-models-discovery 2.0.0 发布:配置形状全换,OpenCode v2 正式转正
九种元数据格式、原生 /connect 凭证、宿主托管缓存。从 v1 迁到 v2 的配置字段对照和四条检查清单都在这里。
我蹲了半个月,Gemini 4 Argon 今天凌晨终于全球上线了
先说结果:Gemini 4 Argon 今天(10 月 13 日)凌晨正式全球开放了。我为了它前后蹲了半个月,中间踩了两...
REA 爆火后,Agent 时代软件的护城河不存在了?
先说一个可能不太受欢迎的判断:“代码写得复杂所以抄不走”这个护城河,确实塌了。但“软件没有护城河了”是个过度反应——塌掉...
SAST vs DAST vs IAST:安全测试三兄弟的互补而非替代
应用安全测试里最常见的三个缩写:SAST、DAST、IAST。很多人第一反应是“选一个最强的”,但这是个伪命题——这三兄...