opencode-models-discovery 2.0.0 发布:配置形状全换,OpenCode v2 正式转正
先说结论:opencode-models-discovery 2.0.0 在 2026 年 10 月 19 日发布,把 OpenCode v2 正式扶正成主力,v1 退成兼容适配器。这不是一次常规升级——配置文件的形状整个换了,你照着老教程抄,大概率一行都跑不起来。
我自己踩了三个跟头,都写在下边。先说它是干嘛的:这东西是个 OpenCode 插件,专门解决一个很烦的问题——你在 OpenCode 里接了一堆 OpenAI 兼容的网关、本地模型服务、中转 API,每上一个新模型就得手动去 config 里敲一遍模型名、上下文长度、价格。这个插件让你只配一次 baseURL,剩下的它自己拉。
一、这次到底变了什么
仓库是 yuhp/opencode-models-discovery,MIT 协议,2026 年 4 月建的,现在 188 星、57 个 fork。听起来不算顶流,但它是 OpenCode 生态里少数认真做「模型发现」这件事的项目。
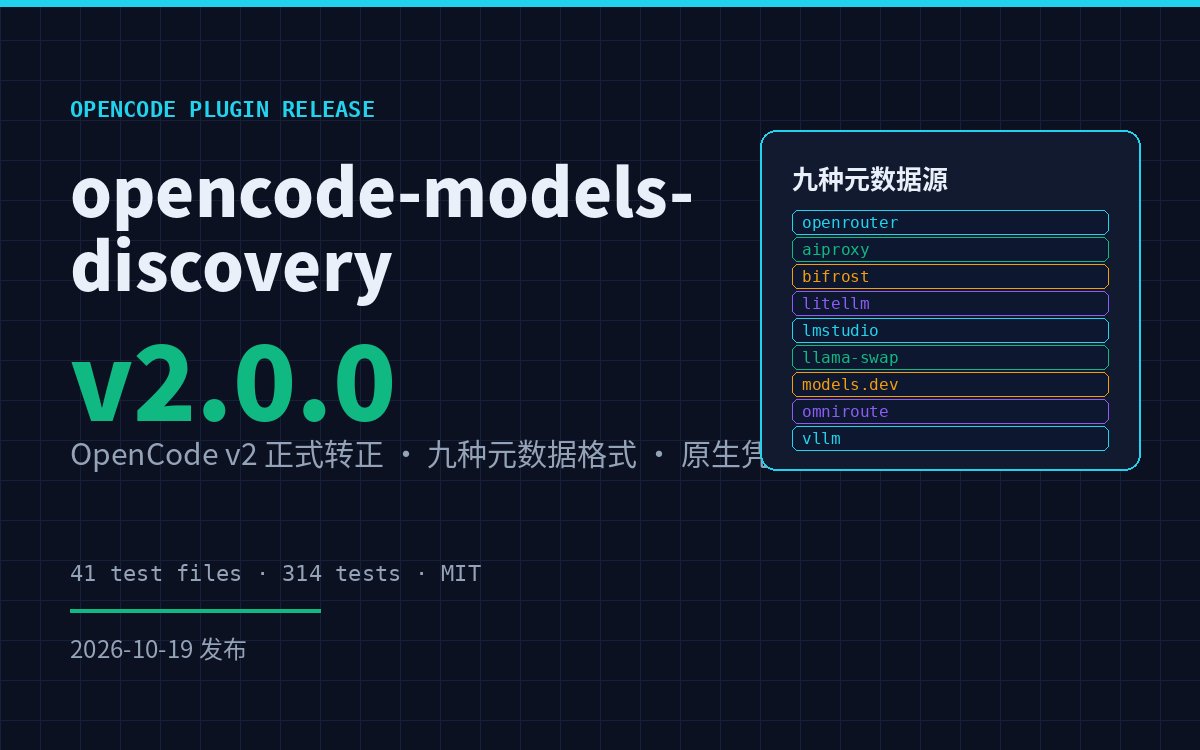
2.0.0 的核心动作只有一个:把 OpenCode v2 提升为首要稳定集成。具体到技术上,v2 用的是原生的 plugins / providers 配置结构、provider 生命周期 API、宿主托管存储、Integration 凭证、原生 TUI、RPC handler 和 Agent Tools。
翻译成人话:以前的插件是「我偷偷改你的配置」,现在是「宿主给我开了正规接口」。凭证不用写进配置文件,缓存交给宿主管,模型覆盖可以在 TUI 面板里点着改,改完不用重启。
v1 和 v2 的支持级别
| 宿主版本 | 支持级别 | 配置字段 | 存储与凭证 |
|---|---|---|---|
| OpenCode v2 | 稳定 / 主力 | plugins 和 providers | 宿主 ctx.storage / ctx.integration |
| OpenCode v1 | 遗留兼容 | plugin 和 provider | v1 XDG 缓存 + auth 兜底 |
v1 不是被砍了,安全修复和严重回归还会管。但新功能——生命周期、缓存、TUI、RPC、模型覆盖——全部只往 v2 走,不会自动回移到 v1。
二、九个元数据格式,这才是重头戏
v2.0.0 官方文档化了九种模型信息格式,把「元数据摄取」和「发现调度」彻底拆开了。这个设计挺聪明:调度逻辑不用为每个厂商改一遍,加个格式适配器就行。
| 格式 | 拿到什么 | 额外请求 |
|---|---|---|
openrouter | 上下文长度、top provider 输出上限、模态(text/image/audio)、prompt/completion 与缓存价格、工具调用标记、推理档位(low/medium/high) | 不额外请求 |
aiproxy | AIProxy 内联 limits、价格、effort 档 + models.dev 的显示名 | 组装 |
bifrost | 内联 limits、模态、按 token 计价、推理变体 | 不额外请求 |
litellm | 富模型元数据、上下文限制、价格、能力 | 请求 /v1/model/info |
lmstudio | 已加载实例配置(LM Studio 0.4.0+ 原生 /api/v1/models) | 一次 |
llama-swap | 上下文长度、架构、函数调用标记 | 不额外请求 |
models.dev | 公共目录兜底,通用上下文与能力 | 拉 models.json |
omniroute | limits、多模态、服务档位(fast/flex) | 不额外请求 |
vllm | 直接抽 max_model_len | 不额外请求 |
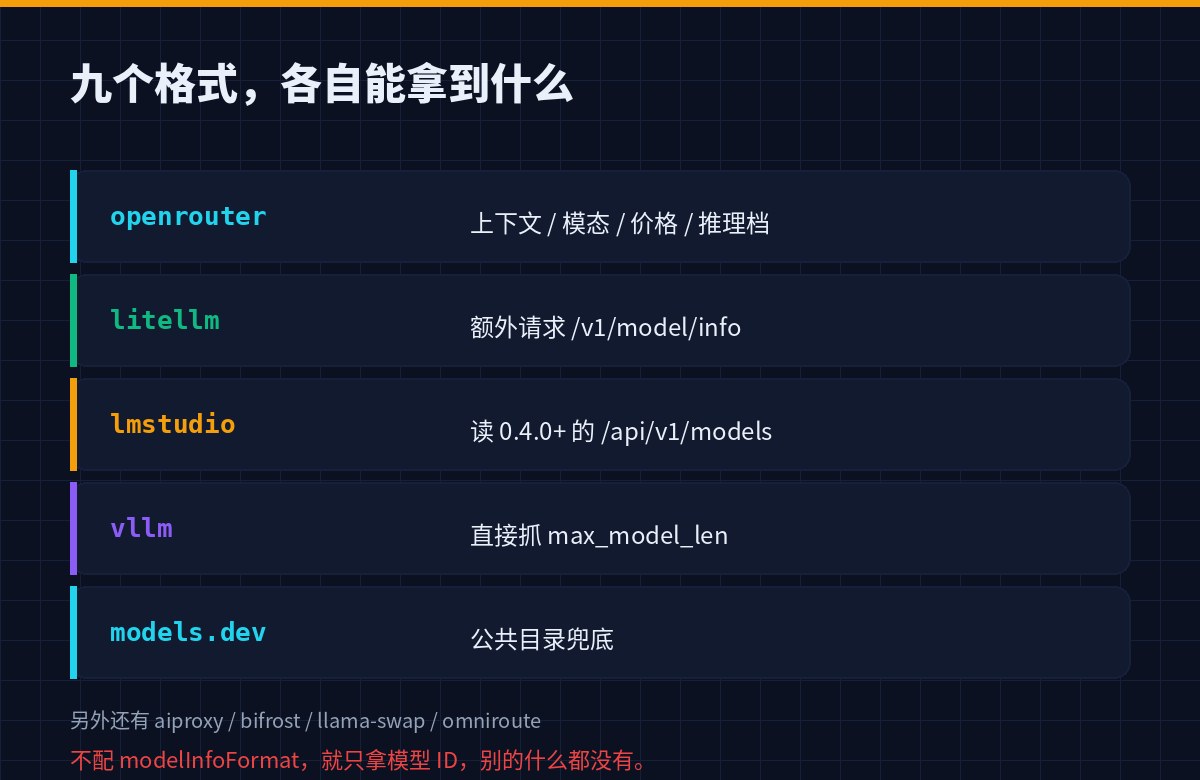
注意最后那句:如果你不配 modelInfoFormat,那就只有模型 ID,什么元数据都没有。这不是 bug,是设计——不猜你接的是什么服务,避免拉一堆错误的价格和上下文长度进来。
我一开始就是没配这个字段,看着列表里一排模型只有名字,还在想「怎么什么都没变」,翻了半天文档才反应过来。
三、配置文件到底怎么写
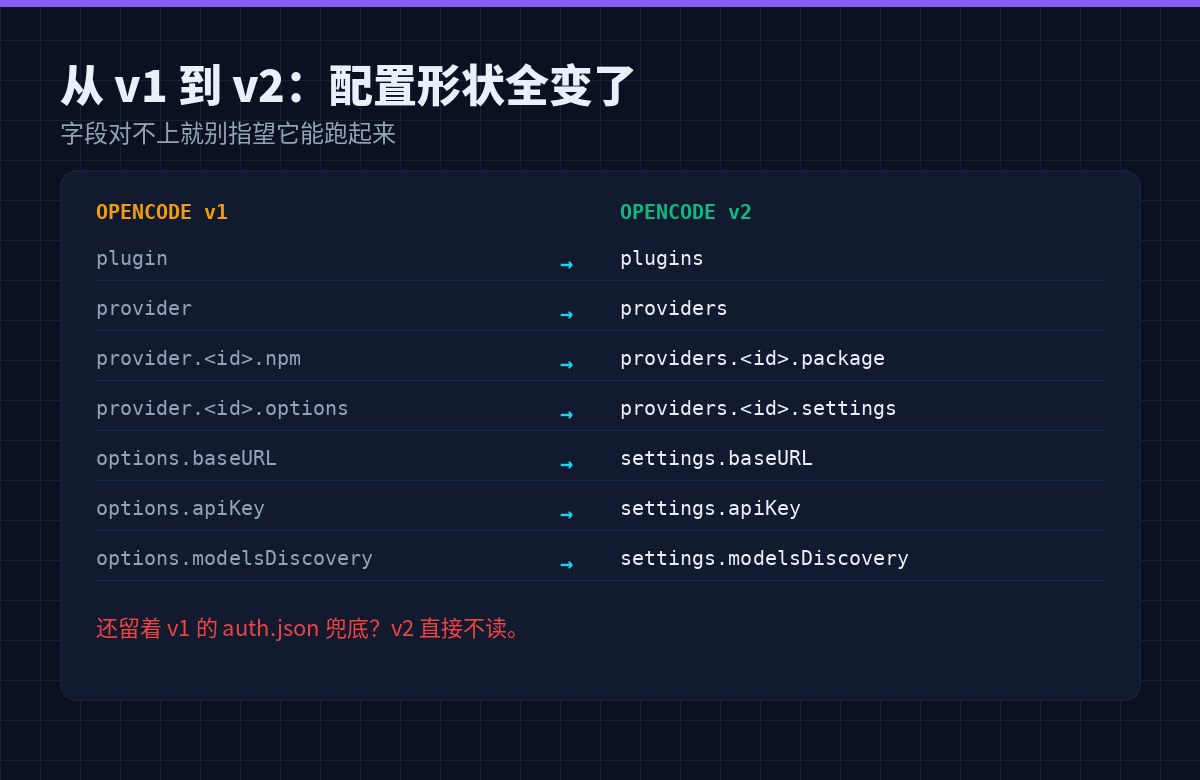
这是最容易翻车的地方。v1 那套 plugin / provider / options 在 v2 里全部作废,换成了复数 + settings。
| OpenCode v1 | OpenCode v2 |
|---|---|
plugin | plugins |
provider | providers |
provider.<id>.npm | providers.<id>.package |
provider.<id>.options | providers.<id>.settings |
options.baseURL | settings.baseURL |
options.apiKey | settings.apiKey |
options.modelsDiscovery | settings.modelsDiscovery |
一个能直接跑的 v2 配置长这样:
{
  "$schema": "https://opencode.ai/config.json",
  "plugins": [
    "opencode-models-discovery@2.0.0"
  ],
  "providers": {
    "gateway": {
      "package": "@opencode/ai/providers/openai-compatible",
      "name": "My Gateway",
      "settings": {
        "baseURL": "https://gateway.example.com/v1",
        "apiKey": "{env:GATEWAY_API_KEY}",
        "modelsDiscovery": {
          "enabled": true,
          "modelInfoFormat": "models.dev",
          "smartModelName": true,
          "cache": {
            "enabled": true,
            "ttlSeconds": 86400
          }
        }
      }
    }
  }
}
几个必须注意的点:
modelsDiscovery.enabled必须显式写true。v2 不再默认开启,这是行为变更,不是可选项。package对 OpenAI 兼容服务统一是@opencode/ai/providers/openai-compatible。- 凭证写
{env:KEY}让宿主解析,或者干脆不写apiKey,直接用 OpenCode 原生的/connect交互式录入。 - 默认拉的是
/v1/models(相对 baseURL 的 origin)。碰到 DeepSeek 这种只暴露/models的,得在modelsDiscovery里加"endpoint": "/models"。 - v2 完全不读 v1 的
auth.json和OPENCODE_AUTH_CONTENT兜底。指望它自己接上老凭证的,会卡在 401。
四、模型覆盖和缓存,比想象中实用
v2 的模型覆盖存在宿主存储的 overrides:<providerID>:<modelID> 命名空间下。能改的字段包括显示名、limits、能力、推理、附件、变体、价格、兼容性元数据。
有个细节值得夸:凭证和授权类字段会被拒绝,永远不会被持久化。这个边界划得很清楚——覆盖是覆盖展示和调度参数,不是让你把密钥塞进去。
覆盖可以在 /models-discovery-console 里可视化编辑,列表里被覆盖过的模型标个 *。改完直接重载 provider、刷新 TUI 的模型列表,不用重启服务。清缓存也不会删覆盖,这是很多人会误操作的点。
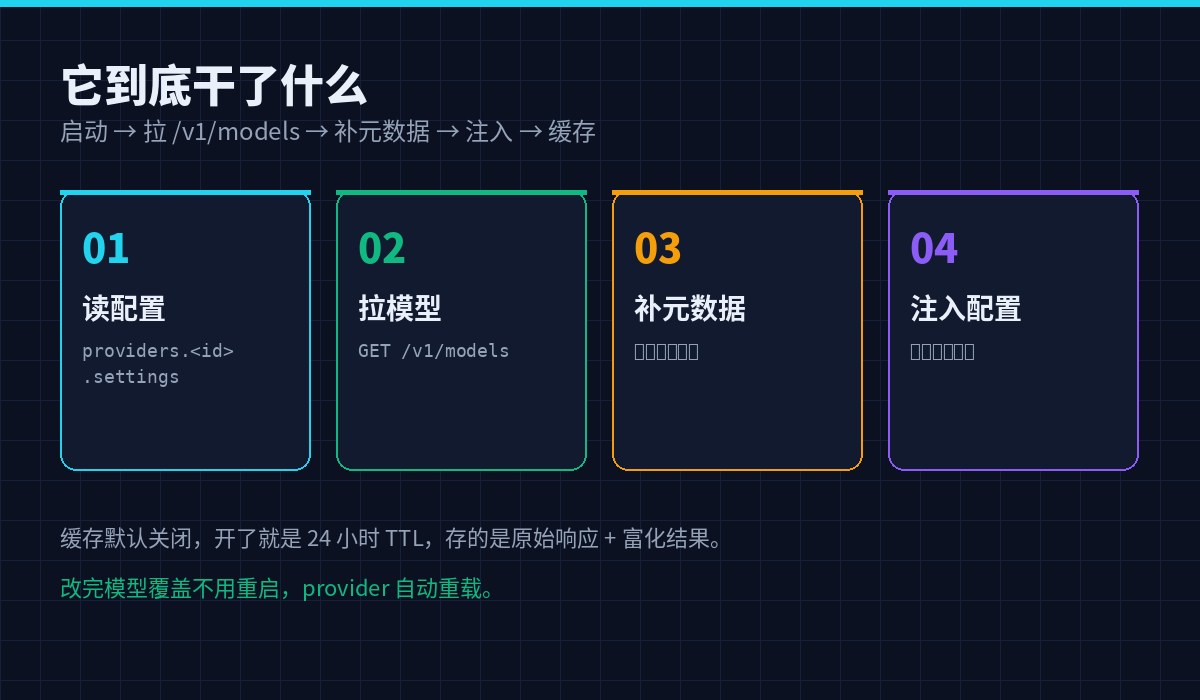
缓存默认是关的,开了之后 TTL 默认 24 小时,存的是原始发现响应和富化结果,走宿主的 ctx.storage。注意 v1 的 XDG 缓存文件不会导入 v2,两套命名空间完全隔离。
五、TUI 命令和 Agent Tools
v2 提供的入口有这四个:
/models-discovery-refresh
/models-discovery-console
models_discovery_refresh
models_discovery_status
前两个是 TUI 命令,后两个是给自动化用的 agent tools。models_discovery_status 传 rawCache: true 能把缓存里的原始模型和富化结果一起吐出来,排查「为什么价格不对」的时候特别有用。
控制台还支持按 provider 过滤:/models-discovery-console status --provider <provider-id>。接了三五个网关的时候,这个能省不少翻找时间。
六、升级前先过这张检查单
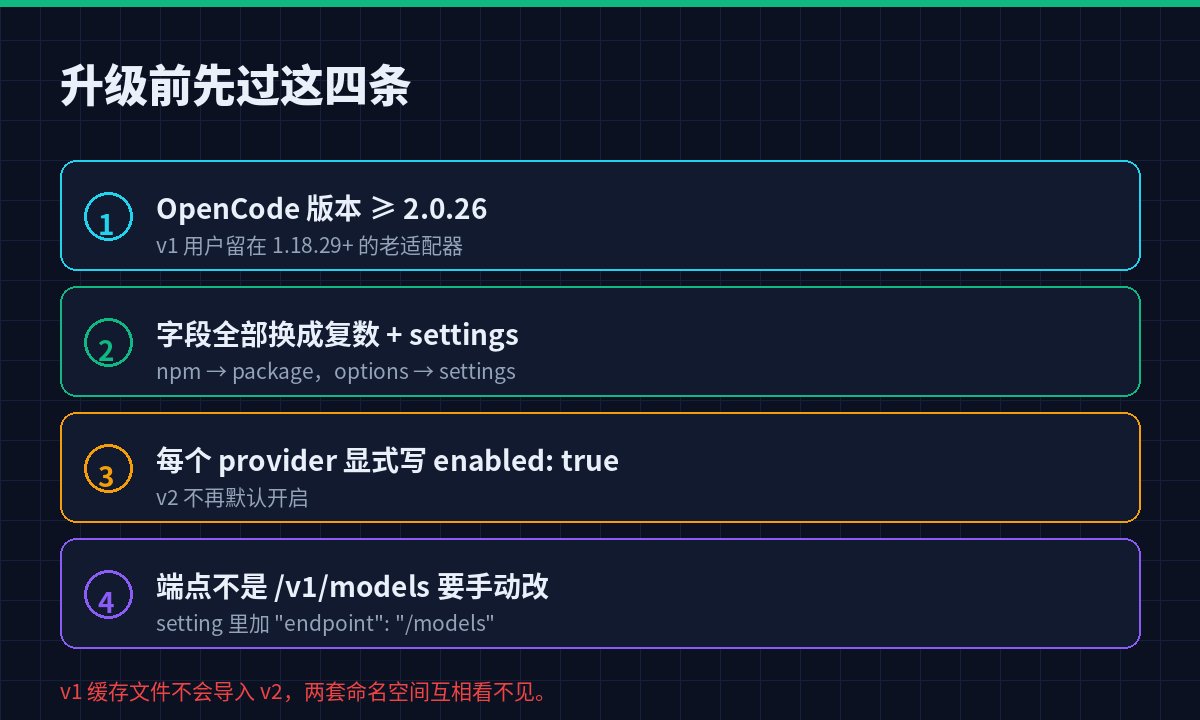
- OpenCode 版本:v2 要求 ≥ 2.0.26;留在 v1 的至少 1.18.29。
- 字段全换:复数 +
settings,npm→package,options→settings。 - 显式开启:每个要发现的 provider 都写
enabled: true。 - 端点核对:不是
/v1/models的,手动加endpoint。
另外两个容易忽略的:本地构建的话,package 要填 file:///绝对路径/dist,指向目录而不是 index.js,改完代码还得 opencode service restart 让后台服务加载新 bundle。第三个跟头我就是栽在这儿——改了半天代码没生效,因为服务根本没重启。
七、这东西值得装吗
看你的场景。
- 只用一个官方 API 的:不用装。模型列表就那几个,手写一次管一年,插件反而多一层。
- 接了中转站 / 聚合网关的:强烈建议。这类服务模型上得勤、名字乱、价格经常调,手动维护纯属自虐。
- 本地跑 LM Studio / vLLM / llama-swap 的:装上。这类服务模型是按需加载的,插件能把你实际加载了哪些、各自的
max_model_len是多少直接读出来,比你自己查配置快得多。 - 企业自建网关的:值得评估。九个格式里有
bifrost、omniroute这种专门面向网关的,另外includeBy/excludeBy支持按原始字段做正则和等值过滤,能把不该给普通用户看的模型直接挡在列表外。
至于 2.0.0 本身,发布说明里提到验证覆盖了 41 个测试文件、314 个测试,加上本地 OpenAI 兼容 HTTP 集成测试和编译产物校验。对于一个 188 星的项目来说,这个测试密度算认真的。
v1 还能用,但新东西都在 v2。想长期跟进的,早点把配置迁过去,别等到哪天 v1 适配器只剩安全补丁了再动手。
项目地址:github.com/yuhp/opencode-models-discovery,安装直接 npm i opencode-models-discovery@2.0.0 或者按上面的配置把包名写进 plugins,OpenCode 会自己解析加载。

itadol5j
暂无介绍....
延伸阅读:
76.2 万条微信全导出来喂给 AI:最难的压根不是 AI
76.2 万条消息、3675 万字、十年记录。导出、清洗、分块、向量化、混合检索,五步管道全流程,外加五个必踩的坑。还有...

opencode-models-discovery 2.0.0 发布:配置形状全换,OpenCode v2 正式转正
九种元数据格式、原生 /connect 凭证、宿主托管缓存。从 v1 迁到 v2 的配置字段对照和四条检查清单都在这里。
我蹲了半个月,Gemini 4 Argon 今天凌晨终于全球上线了
先说结果:Gemini 4 Argon 今天(10 月 13 日)凌晨正式全球开放了。我为了它前后蹲了半个月,中间踩了两...
REA 爆火后,Agent 时代软件的护城河不存在了?
先说一个可能不太受欢迎的判断:“代码写得复杂所以抄不走”这个护城河,确实塌了。但“软件没有护城河了”是个过度反应——塌掉...
SAST vs DAST vs IAST:安全测试三兄弟的互补而非替代
应用安全测试里最常见的三个缩写:SAST、DAST、IAST。很多人第一反应是“选一个最强的”,但这是个伪命题——这三兄...