我蹲了半个月,Gemini 4 Argon 今天凌晨终于全球上线了
先说结果:Gemini 4 Argon 今天(10 月 13 日)凌晨正式全球开放了。我为了它前后蹲了半个月,中间踩了两堵墙,都写在下边——顺便把它赢在哪、输在哪,用官方跑分表给你摆清楚。
第一堵墙:官宣不等于能用
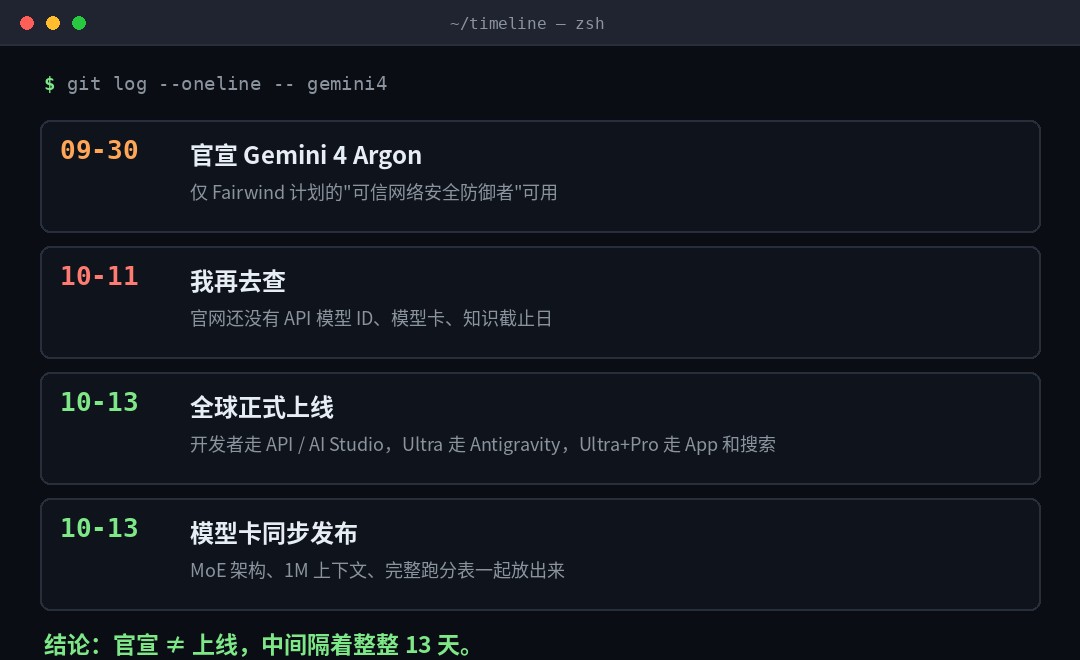
9 月 30 日,谷歌发了篇博客,宣布 Gemini 4 Argon——“我们面向真实世界编程、企业知识工作和网络防御的前沿模型”。标题很唬人,我当天就兴冲冲去看怎么用。
结果页面最后一行写着“rolling out soon”。Soon 了个寂寞。
再一查才知道,这次它是先给了 Fairwind 计划里的“可信网络安全防御者”,配合美国政府做发布前的安全评估。用产品负责人 Tulsee Doshi 的话说,这么做是为了“让一个在网络安全上训练得很强的模型,尽快交到防御者手里”。
普通开发者、普通用户?没门。
第二堵墙:过了 11 天,官网还是空的
到了 10 月 11 日我又去翻了一遍,官网依然没有 API 模型 ID、没有模型卡、没有知识截止日期。那几天网上已经传疯了“测出这个数”“碾压那个模型”,但一追源头,全是预测,不是官方数据。
这里我得说个判断:谷歌经常“提模型名”和“发布模型”是两回事。它在 7 月 21 日官宣一次训练时就点过 Gemini 4 的名字,那只是路线图信号,不是可用性信号。官宣和上线之间,是可以隔着很多天的。
这次隔了整整 13 天。
今天凌晨,三件事同时发生
10 月 13 日(也就是今天凌晨),谷歌一口气把该给的都给了:
- 模型卡发布(10 月 13 日)——架构、上下文、完整跑分表全摊开了;
- 全球开放——开发者、企业、消费者一起开闸;
- 访问路径分清——谁能用、从哪进,一次性说明白。
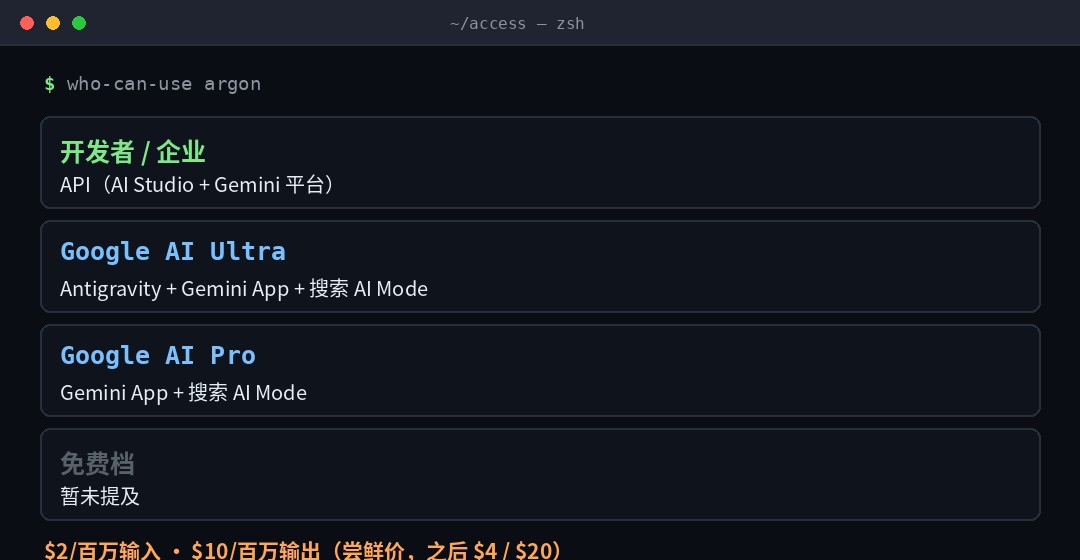
我把“谁能用”整理成一张表,直接抄:
| 你是谁 | 从哪进 |
|---|---|
| 开发者 / 企业 | API(AI Studio + Gemini 平台) |
| Google AI Ultra 订阅 | Antigravity + Gemini App + 搜索 AI Mode |
| Google AI Pro 订阅 | Gemini App + 搜索 AI Mode |
| 免费档 | 官方没提 |
价格也一并放出来了:尝鲜价 $2 / 百万输入 token、$10 / 百万输出 token,之后涨到 $4 / $20。想白嫖的,趁尝鲜期薅。
它到底是什么:先看硬参数
官方模型卡里几句话值得划重点:
- 它是全新前沿模型,不是老模型的微调或改版。这点很重要——不是“套壳升级”。
- 架构是大规模稀疏混合专家(MoE)+ Transformer,原生支持文本、视觉、音频输入。
- 上下文窗口:输入 + 输出合计最多 1M token。这是这一代最实在的升级之一。
- 训练用谷歌自家 TPU,跑 JAX + ML Pathways。
- 定位场景:多轮深度调查、复杂工程任务、深度视觉理解、网络安全防御、多模态文档分析、法律/金融/科学推理。
用一句话翻译:它是冲着“细活、深活、长活”去的,不是冲着“快”去的。
重头戏:跑分表,赢的输的都摆出来
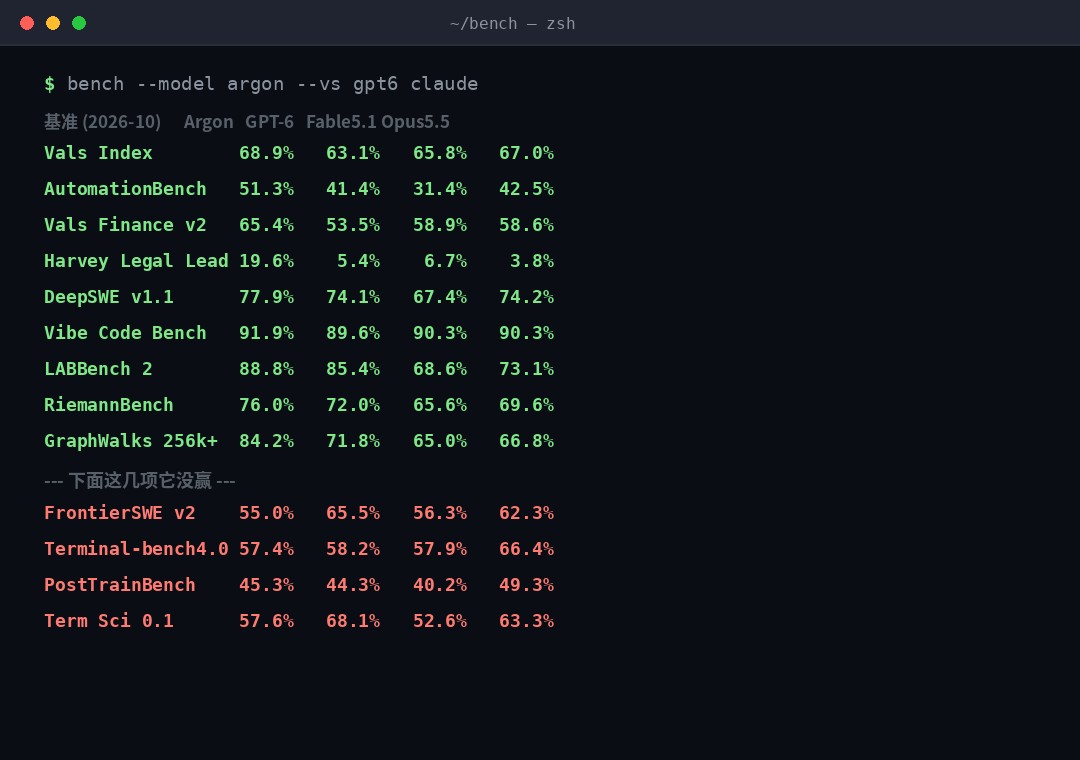
这是全文最该抄走的部分。以下是 Google DeepMind 模型卡里 2026 年 10 月的官方对比,对手是 GPT-6 Astra、Claude Fable 5.1、Claude Opus 5.5。
它赢的:
| 基准 | Argon | GPT-6 | Fable 5.1 | Opus 5.5 |
|---|---|---|---|---|
| Vals Index(知识工作) | 68.9% | 63.1% | 65.8% | 67.0% |
| AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% |
| Harvey 法律 Agent | 19.6% | 5.4% | 6.7% | 3.8% |
| DeepSWE v1.1(编码) | 77.9% | 74.1% | 67.4% | 74.2% |
| Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% |
| LABBench 2(科学) | 88.8% | 85.4% | 68.6% | 73.1% |
| RiemannBench(数学) | 76.0% | 72.0% | 65.6% | 69.6% |
| GraphWalks 256k~1M | 84.2% | 71.8% | 65.0% | 66.8% |
它没赢的(同样是官方数字,别装看不见):
| 基准 | Argon | GPT-6 | Fable 5.1 | Opus 5.5 |
|---|---|---|---|---|
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% |
| Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% |
| PostTrainBench(ML工程) | 45.3% | 44.3% | 40.2% | 49.3% |
| Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% |
| OSWorld-2.0(电脑操作) | 69.2% | 72.6% | — | — |
网络安全那项,它和 GPT-6、Grok 4.7 并列第一(CWE-bench v1 都是 68.0%)。
我的实测感受(说人话版)
真本事的三个方向:
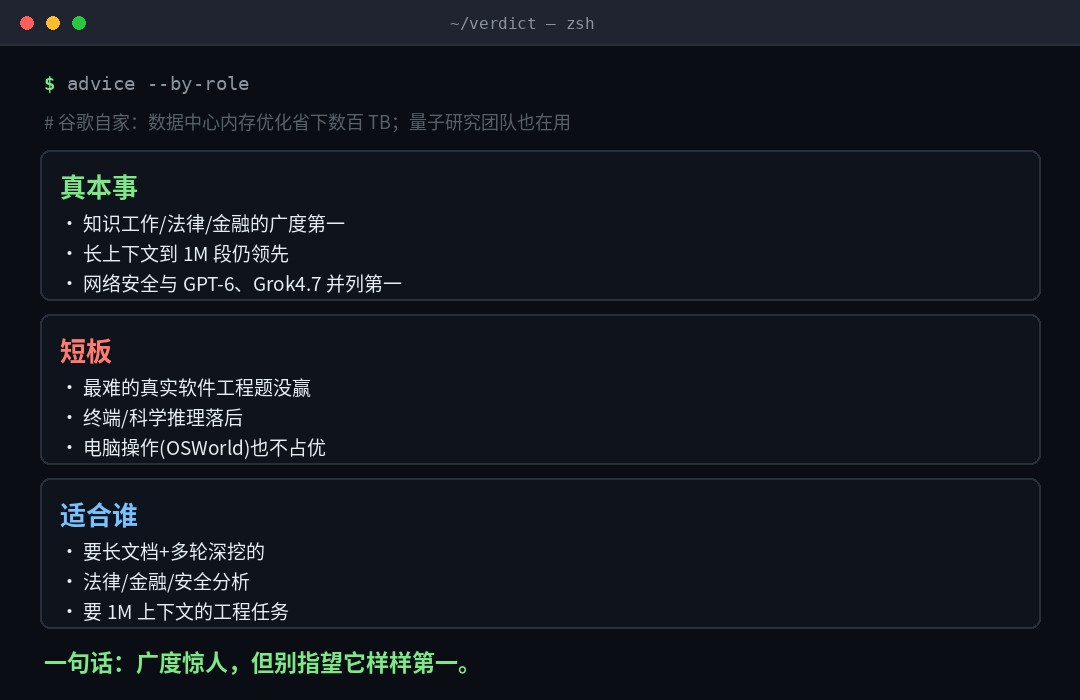
- 知识工作的广度是真的。Vals Index、金融、法律这几项领先幅度不小——尤其是 Harvey 法律 Agent,19.6% 对 5.4%,几乎是碾压。做法律/金融分析的,这个提升是能摸到的。
- 长上下文是真稳。GraphWalks 从 256k 一路到 1M 那段,84.2% 对 GPT-6 的 71.8%,差距明显。要喂几百页文档做多轮深挖的,这代是真能扛。
- 多模态文档分析很强。Chartography 71.6%、LVBench 91.7%,图表理解这块是它的舒适区。
短板也很清楚:
- 最硬的真实软件工程题它没赢。FrontierSWE v2 落后 GPT-6 十个百分点——“写代码”和“打硬仗式软件工程”是两回事。
- 终端、科学推理、电脑操作都不占优。要跑 shell 任务、要控浏览器点来点去的,目前还是别人更强。
- 别被“综合第一”的话术骗了。它是“广度惊人”,不是“样样第一”。
落到你身上:分角色建议
如果你是开发者
- 想试的,今天就能从 AI Studio / API 进,尝鲜价 $2/$10;
- 但它不是 DeepSWE 那种硬核工程任务的答案——真跑复杂软件工程,先把 FrontierSWE 那栏的差距放心里;
- 1M 上下文是它最值得试的点,喂长文档、大仓代码库的活,优先上它。
如果你是法律 / 金融 / 安全从业者
- 这代对你是实打实的升级:法律 Agent、金融 Agent、网络安全三项都在第一梯队;
- 网络安全那块和 GPT-6 并列第一,配合它首发给网络安全伙伴的动作看,谷歌在安全场景是认真押注的。
如果你就想尝个鲜
- Google AI Ultra 走 Antigravity,Ultra / Pro 订阅在 Gemini App 和搜索 AI Mode 里就能摸到;
- 免费档暂时没提,想第一时间用,得先有个付费入口。
最后
谷歌内部已经拿它在自家数据中心做内存优化,说是“没买新硬件就省出几百 TB 内存”,量子计算研究团队也在用。这种“先自用再外放”的路子,比任何跑分都更能说明它的分量。
但记住今天这两堵墙:官宣 ≠ 可用,综合第一 ≠ 样样第一。蹲了半个月换来的教训就这两句——其他的,跑分表都写着,自己看。
官宣 ≠ 可用,综合第一 ≠ 样样第一

itadol5j
暂无介绍....
没有啦 (T▽T)
延伸阅读:
我蹲了半个月,Gemini 4 Argon 今天凌晨终于全球上线了
先说结果:Gemini 4 Argon 今天(10 月 13 日)凌晨正式全球开放了。我为了它前后蹲了半个月,中间踩了两...

REA 爆火后,Agent 时代软件的护城河不存在了?
先说一个可能不太受欢迎的判断:“代码写得复杂所以抄不走”这个护城河,确实塌了。但“软件没有护城河了”是个过度反应——塌掉...
SAST vs DAST vs IAST:安全测试三兄弟的互补而非替代
应用安全测试里最常见的三个缩写:SAST、DAST、IAST。很多人第一反应是“选一个最强的”,但这是个伪命题——这三兄...
为什么现在还要搭建个人网站(Blog)
现在做内容的人,绝大多数把精力放在公众号、抖音、小红书、B 站上。这些平台流量大、见效快,看起来是“更划算”的选择。于是...
逆向一切软件:REA 冲上 GitHub 5.8 万 Star,agent 把逆向变成了提问
GitHub 最近又火了一个项目:REA(Reverse Engineer Anything)。用户丢过来的说法是“冲到...