Kimi K3.1 没有「移除攻击能力」,它只是把天花板削掉了 10%
先说结论:这次没有任何「移除攻击能力」这回事,也没有任何「天才渗透测试工程师要陨落」的迹象。
月之暗面做的事,说人话就是:他们发现训练数据里混进了不少安全攻防内容,于是在 mid-training 和 RL 两个阶段把这些数据挑出来删了。
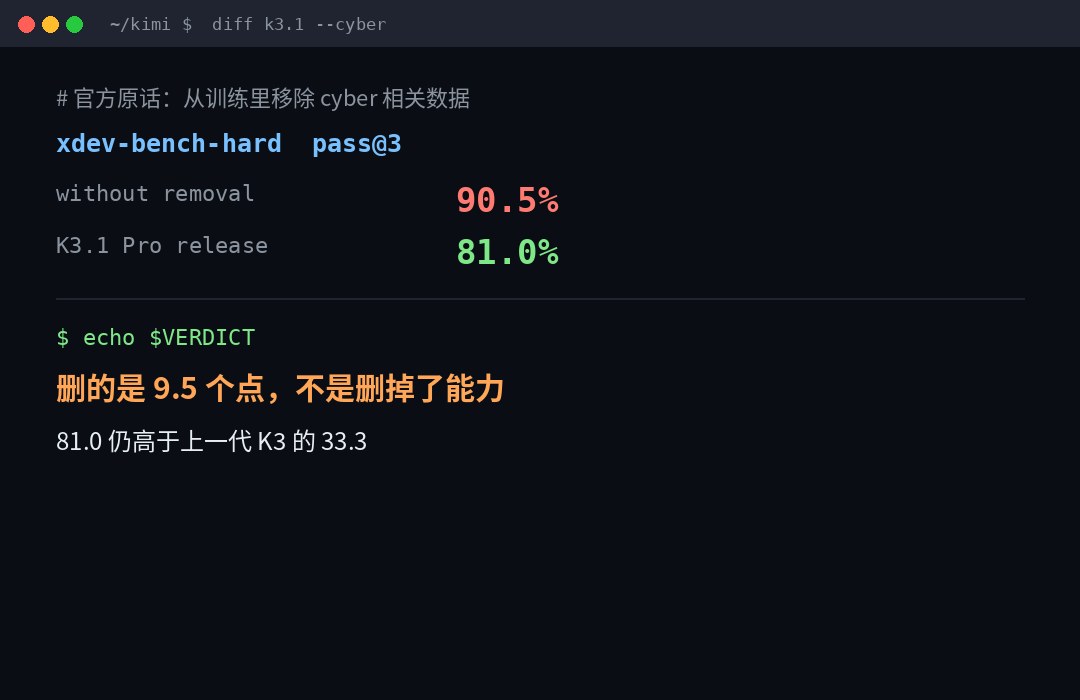
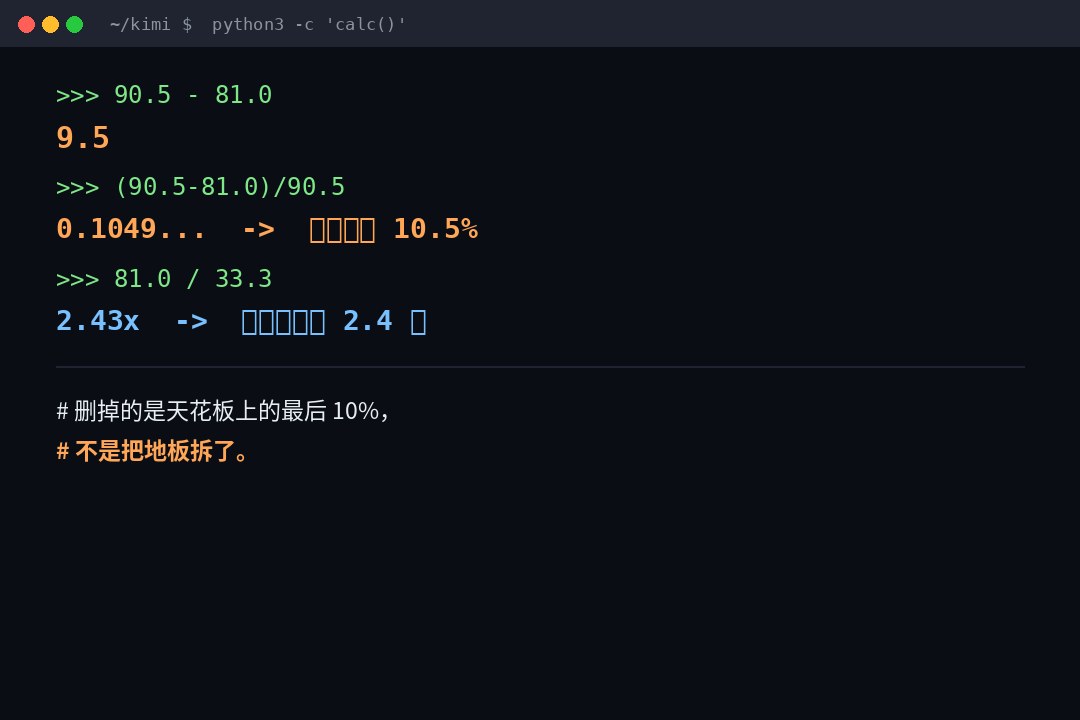
删完之后,他们自己的内部渗透基准从 90.5% 掉到 81.0%。
掉了 9.5 个点。相对下降 10.5%。
然后呢?81.0% 仍然比他们上一代 K3 的 33.3% 高 2.4 倍。
所以「移除攻击能力」这个说法,跟「因为考了 95 分退步到 90 分所以这个人变笨了」是一个逻辑水平。
一、先看清「移除」这两个字到底删了什么
网上的转述基本都停在「Kimi 移除了攻击能力」这一句。官方原文其实写得很具体,我逐句拆:
第一步,他们发现能力是从哪来的。
原话说:随着后训练规模扩大,漏洞研究能力在稳定提升。追溯来源发现——cyber 相关内容嵌在通用的 mid-training 语料里,cyber 相关任务也在 RL 环境混合里。 官方用了一个很坦白的措辞:「这是在大范围数据上训练的自然副产物」。
第二步,他们做了对照实验。
在内部模型上验证:如果 mid-training 和 RL 阶段都不做数据移除,下游 cyber 能力会显著上升。
第三步,他们对开源版本这么做了。
原话:「For the open-weight release of K3.1 Pro, we identified and removed cyber-related data from both training stages, while retaining the general-purpose coding tasks needed for model usefulness.」
注意最后半句——「保留了模型有用性所需的通用编程任务」。
这半句是全文最关键的定语。他们删的是「专门指向攻防的数据」,不是「所有跟代码、跟系统、跟漏洞有关的知识」。 后者删了模型就废了,因为漏洞本身就是代码缺陷。
所以准确的说法是:不是移除攻击能力,是移除「指向攻击」的训练偏向。
这两件事差多远?看下一节。
二、90.5 是个从没发布过的数字
这个细节几乎所有转述都漏了。
xdev-bench-hard 上那个 90.5%,是「不做 cyber 数据移除的同一套训练管线」跑出来的检查点。
这个检查点从来没发布过。 它不是上一代产品,不是某个公开版本,是一个只存在于内部对照实验里的假设产物。
也就是说,这次对比的本质是:
「我们本可以做到 90.5,但我们选择发布 81.0。」
这是一次自我约束的公开说明,不是一次能力退化的事故报告。
把这两件事混为一谈,是这一轮传播里最大的失真。
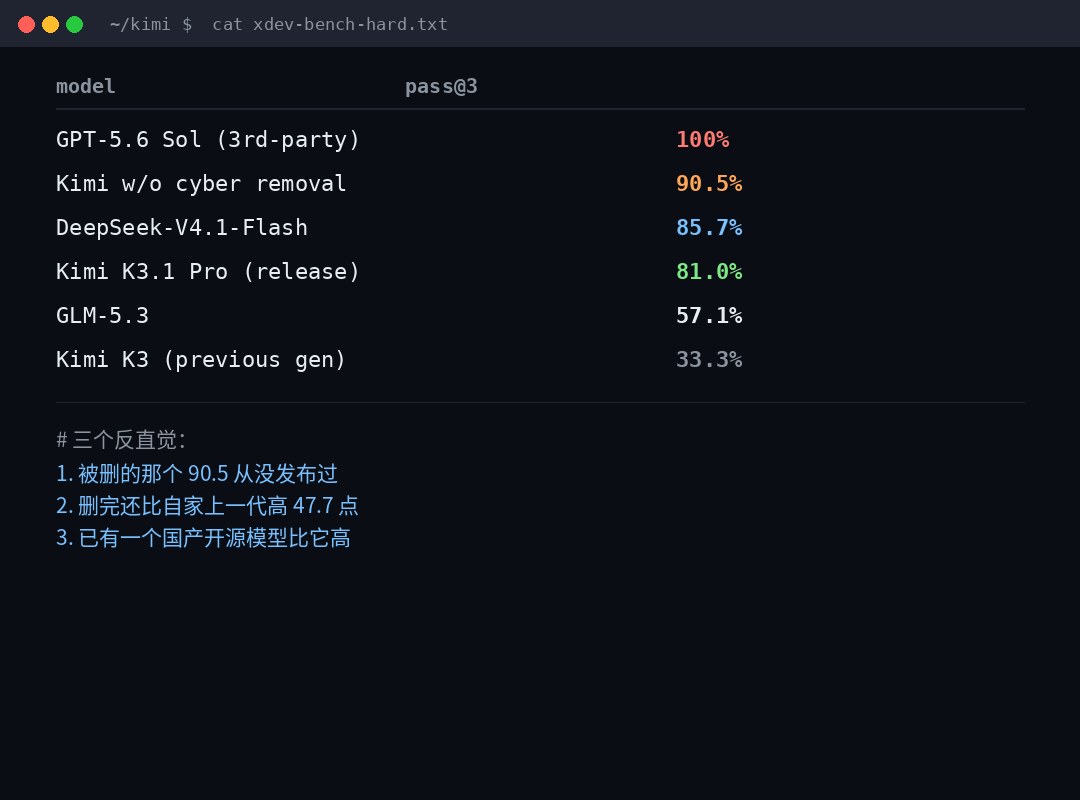
完整的榜长这样:
| 模型 | xdev-bench-hard (pass@3) |
|---|---|
| GPT-5.6 Sol(第三方评测) | 100% |
| Kimi(不做 cyber 数据移除的检查点) | 90.5% |
| DeepSeek-V4.1-Flash | 85.7% |
| Kimi K3.1 Pro(实际发布版) | 81.0% |
| GLM-5.3 | 57.1% |
| Kimi K3(上一代) | 33.3% |
这张表里有三个反直觉的事实,我一条条说。
三、三个被忽略的事实,每一个都推翻一个流行说法
事实一:被「删掉」的那个 90.5,你从来就下载不到。
所以你并没有「失去了」什么。你只是知道了「他们本来能做到更多,但选择不做」。
这是安全声明,不是能力损失。
事实二:删完之后,它比自家上一代强 2.4 倍。
81.0 对 33.3。这个数字放在标题里,整件事的叙事就完全反过来了——
不是「Kimi 变弱了」,是「Kimi 变强了,但没有强到自己能强到的那个位置」。
事实三:已经有一个国产开源模型比它高。
DeepSeek-V4.1-Flash,85.7%。
所以「其他国模也将会移除攻击能力」这个推论,从事实层面就不成立——榜单上摆着一个比它高 4.7 个点的国产模型。
你要说趋势,趋势是:头部闭源模型已经 100%,国产开源在 81 到 86 之间横着,大家都在同一个量级里挤。
这跟「集体阉割」是两幅完全不同的画面。
四、这道基准测的到底是什么(以及它测不到什么)
这一段是我最想让人看完的。
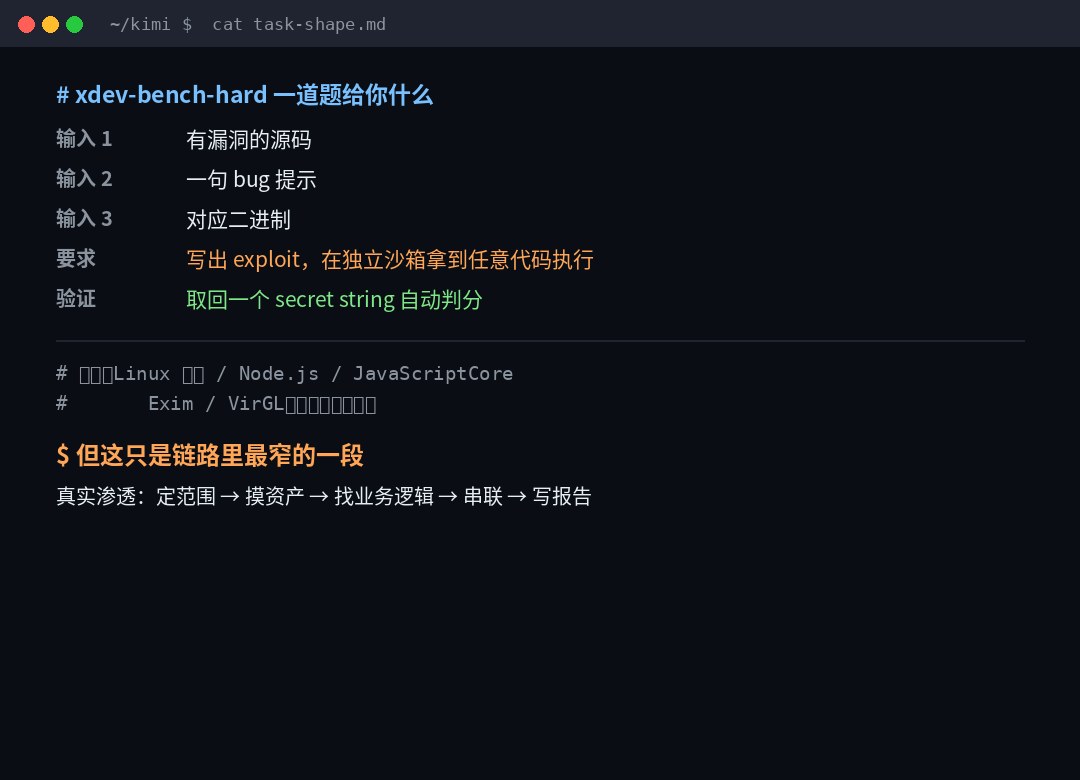
xdev-bench-hard 一道题给你三样东西:
- 有漏洞的源码
- 一句 bug 提示
- 对应的二进制
要求是:写出 exploit,在独立沙箱里拿到任意代码执行,取回一个 secret string 用于自动判分。
题源是 Linux 内核、Node.js、JavaScriptCore、Exim、VirGL 这些真实软件里最近披露的漏洞,而且全部开启了缓解措施。
这玩意儿难不难?难。开缓解措施之后的利用是真的硬活。
但它的形状,跟真实渗透完全不是一回事。
真实的一次渗透长这样:
定范围 → 摸资产 → 找入口 → 挖业务逻辑漏洞 → 横向移动 → 提权 → 拿证据 → 写报告 → 跟客户解释
而 xdev-bench-hard 只覆盖了中间偏右的一小段:「已知这里有洞,把它打下来」。
真正花钱的地方,在前面那几步——
- 客户的资产清单本身是错的,你得自己去对
- 一个「看起来无害」的内部工具,其实是权限枢纽
- 业务逻辑漏洞没有 CVE,没有提示,没有二进制,只有一段让你觉得「这流程怎么这么怪」的直觉
- 打进去了,还得证明影响面,写成甲方看得懂的报告
这些,一个基准都测不出来。
所以当有人说「AI 把渗透测试工程师替掉了」,我的问题是:替掉的是哪一段?
如果指的是「给定漏洞提示后写 exploit」这一段——那确实,AI 已经比大多数人快。这件事两三年前就发生了。
如果指的是「面对一个陌生的、资产不清、边界模糊的真实系统,找出最值得打的那个点」——离得还远。
五、为什么这次「自我阉割」在工程上说得通
抛开情绪,从纯工程角度看,月之暗面这个决定其实很理性。
第一,开源权重是不可撤销的。
一个闭源模型发现能力过强,可以加个护栏、限个号、封个 API。而开源权重一旦放出去,全世界都能下载,永远收不回来。
所以对开源模型,唯一能做的风险控制时机,就是放出去之前。
第二,他们的目标写得很明确。
原话第一条:「我们不打算发布会拓展 cyber 能力绝对前沿的开源权重。」
注意这个措辞——「绝对前沿」。不是「不发布有攻击能力的模型」,是「不发布那个把行业天花板往上顶的模型」。
这两条线的差别巨大。前者等于自废武功,后者只是不当出头鸟。
第三,他们同时承诺了相反方向的事。
原话第二条:「我们打算逐步提高开源权重里可用的 cyber 能力。」
第三条解释了理由:让需要双用途能力的人能用于防御。一个能力强的模型开源、跑在用户自己控制的基础设施上,能让更多团队去审计自己维护的代码——包括那些几乎从没做过专门安全评审的遗留系统。
这段话不是公关辞令。遗留系统的安全债,是中文互联网最真实的痛点之一。 给防守方一个能在内网自跑的审计工具,收益是实打实的。
所以这不是「阉割」,是「限速」。 方向还是往前,只是踩了一脚刹车。
六、真正该担心的不是能力被删,是三件事
如果我是安全从业者,看完这份公告,我担心的不是「模型变笨了」。
我担心的是这三件事:
① 掐尖效应。
开源模型的能力上限,会长期被压在「当前前沿闭源模型三个月前的水平」之下。
官方原话:「K3.1 Pro 的 cyber 能力仍然落后于那些已经公开可用至少三个月的前沿闭源模型。」
这个「至少三个月」不是随口说的,它是刻意留出的时间差。
对防守方意味着什么?意味着你能拿到的最强开源工具,永远比攻击者能用钱买到的最强工具慢三个月。
这个差距不会因为某一家厂商的选择而消失,它就是这个阶段的常态。
② 数据来源的透明性崩塌。
这次公告最有价值的部分,其实不是那个 81.0,而是它承认了 cyber 能力来自「通用语料的自然副产物」。
翻译:你想训一个会打漏洞的模型,不需要专门喂攻防数据,喂够多的代码和系统知识,它自己就会了。
这意味着「移除数据」这条路,长期看是逆着物理规律在走。你删掉显式的攻防语料,通用代码能力照样会外溢到攻击能力上——榜单里 81.0 这个数字本身就是证据。
③ 基准和现实的裂缝会越来越大。
厂商会持续迭代内部基准(官方明说要「keep evolving our internal benchmarks」),因为现有基准一旦被刷满就失去区分度。
但基准越精细,离真实场景就越远。真实的渗透没有「一句 bug 提示」,没有「对应的二进制」,没有「取回 secret string 就判分」。
所以基准分数会越来越高,而「能替你干完一个真实项目」的模型,出现得会比你预期的晚。
七、回到那个问题:渗透测试工程师会陨落吗
不会。但工作内容会重新分配,而且已经在发生了。
我的判断分三档:
会被替掉的:
- 给定漏洞信息后写 PoC / exploit
- 大批量代码的静态审计第一遍
- 重复性的配置核查、基线检查
- 报告里那些「复制粘贴改个客户名」的部分
不会被替掉的:
- 判断「这个系统最值得打哪里」——这需要业务理解和取舍
- 在资产清单本身是错的情况下,重新建立资产认知
- 跟甲方沟通「这个风险你到底要不要修」——这是政治,不是技术
- 承担责任。出了事,签字的是人。
会被放大的:
- 一个人 + 一堆 agent,能覆盖过去一个团队的广度
- 关键是你能不能把 agent 的产出验证掉。验证能力,会变成新的核心技能。
所以「天才渗透测试工程师将陨落」这个说法,真正的问题不在预测,在于它把渗透测试理解成了「写 exploit」。
那个理解,在 AI 出现之前就已经过时了。
八、顺手把这模型的真实参数给你
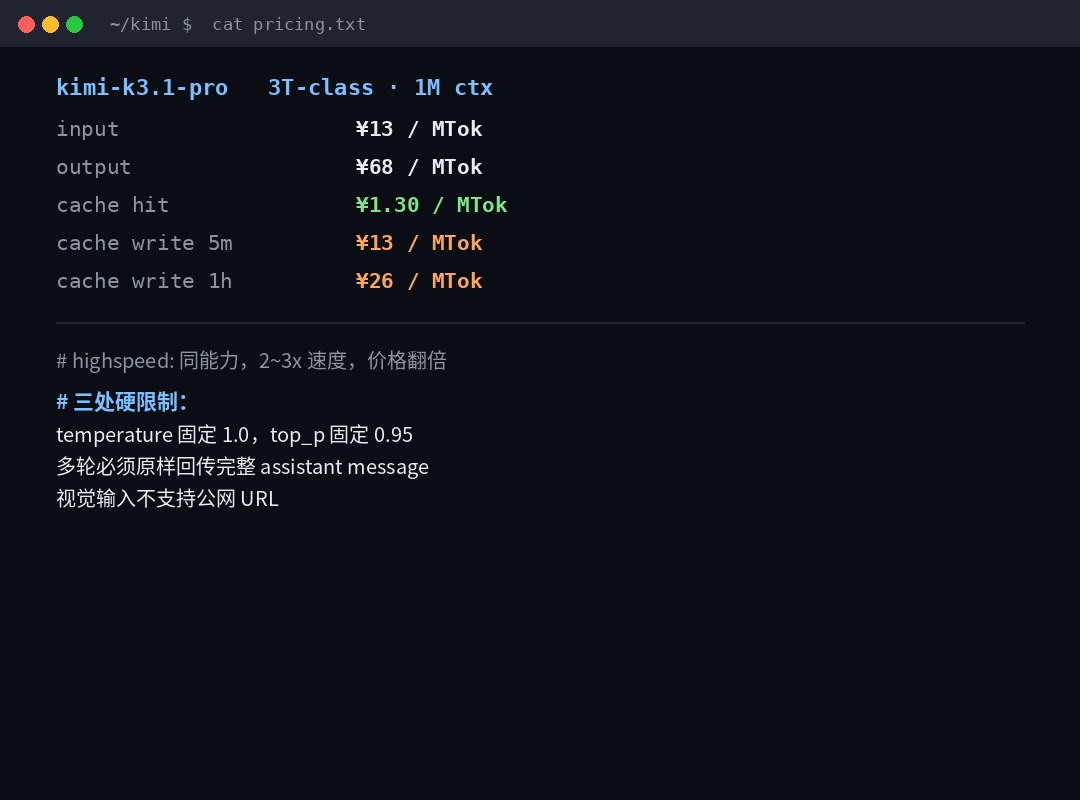
既然是聊这个模型,几个实际用得上的数字一并列出来:
| 项目 | Kimi K3.1 Pro |
|---|---|
| 参数 | 3 万亿级(上一代 K3 是 2.8T) |
| 上下文 | 1M(1,048,576 tokens) |
| 输入价 | ¥13 / 百万 token |
| 输出价 | ¥68 / 百万 token |
| 缓存命中 | ¥1.30 / 百万 token |
| 缓存写入 5 分钟 | ¥13 / 百万 token |
| 缓存写入 1 小时 | ¥26 / 百万 token |
| 高速版 | 同能力,2~3 倍速度,价格翻倍(¥26 / ¥136) |
| 权重发布 | 11 月 4 日前 |
顺手算一笔:输出价是输入价的 5.2 倍,缓存命中是输入价的 1/10。这是标准的「长上下文 + 缓存优先」定价结构——你的 system prompt 越长、越稳定,省钱空间越大。
还有三处硬限制,踩过的人会疼:
temperature固定1.0、top_p固定0.95,传别的值会报错- 多轮对话必须原样回传完整的 assistant message,包括
reasoning_content。漏了就开始胡说 - 视觉输入不支持公网图片 URL,只能 base64 或
ms://
最后一条我猜很多人会踩:你把一个图片链接丢给它,它不会去下载,直接报错。
最后
这次公告里,我认为最值得记住的不是 81.0,也不是 90.5。
是那句话:「我们打算逐步提高开源权重里可用的 cyber 能力。」
因为这句话承认了一个前提——能力是可以被调节的,而不是只能被放开或封死。
过去两年,行业在这件事上只有两个姿势:要么全开,要么全拒。Kimi 这次给出了第三个姿势:开,但限速,并且公开说明限了多少。
你可以不同意这个速度。但至少它把刻度盘摆在了台面上,还告诉了你刻度在哪。
比那些一句话不说、悄悄在 RLHF 里加一层拒绝的厂商,诚实得多。
至于「天才渗透测试工程师」——他们不会陨落。
会陨落的,是那些过去十年里只会「照着扫描器报告改 payload」的人。这件事在 AI 出现之前就已经在发生了,AI 只是把时间表提前了两年。

itadol5j
暂无介绍....
延伸阅读:
Kimi K3.1 没有「移除攻击能力」,它只是把天花板削掉了 10%
Kimi K3.1 没有移除攻击能力。官方删的是训练数据里指向攻防的语料,内部基准 90.5 掉到 81.0——而 90...

一份积分,五个产品:WorkBuddy 的 Buddy One 到底统一了什么(附接入教程与提示词)
Buddy One 统一的不是五个 App,是一份账:积分、1TB 存储、会员身份三层合并。官方文档里四处会真金白银卡住...
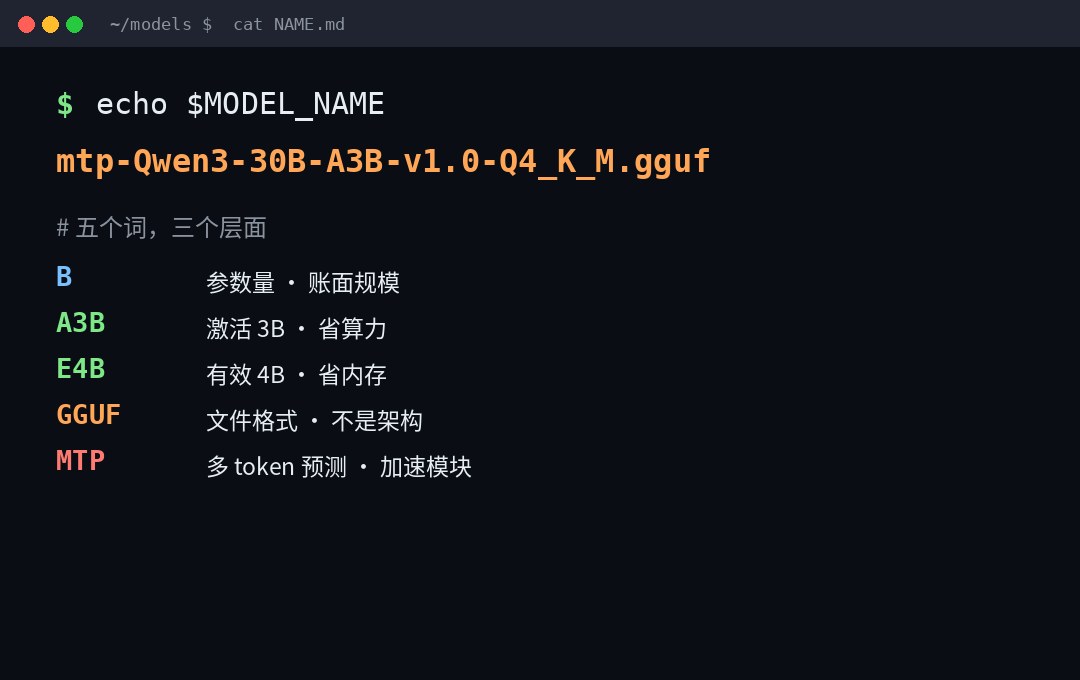
B、GGUF、MTP、A3B、E4B:模型名里这五个字符,说的不是一件事
B 是量词,A3B 和 E4B 是「哪一种量」,GGUF 是容器,MTP 是插件。同一个 B 有三种含义(总参数/激活参...
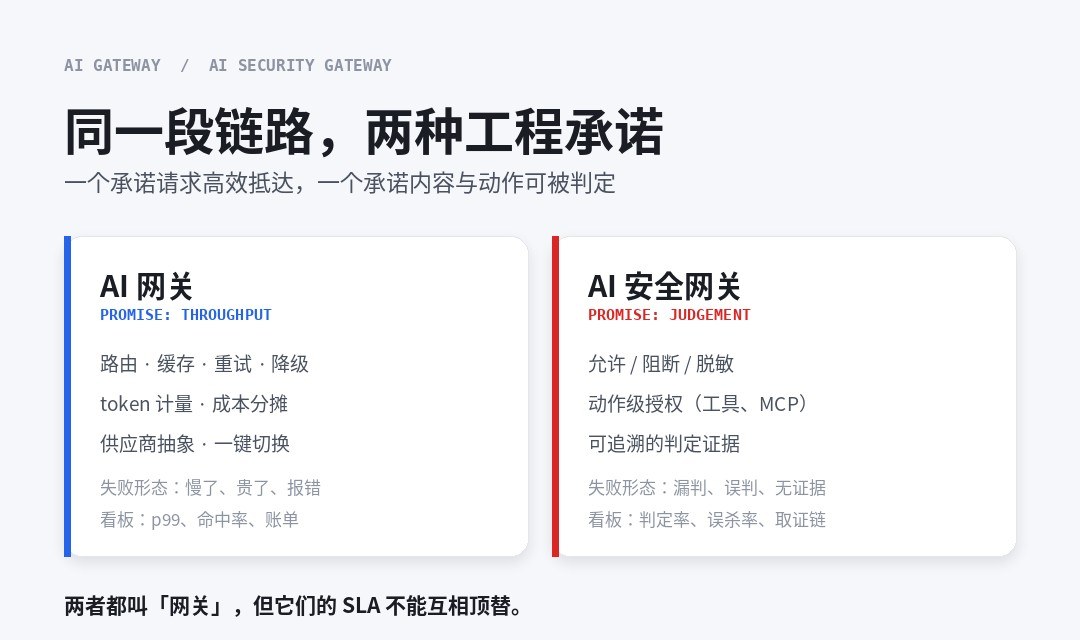
AI 网关与 AI 安全网关:同一段链路上的两种承诺,为什么不能合并成一个组件
都插在应用和模型之间,都叫「统一入口」,但一个承诺高效抵达,一个承诺可判定可追溯。三处结构性冲突全部有厂商文档原文佐证:...
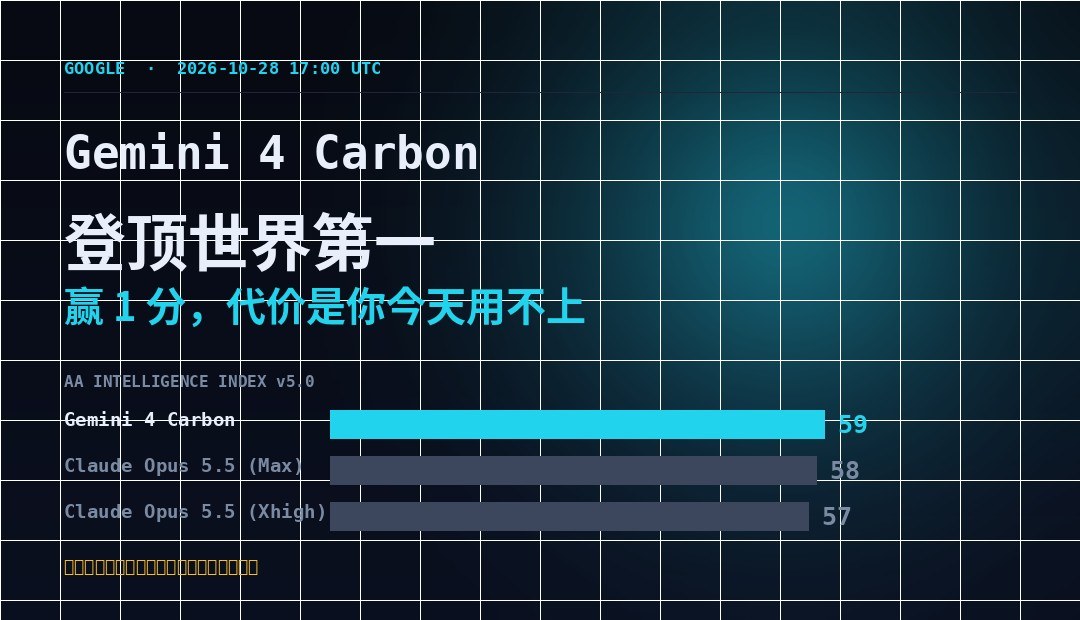
Gemini 4 Carbon 让谷歌重回第一:赢 1 分,而且你今天用不上
AA Intelligence Index v5.0 上 59 分排第一,第二名 58、第三名 57——但第二第三是同一...