AI 网关与 AI 安全网关:同一段链路上的两种承诺,为什么不能合并成一个组件
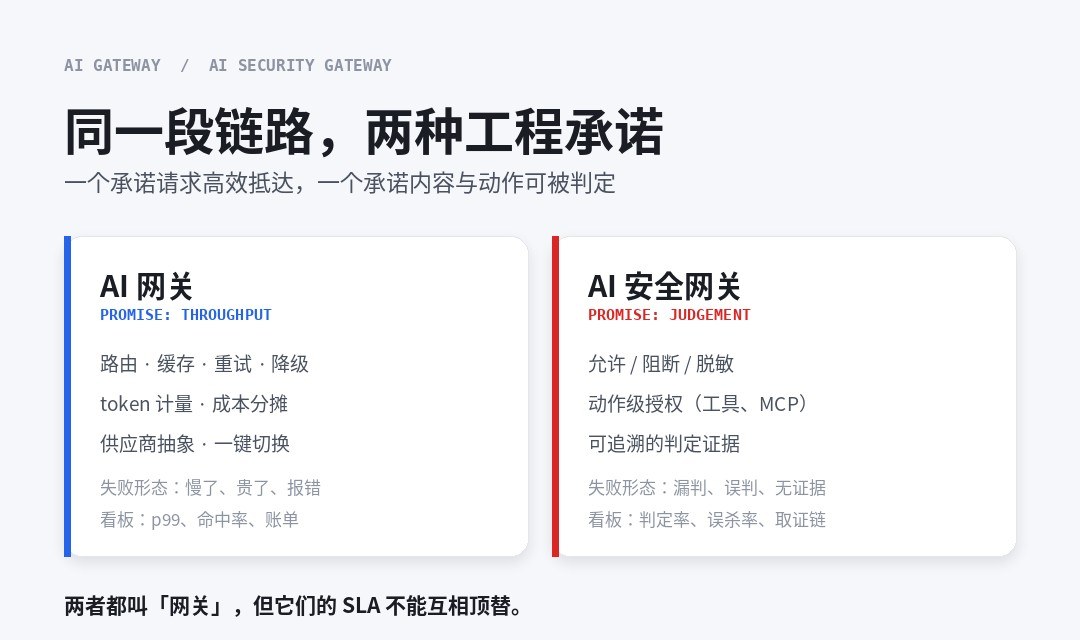
先说清楚这篇文章要解决的问题。这两类产品在 PPT 上长得几乎一样:都插在应用和模型之间,都画在同一个位置,都声称「统一入口」。所以采购时最常见的错误不是选错了产品,是把两种承诺当成一种,以为买了一个就有两个。
它们确实跑在同一段链路上。但承诺的东西完全不同:一个承诺请求高效抵达,一个承诺内容与动作可被判定、阻断与追溯。前者失败了是「慢了、贵了、报错」,后者失败了是「放过了一个不该放的」——而第二种失败,你的监控通常不会报警。
下面不按功能清单对比,按三处结构性冲突来拆。这三处冲突不是我编的,是两家厂商的官方文档里自己写出来的。
一、四个词,先分开
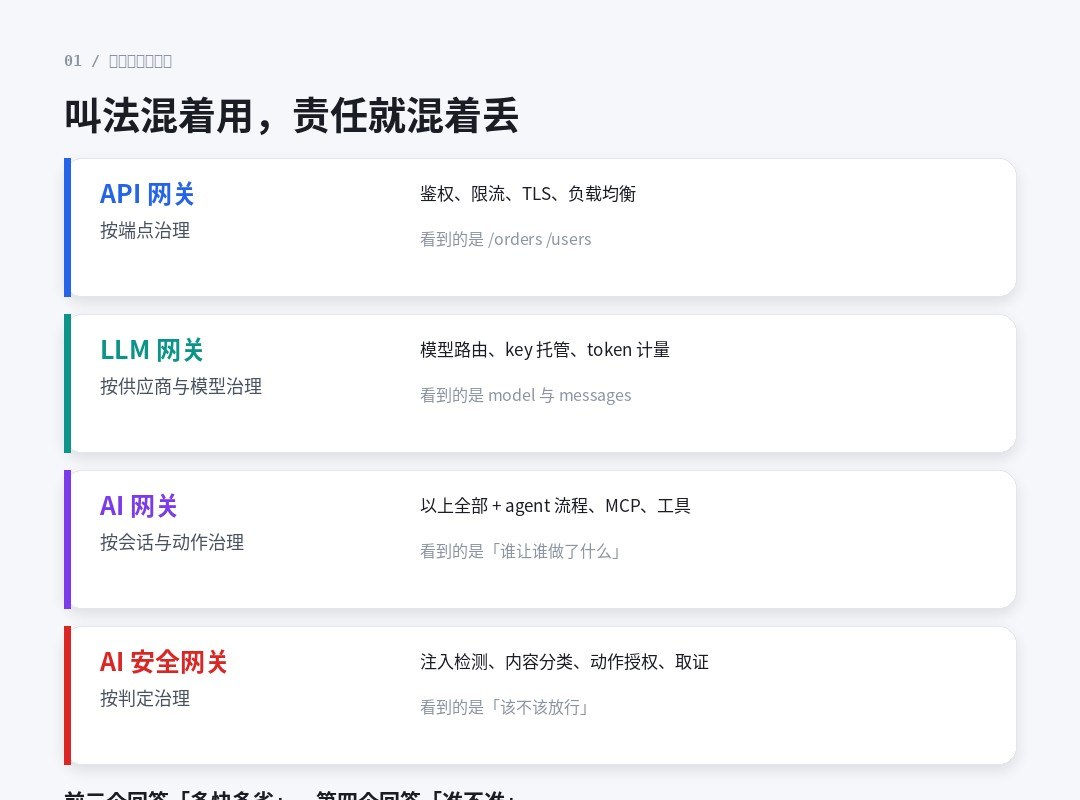
这一行的名词已经通胀到没法直接用了。API 网关、LLM 网关、AI 网关、AI 安全网关,经常在同一个方案里混着出现,而写方案的人自己也不一定分得清。
| 名称 | 治理的对象 | 典型能力 | 它「看见」什么 |
|---|---|---|---|
| API 网关 | 按端点 | 鉴权、限流、TLS 终止、负载均衡、转发 | /orders、/users |
| LLM 网关 | 按供应商与模型 | 模型路由、key 托管、token 计量、流式格式转换 | model 字段与 messages 数组 |
| AI 网关 | 按会话与动作 | 以上全部 + agent 工作流、MCP、工具调用、成本归集 | 谁让谁做了什么 |
| AI 安全网关 | 按判定 | 注入检测、内容分类、动作授权、取证留痕 | 该不该放行 |
这张表里最关键的一列是最后一列。前三行看的是「请求长什么样」,第四行看的是「这个请求该不该被允许」。前者是转发问题,后者是判断问题。转发可以做到 99.99% 可用,判断做不到——因为判断本身就有误判率。
API7 那篇对比文章里有句话说得挺准:真正的区别不在谁更「正确」,而在它们被设计来理解哪种流量。传统 API 流量是端点式的,LLM 流量是模型与 token 式的,agentic 流量是「一次用户请求触发多次模型调用、MCP 工具调用、内部 API 调用、检索和业务动作」。层级越往下,能看见的东西越多,责任也越重。
二、冲突一:缓存会绕过判定
这是我认为最值得写的一条,因为它是结构性的,不是实现缺陷。
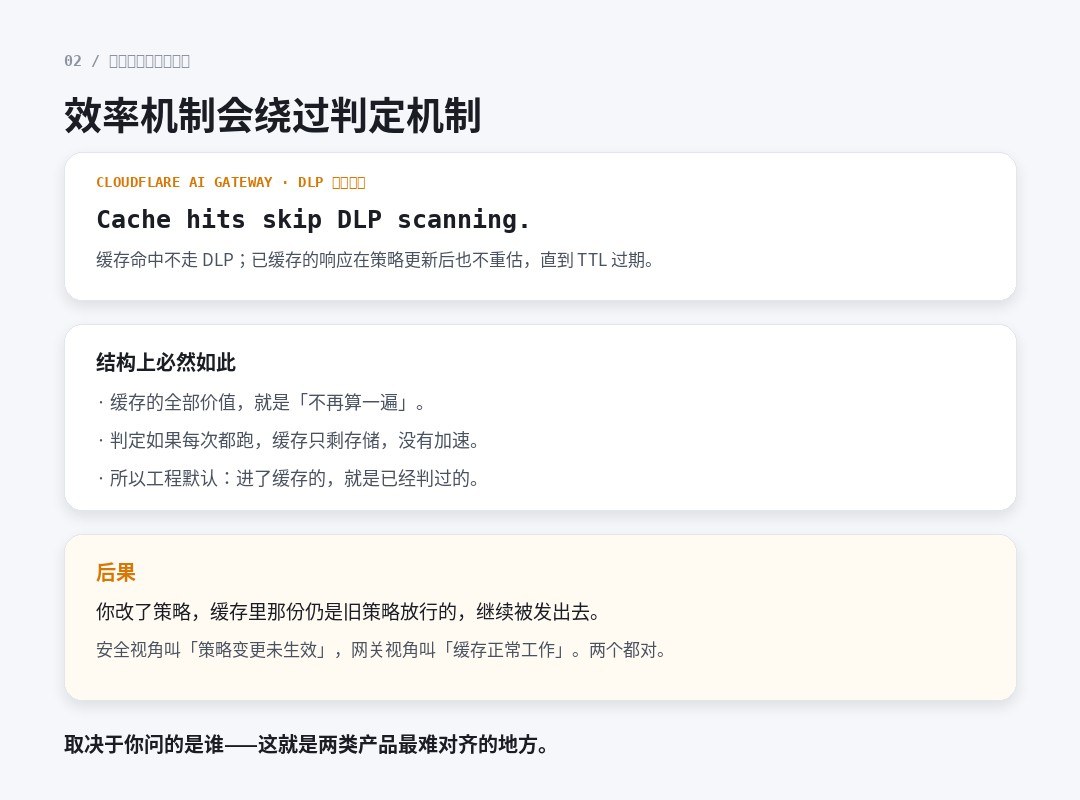
Cloudflare 的 AI Gateway DLP 文档里有一句原话,很短:
Cache hits skip DLP scanning.跟着还有一句更要紧的:如果你在响应被缓存之后更新了 DLP 策略,那份缓存不会被重新评估,它会继续被发出去,直到 TTL 过期。
为什么会这样?因为不难理解:缓存的全部价值就是「不再算一遍」。如果每次命中都要重新跑一遍判定,缓存就只剩存储,没有加速了。所以在工程上,「进了缓存 = 已经判过」是一个必然的默认假设。
这个假设在性能语境下完全成立,在安全语境下有一个洞:策略是会变的。你今天加了一条规则,昨天缓存的响应不受影响。安全团队管这个叫「策略变更未生效」,网关团队管这个叫「缓存正常工作」。两个说法都对,取决于你问的是谁。
Cloudflare 的处理算是比较老实的:Flag 的响应照常进缓存,Block 的响应不进。但它同时承认了策略更新后的重估缺口。要消掉这个缺口,只能缩短 TTL,而缩短 TTL 又直接削弱缓存的价值——这是一对天生的矛盾,没有两全的配置。
三、冲突二:流式与判定不能同时满足
第二个冲突更直观,而且直接体现在用户能感知的延迟上。
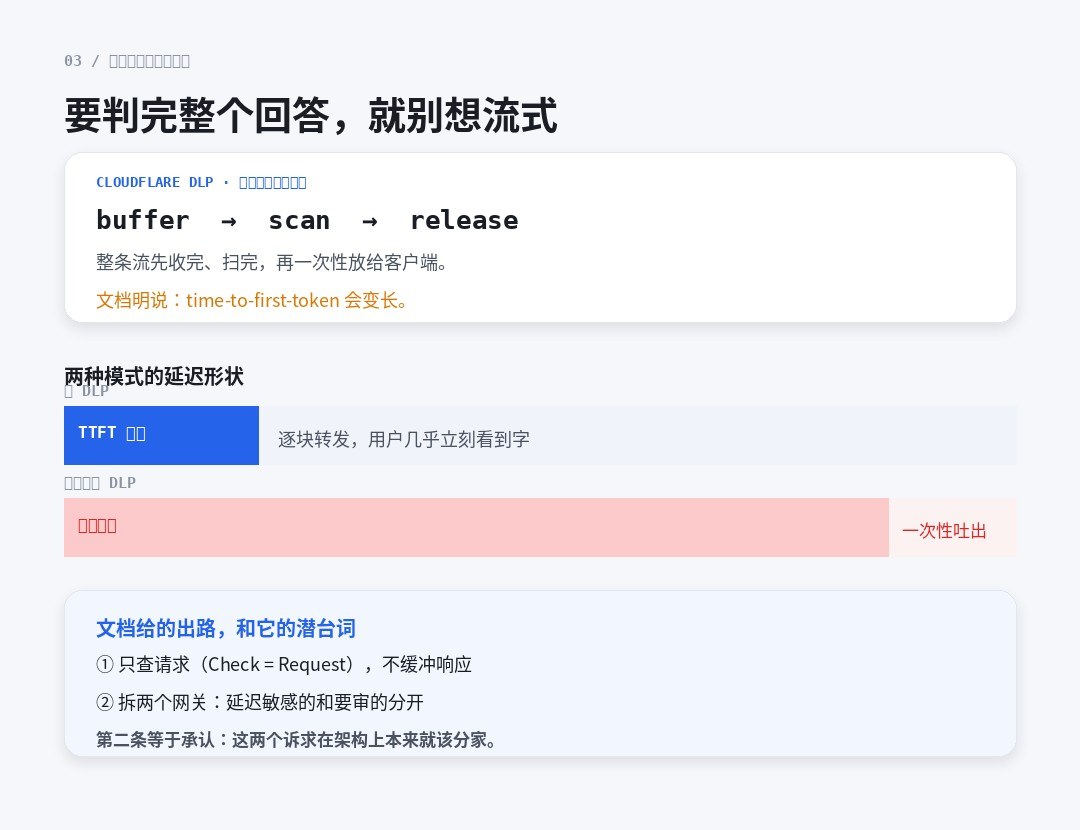
Cloudflare 的 DLP 文档写得很清楚:开了响应侧扫描,遇到 SSE 流式请求时,网关会把整条响应缓冲完、扫完,再一次性放给客户端,文档里明确提示 time-to-first-token 会变长。
这就是「缓冲」这个动作的代价。你要判定一整段内容,就必须先拿到一整段内容。而流式的全部意义,就是不必等一整段。两者在物理上冲突。
文档给了两条出路,我觉得第二条才是真话:
- 只查请求(Check 设为 Request),响应侧不做缓冲扫描——请求侧不缓冲,对延迟没有影响。
- 拆两个网关:延迟敏感的流量走一个,需要审的流量走另一个。
第二条等于承认了一件事:「快」和「可审」在架构上本来就该分家。硬塞进同一个组件里,最终一定是某一方让步——要么用户等着,要么审查跳过。
顺带说一个很多人没注意的细节:Cloudflare 的 DLP 策略是网关级的,没有 per-request 的开关可以选不同的 DLP profile,也不能针对单个请求绕过。文档的建议是按用途建多个网关。这进一步说明「一个网关管所有事」这个模型本身就有问题。
四、冲突三:失败的时候往哪边倒
第三个冲突是最容易出事、也最少被讨论的:组件挂掉的时候,默认是放行还是拒绝。
网关的工程传统是 fail open。理由很实在:网关是链路中间的一跳,它挂了整条业务就断了,而大多数时候「断业务」比「少一层检查」更严重。安全产品的传统反过来,是 fail closed:检查不了,就别放过去。
这两个传统撞在一起,结果通常是谁的代码在链路上谁说了算。
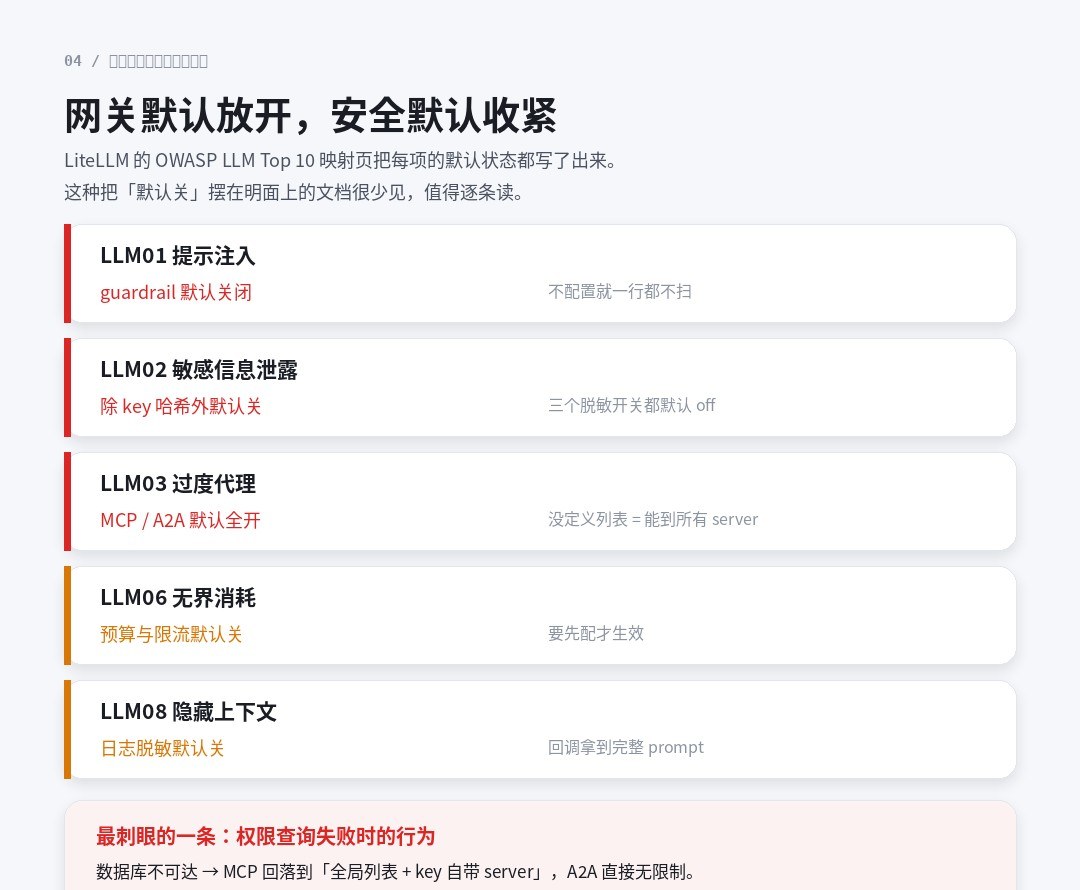
LiteLLM 那份 OWASP LLM Top 10(2026)映射文档,是我见过最诚实的材料之一:它把每一项的默认状态逐条列了出来,而且明说「几乎每个控制在你配置之前都是关的」。
| OWASP 项 | 默认状态 |
|---|---|
| LLM01 提示注入 | Off(不配置 guardrail 就一行都不扫) |
| LLM02 敏感信息泄露 | Off,除 key 哈希之外 |
| LLM03 过度代理 | Open until granted(没定义列表 = 能到所有 MCP server) |
| LLM04 供应链 | On |
| LLM06 无界消耗 | Off |
| LLM08 隐藏上下文曝光 | Off |
| LLM10 输出处理不当 | Off |
这份表里有一行我必须单独拎出来,因为它的后果比「默认关」严重一个量级:
「当权限查询失败、因为数据库不可达时,MCP 会回落到全局列表加 key 自己提交的 server,A2A 则返回无限制访问。」
翻一下:安全组件挂了,本应全拒,这里是全放。而且是在「过度代理」这个 2026 年刚往前挪了三名的风险项上。文档没有掩饰这一点,还附了待处理的 PR 编号——这种透明度值得肯定,但也说明它现在就是这样。
这条对架构的启示很直接:如果安全判定和流量转发是同一个进程、同一个失败域,那么转发的可用性要求会污染判定的严格性。要判定不该跟着转发一起 fail open,最干净的办法就是让它跑在另一个失败域里。
五、冲突的根源:两个 SLA 无法同时满足
把上面三条放在一起看,会发现它们不是三个孤立的 bug,是同一个矛盾的三次显形。
| 维度 | AI 网关 | AI 安全网关 |
|---|---|---|
| 优化目标 | 吞吐、延迟、成本 | 判定准确率、可追溯性 |
| 可接受延迟 | 越多越快越好,p99 是核心指标 | 单次判定几十毫秒是可接受成本 |
| 失败方向 | 倾向放行(保可用) | 倾向拒绝(保正确) |
| 策略变更 | 配置后渐进生效即可 | 必须立即、全局生效 |
| 缓存 | 核心能力 | 会绕过判定 |
| 流式 | 必须支持 | 与整段判定冲突 |
| 验收方式 | 压测、命中率、账单 | 绕过测试、误杀率、取证完整性 |
注意「策略变更」那一行。这一行是我认为最能区分两类产品的地方:网关的策略是配置,安全网关的策略是承诺。配置改错了可以回滚,承诺失效了要写事故报告。所以前者能接受「几分钟后生效」,后者不能。
当一件事既要求「尽可能快」,又要求「一次都不能漏」,它就不是一个组件能同时满足的需求。
六、怎么分工:按「失败了谁背」切
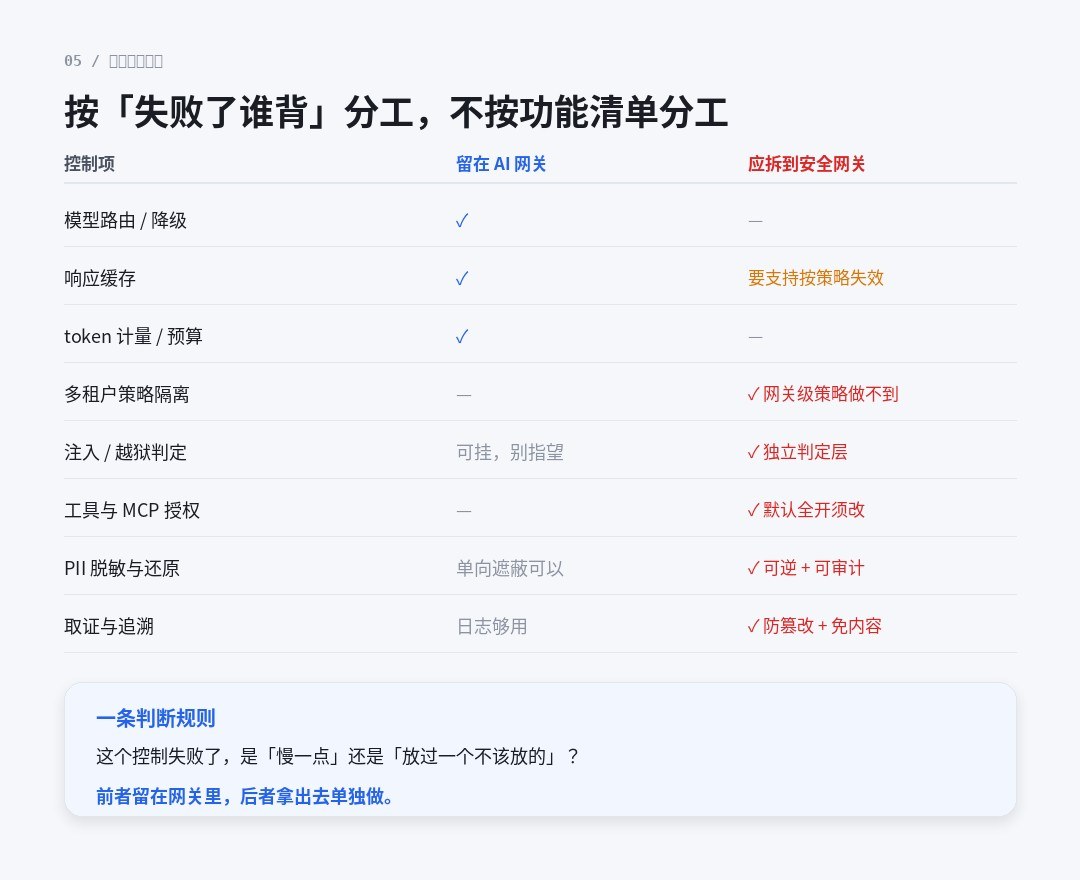
我不建议按功能清单分工,因为功能清单永远是重叠的。按一个问题切更清楚:这个控制失败了,是「慢一点」,还是「放过一个不该放的」?
前者留在 AI 网关里,后者拿出去单独做。落到具体项上:
| 控制项 | 留在 AI 网关 | 应拆到安全网关 |
|---|---|---|
| 模型路由 / 降级 | ✓ | — |
| 响应缓存 | ✓ | 需支持按策略主动失效 |
| token 计量 / 预算 | ✓ | — |
| 多租户策略隔离 | — | ✓ 网关级策略做不到 |
| 注入 / 越狱判定 | 可挂接,别当主防线 | ✓ 独立判定层 |
| 工具与 MCP 授权 | — | ✓ 默认全开须改 |
| PII 脱敏与还原 | 单向遮蔽可以 | ✓ 可逆 + 可审计 |
| 取证与追溯 | 日志够用 | ✓ 防篡改 + 免内容存储 |
三项值得展开的地方
- 多租户策略隔离。Cloudflare 的 DLP 策略是网关级的,要按租户区分只能建多个网关。如果你的业务是多租户 SaaS,这一条会直接决定架构形状。
- 可逆脱敏。传统 DLP 是「检测—阻断」,而 AI 场景常常需要「检测—脱敏—还原」:把 PII 在出站前抹掉,在响应回来时还原成用户自己的数据。这是单向遮蔽做不到的。
- 免内容取证。为了取证而存原始 prompt,等于自己造了一个合规雷区。元数据 + 被检内容的哈希,既满足审计又不制造新的数据资产——这一条我认为是安全网关和普通网关日志的分水岭。
七、如果只做一件事
很多团队的现状是:AI 网关已经上了,安全网关还在预算里。这种状态下的风险不在「没有安全网关」,而在「以为有了」。
所以如果只能做一件事,我建议做这个:先把默认值全部翻一遍。
理由很直接:上面那些 Off,不是配置错了,是出厂就是 Off。你的网关跑在生产上,流量是真的在过,但绝大多数控制项从来没被打开过。这件事不需要采购、不需要新预算、不需要架构评审,只需要半天时间和一份清单。
- 列出你网关上所有 guardrail / 策略项,以及它们当前的开关状态。
- 把「默认关」的逐条标注业务影响,至少把 LLM01(注入)、LLM03(工具授权)、LLM02(脱敏)三项打开。
- 检查失败方向:模拟一次权限查询失败,看它是放行还是拒绝。这一条最容易被忽略,也最致命。
- 确认缓存 TTL 与策略变更的关系:策略改了,旧缓存多久失效。把这个数字写进变更流程。
- 确认响应侧扫描对流式的处理:如果开了,用户感知的 TTFT 是多少;如果关了,等于放弃了输出侧判定。
做完这五条,你会得到一个比任何对比表都准确的结论:你现在拥有的到底是「一个网关」还是「一个安全网关」。
八、最后:这两种承诺为什么不能合并
回到标题里那个说法——同一段链路上的两种工程承诺。
我想强调的不是「它们不一样」,而是「它们不一样,而且这个不一样是结构性的,不会随着产品成熟而消失」。
缓存必然绕过判定,因为缓存的定义就是不再计算。流式必然与整段判定冲突,因为判定的前提是先有全部内容。转发必然倾向放行,因为它的职责是保可用性。这三条里没有一条是工程水平问题,全是目标函数的差异。
所以正确的做法不是找一个「两个都做得好」的产品,而是承认这是两层,然后把它们放在不同的失败域里,各自优化各自的目标。中间用明确的接口连起来:网关负责「送到」,安全网关负责「准不准放」。
这也是为什么我不太相信「一体化 AI 安全网关」这类说法。一体化的产品确实存在,也确实好用,但当它同时宣称高吞吐和零漏判时,通常意味着其中一项是在特定条件下成立的——而那个条件,往往不会写在对比表里。
能送到,和该不该送到,是两件事。把它们放进同一个组件,迟早要有一个让步。

itadol5j
暂无介绍....
没有啦 (T▽T)
延伸阅读:
AI 网关与 AI 安全网关:同一段链路上的两种承诺,为什么不能合并成一个组件
都插在应用和模型之间,都叫「统一入口」,但一个承诺高效抵达,一个承诺可判定可追溯。三处结构性冲突全部有厂商文档原文佐证:...

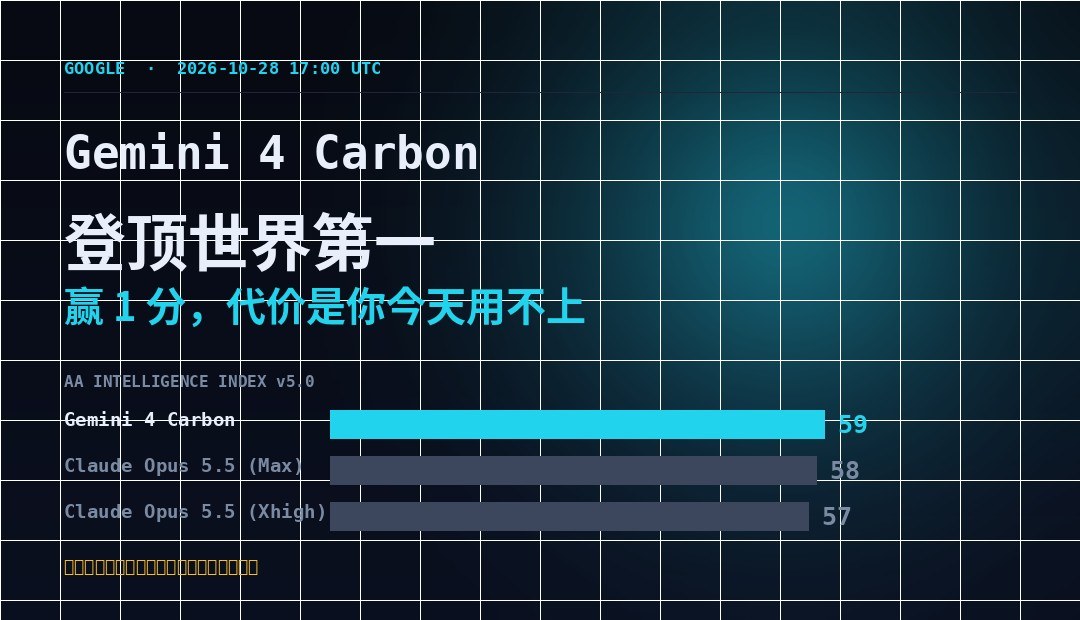
Gemini 4 Carbon 让谷歌重回第一:赢 1 分,而且你今天用不上
AA Intelligence Index v5.0 上 59 分排第一,第二名 58、第三名 57——但第二第三是同一...
AI 攻破 Anthropic 只用了 12 小时:被攻破的不是模型,是它买的那圈办公软件
一次授权测试,AI 智能体不到 12 小时进入 Anthropic 内部业务系统——入口是第三方办公软件,不是模型。但「...
输入、输出、缓存命中:AI token 账单上的名词,看懂这一篇就够了
为什么只发一句话,账单上有八千输入 token?为什么答案 20 个字,计费 900 token?缓存命中到底在匹配什么...

AI 写脚本、挑目标、开价:Phantom 把勒索做成流水线,但每一步都要人点头
8,257 条会话消息、$23,920 的 API 账单、62 家点名受害组织、46 个定制加密器。这不是「全自动勒索」...