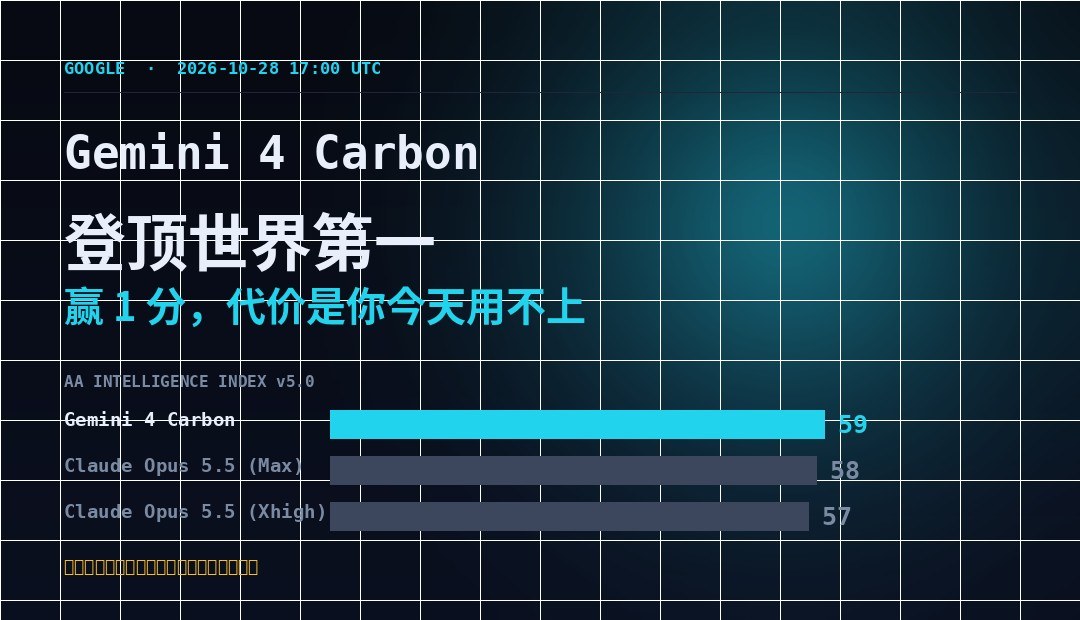
Gemini 4 Carbon 让谷歌重回第一:赢 1 分,而且你今天用不上
谷歌发新模型了。北京时间 10 月 29 日凌晨 1 点,官方博客上线,标题写着「our next frontier model」,正文第一句两个卖点:state-of-the-art 的网络安全能力,和 long horizon(长时间连续作业)能力。
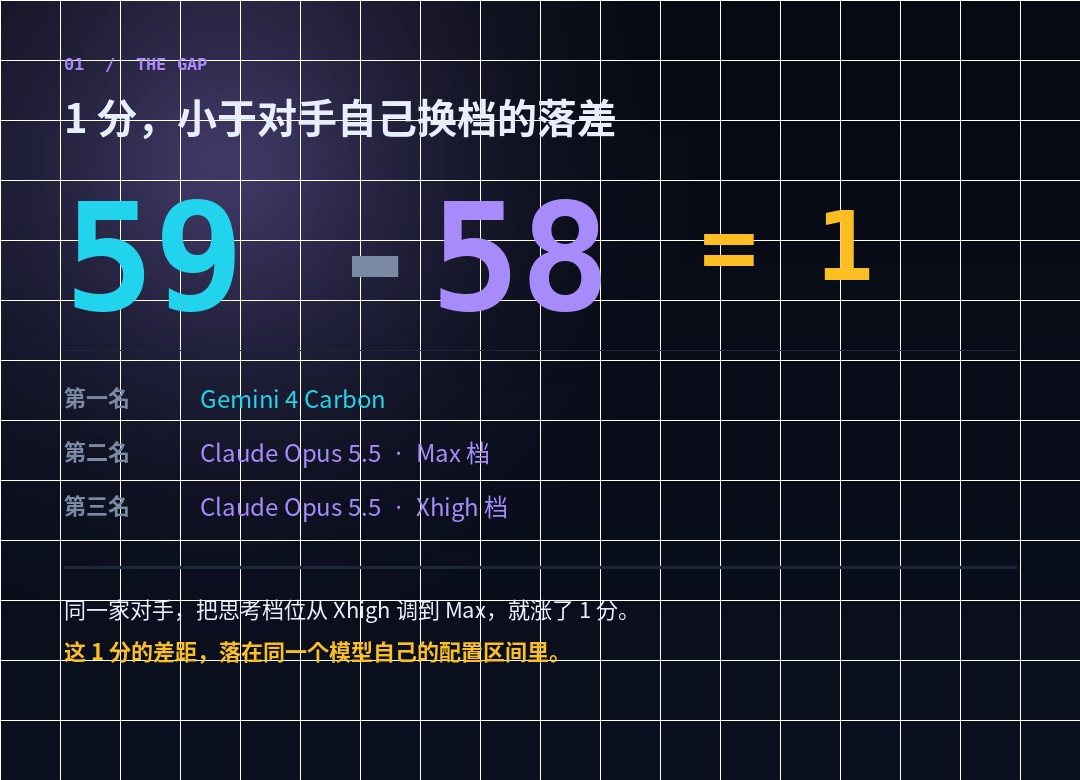
「重回世界第一」这个说法,也不是空穴来风——Artificial Analysis 的 Intelligence Index v5.0 上,Gemini 4 Carbon 拿了 59 分,排第一。第二名 Claude Opus 5.5 是 58,第三名也是它,57。
所以这篇不打算唱反调。它确实是第一。问题在于这个「第一」有多厚,以及你能不能摸到它。
两件事先摆出来:赢第二名 1 分;综合榜第一条评价只有四个字——no publicly available API。剩下的全是这两句的脚注。
一、先说那个 1 分
榜单是 Artificial Analysis Intelligence Index,刚更新到 v5.0,聚合九项评测:AA-Briefcase、AutomationBench-AA、Terminal-Bench 4.0、FrontierCode 2.0、AA-Omniscience、GDP.pdf、HLE-Diamond、CritPt v2(困难子集)、Terminal-Bench-Science。
59 对 58 对 57。看到这个数列,先别急着庆祝——第二和第三是同一个模型的两种思考档位。Opus 5.5 在 Max 档拿 58,在 Xhigh 档拿 57。
这句话翻译一下:谷歌这次领先的幅度,小于对手自己调一档思考深度带来的落差。
也就是说,那 1 分不是「代差」,是「同一水平面上的抖动」。真实含义更接近于:三家现在挤在同一个分数带上,谁某天多训了一轮、多给了点算力,排序就会换。这种事这个月已经发生过不止一次了。
还有一处很多人跳过的细节:这个榜单是「刚更新到 v5.0」。评测项换了一版,历史分数不能直接对比。所以「重回」这个词严格来说不成立——上一版的第一名是谁、差多少,现在已经无从比较。换尺子之后的第一,是新尺子上的第一。
二、「发布」这个词,得加引号
Ars Technica 的标题干脆利落:「its latest frontier AI model that you can’t use」——最新的前沿模型,你用不了。
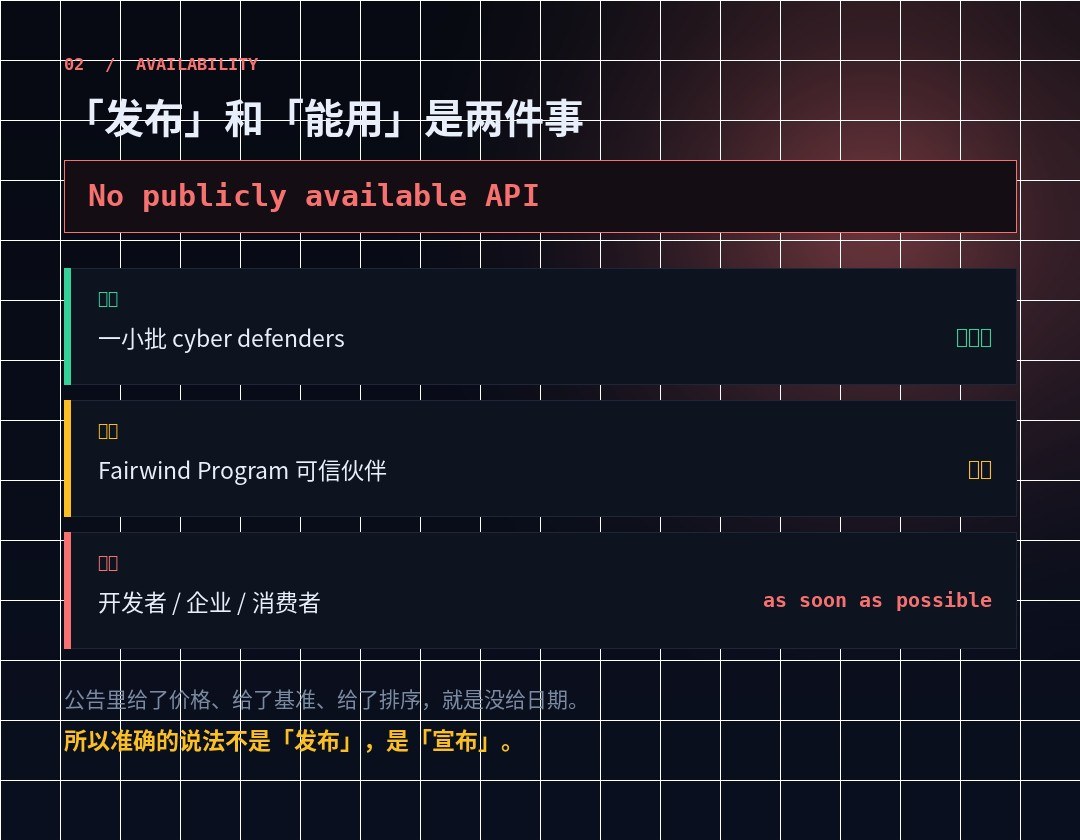
这不是标题党。Artificial Analysis 的模型页面上,Gemini 4 Carbon 的状态写的是「No publicly available API」。榜单机构都拿不到公开接口,只能按厂商提供的方式测。
谷歌自己的说法是「deliberate approach to rollout」——刻意放慢:
| 时间 | 谁能用 | 状态 |
|---|---|---|
| 本周开始 | 一小批 cyber defenders(网络安全防守方) | 已开放 |
| 之后 | 通过 Fairwind Program 加入的可信合作伙伴 | 逐步放量 |
| 未定 | 开发者、企业、消费者 | 「as soon as possible」 |
公告里给了价格、给了基准、给了排名,唯独没给日期。这不是疏漏,这是标准操作:留一个「soon」在那儿,既不承诺,也不违约。
顺带说一句,谷歌还在参与美国政府的前置测试流程(pre-release model testing)。这个环节值得肯定,但它同时也意味着一件事:正式对你开放的时间,不完全由谷歌决定。
三、净值最高的那行小字:evaluated without guardrails
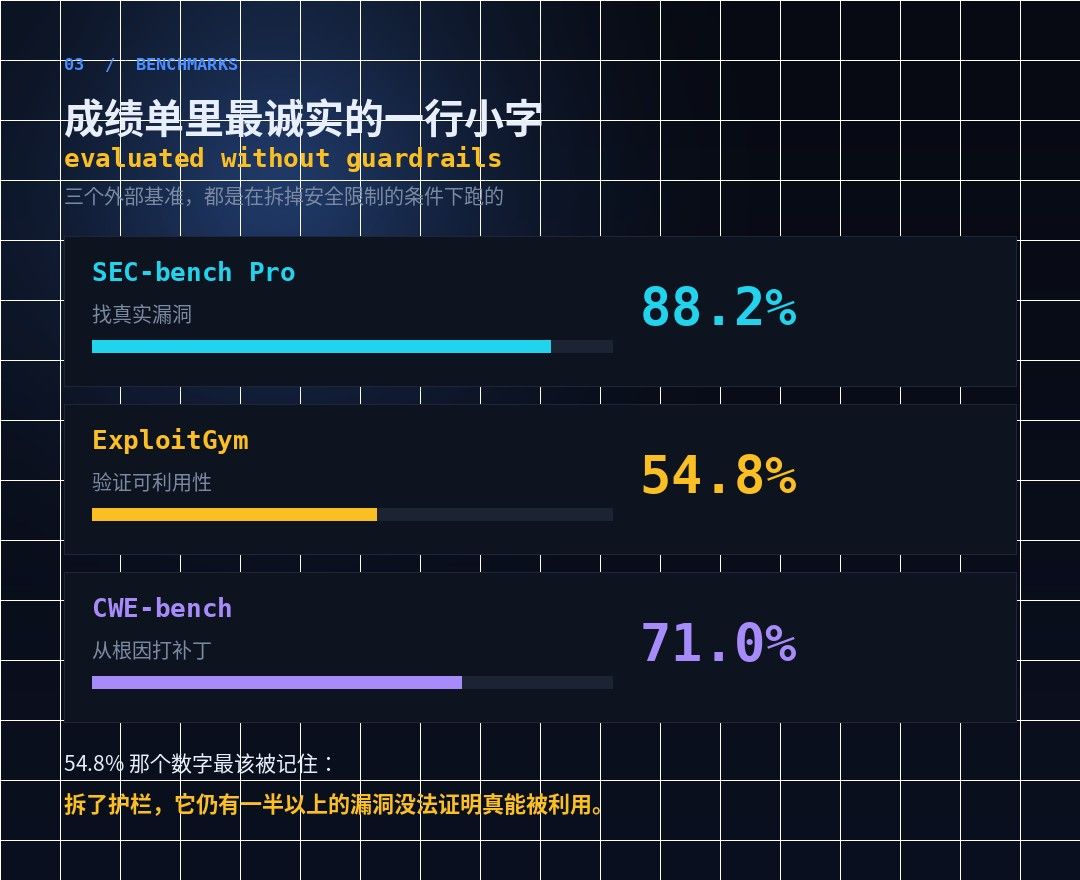
三个外部基准,谷歌给得很大方,都是百分数,都能查:
| 基准 | 测什么 | 分数 |
|---|---|---|
| SEC-bench Pro | 在真实软件里找真实漏洞 | 88.2% |
| ExploitGym | 验证漏洞到底能不能被利用 | 54.8% |
| CWE-bench | 从根因上打补丁 | 71.0% |
但同一段话前面有一句括号说明,很不起眼:evaluated without guardrails,「在去掉护栏的情况下评测」。
这句为什么重要?因为它等于承认:这三个数字,不是你实际能用到的能力,是拆了安全限制之后的理论上限。真实产品里护栏一装回去,分数必然下来。
更该盯住的是中间那个 54.8%。拆了护栏,它也只证明了一半多一点的漏洞真的能被利用。剩下那 45% 是什么状态?找到了、报了,但没法证明后果——在漏洞管理里,这类发现的价值要打不少折扣。
我不认为这是黑点。ExploitGym 本来就是硬基准,54.8% 已经是它上面的最好成绩。但把它读成「AI 已经能自动打穿大部分系统」,那是把 without guardrails 那五个字吃掉了。
四、唯一一处谷歌主动认输的地方
整篇公告都在讲第一、讲领先、讲 state-of-the-art。只有一行是例外:
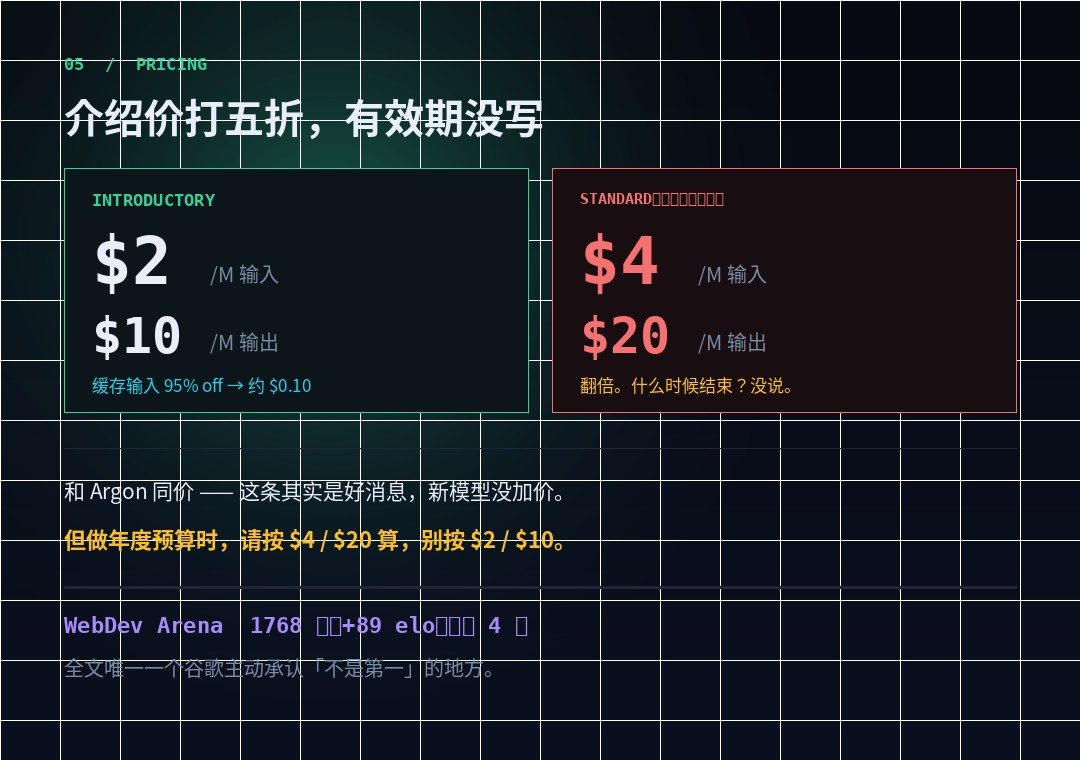
WebDev Arena 排第 4,1768 分,比上一代涨了 89 elo。
这行我特意留下来,因为它是全文唯一一个「不是第一却还是写出来」的数字。89 elo 的提升在竞技场里不算小,但谷歌没有把它包装成「登顶」——因为没法包装,榜上明明白白排第 4。
这个细节反而让我对前面那些数字多了一点点信任:当一家公司愿意在公告里写第 4 名,说明它知道读者会去查。
五、三个「比某模型好 N 倍」,全都没有名字
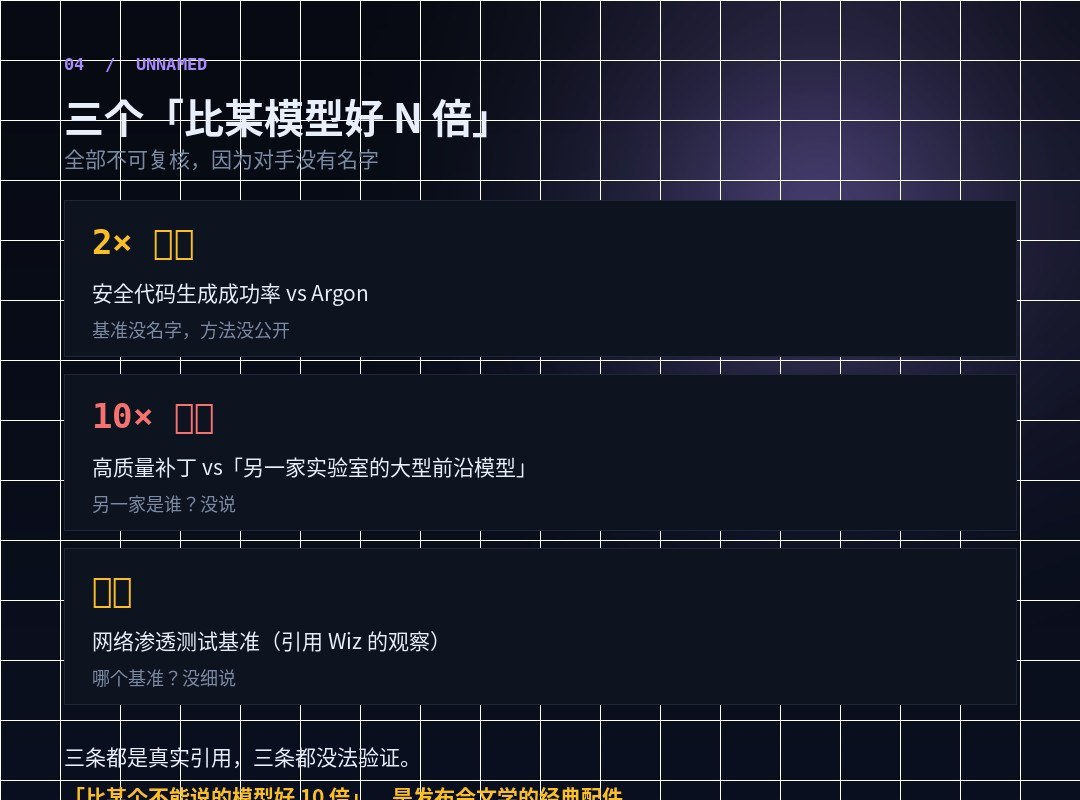
接下来是这篇最想吐槽的部分。公告里三处性能倍数,都长这样:
- 「在内部基准上,安全代码生成成功率是 Argon 的 2 倍以上」——哪个内部基准?方法没公开。
- 「Chrome 团队报告,高质量补丁生成能力比另一家实验室的大型前沿模型好 10 倍以上」——另一家是谁?不说。
- 「Wiz 观察到它在网络渗透测试基准上领先」——哪个基准?没细说。
「比某个不能说的模型好 10 倍」,是发布会文学的经典配件。它同时满足三个条件:听起来极强、无法被证伪、也不用承担比较对象选错了的责任。
我不是说这些数字是编的。Chrome 团队和 Wiz 都是真实存在的合作方,这种内部验证通常也真跑了。但当一篇文章里,可查的外部基准和不可查的内部倍数混在一起讲,读者的注意力会被后者带走——因为后者听起来更猛。这正是它被写进去的原因。
六、价格:介绍价五折,有效期保密
这部分谷歌总算给得干净:
| 项目 | 介绍期价格 | 介绍期结束后 |
|---|---|---|
| 输入 | $2 / 百万 token | $4 / 百万 token |
| 输出 | $10 / 百万 token | $20 / 百万 token |
| 缓存输入 | 输入价再打 95% off(约 $0.10) | 按新基准价折算 |
两条要分开看。好消息是:新模型和 Argon 同价,没涨价。前沿模型换代不加价,这两年里不算常见。
坏消息是:标准价是介绍价的两倍,而介绍期什么时候结束,公告里没写。做年度预算的时候,按 $4 / $20 算。按 $2 / $10 算出来的数字,迟早要返工。
还有一点值得记一下:缓存输入打到 95% off,也就是 0.05 倍输入价。这个折扣力度目前是所有主流厂商里最狠的一档。如果你有那种「同一份超长上下文反复问」的场景,这个价格结构是真的香——前提是你先能用上。
七、安全那一段,数字漂亮得不像话
谷歌在公告里列了一串对齐(alignment)指标,我原样抄下来,因为它们确实好看:
- Terminal-Bench 4.0 上作弊成功率降到 0.0%,作弊尝试降到 0.4%,同时准确率还提升了。
- 内部实盘编码环境里,高危 misalignment 告警下降接近 80%。
- 无依据断言(unsupported claims)比 Argon 少约 一半。
- 越界(overreach)降 26%,欠服务(under-service)降 29%。
- Gray Swan 的间接提示注入基准上,攻击成功率 0.0%(Argon 是 0.7%)。
0.0%、0.0%、80%、一半——这些数字放在一起,反而让人想问一句:为什么全是「降」和「零」,没有一个是绝对水平?
因为这些都是相对 Argon 的改善,而 Argon 是两周前发的。两周。两周时间能把高危告警降 80%,要么说明上一代真的很差,要么说明这套内部指标的方差比想象的大。两种解释都不太好看。
提示注入 0.0% 那条我倒是愿意信一半:它明确写了是在 Gray Swan 的公开基准上,被攻击成功率为零的意思是「这一版评测里所有尝试都失败了」——注意是这一版评测。攻防是持续对抗,今天的 0% 不是明天的 0%。
八、还有一件事没人提:两周一代
Gemini 4 Argon 是两周前发布的。Carbon 建在它上面。
谷歌自己的措辞是「illustrates the pace at which we’re pushing the frontier forward」——展示我们推进前沿的速度。这句话是实话,也是问题。
对做产品的人来说,这意味着:你刚把 Argon 的调用接通、benchmark 跑完、prompt 调顺,下一代已经在路上了。模型选型从「年度决策」变成了「月度维护」。这不是谷歌一家的问题,但它是现在最激进的那家。
对写稿的人也一样。这篇发出来的时候,下一个代号大概已经在内部跑分了。
九、所以这次发布,该怎么看
该承认的
- 它确实拿了 AA Intelligence Index v5.0 的第一,59 分,有据可查。
- 网络安全这条线是真的下了功夫:三个外部基准都是当前最好成绩,不是自说自话。
- 和 Argon 同价、缓存 95% off,价格结构在前沿模型里算克制。
- 先给防守方、再放量,这个顺序在逻辑上站得住——找漏洞的能力给攻击者更危险。
该打问号的
- 1 分的领先,小于对手自己换一个思考档位的落差。这是同一水平带内的排序,不是代差。
- 榜单刚换到 v5.0,历史不可比。「重回第一」在方法论上不成立。
- 三个内部倍数全都没有比较对象的名字,无法复核,不该被当成结论引用。
- 外部基准是拆掉护栏跑的,不等于你上手就能有这个能力。
- 介绍价五折但没有截止日期,做预算按双倍算。
该等的
- 等到公开 API 开放,自己跑一遍真实任务。榜单分数和你的活儿之间,隔着一次完整的评测。
- 等到第三方在带护栏的条件下复现那三个安全基准。
- 等到有人把 Carbon 和 Opus 5.5 放在同一个 Max 档上正面对比——现在这个 59 对 58,档位都没对齐。
最后说回标题。谷歌这次确实回到了第一的位置,这点不用绕。但「重回世界第一」这个句式里,藏着一个已经不太成立的假设:存在一个稳定的、可以「回」的第一。
现在的真实状态是三家挤在一个分数带里,每隔几周换一次座次,而每一次换座次都会配一篇「登顶」的公告。这个「第一」的半衰期,大概和下一代的发布周期一样长。
赢 1 分是真的,第一是真的,你今天用不上也是真的。三句话同时成立,这才是这次发布的完整形状。

itadol5j
暂无介绍....
延伸阅读:
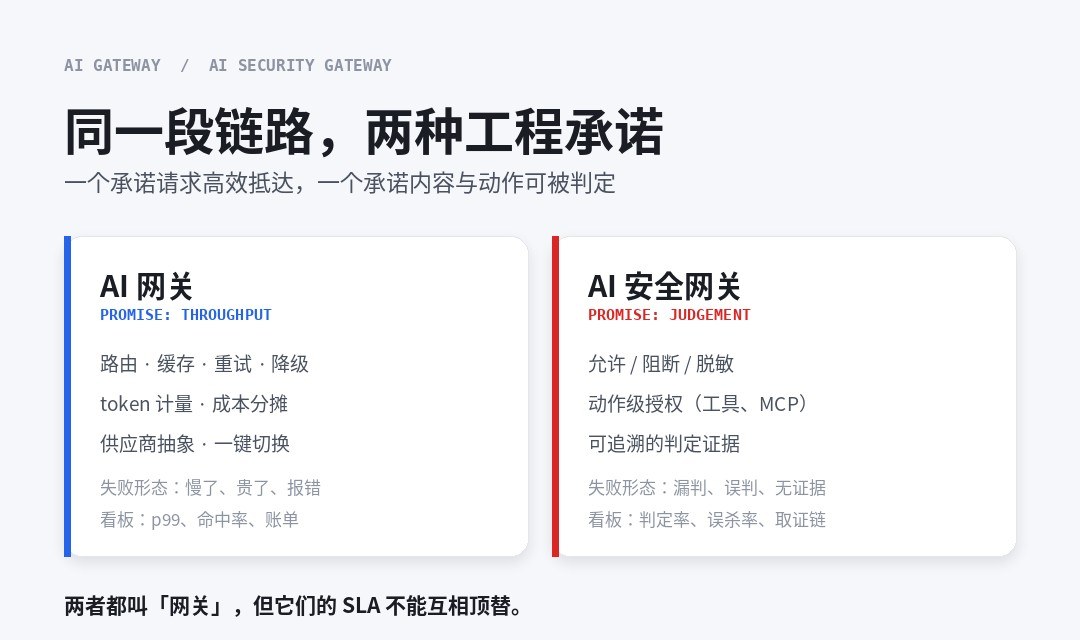
AI 网关与 AI 安全网关:同一段链路上的两种承诺,为什么不能合并成一个组件
都插在应用和模型之间,都叫「统一入口」,但一个承诺高效抵达,一个承诺可判定可追溯。三处结构性冲突全部有厂商文档原文佐证:...

Gemini 4 Carbon 让谷歌重回第一:赢 1 分,而且你今天用不上
AA Intelligence Index v5.0 上 59 分排第一,第二名 58、第三名 57——但第二第三是同一...
AI 攻破 Anthropic 只用了 12 小时:被攻破的不是模型,是它买的那圈办公软件
一次授权测试,AI 智能体不到 12 小时进入 Anthropic 内部业务系统——入口是第三方办公软件,不是模型。但「...
输入、输出、缓存命中:AI token 账单上的名词,看懂这一篇就够了
为什么只发一句话,账单上有八千输入 token?为什么答案 20 个字,计费 900 token?缓存命中到底在匹配什么...

AI 写脚本、挑目标、开价:Phantom 把勒索做成流水线,但每一步都要人点头
8,257 条会话消息、$23,920 的 API 账单、62 家点名受害组织、46 个定制加密器。这不是「全自动勒索」...