8 种 JWT 攻击,其实只有 3 个根因:拆一款零后端的图形化利用工具
先说结论:JWT 攻击的种类数是个假指标。 市面上任何一个 JWT 工具列出来的能力表,八项十项看着很热闹,但把这些攻击按「服务端到底在哪一步做错了」归类,只剩三层。
这两周我翻了几款图形化的 JWT 工具,最后挑 JWT Arsenal(HiitCat/JWT-Arsenal,跑在 jwtarsenal.com)来拆。挑它的理由不是它最火——它其实很新、很小,2026 年 5 月才建仓,star 只有个位数——而是它的源码是公开的,而且把「为什么某个攻击在浏览器里做不了」这种取舍明明白白写在页面里。一个工具肯解释自己的边界,比它多支持两种攻击更值钱。
先把它的模块摊开看:仓库 app/exploit/ 下有 8 个目录——unverified-signature、alg-none、algorithm-confusion、kid-injection、jwk-injection、jku-injection、public-key-recovery、secret-bruteforce。README 的能力表只列了 7 项,多出来那个是 secret-bruteforce。
八变三,下面开始。
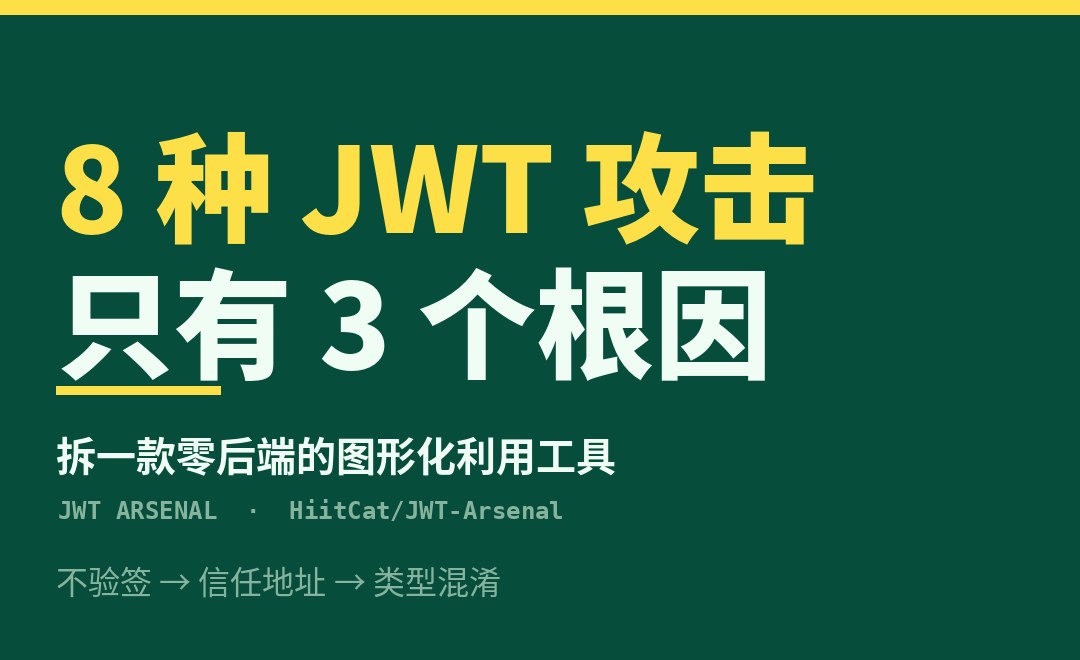
一、三层根因,是递进关系不是并列关系
先给结论再拆:
| 层 | 服务端做错了什么 | 对应模块 | 攻击者拿到什么 |
|---|---|---|---|
| 一 | 根本不验签名 | unverified-signature、alg-none | 任意伪造,零成本 |
| 二 | 验签,但「去哪找钥匙」听 token 的 | kid、jku、jwk、x5u、x5c | 一把你自己选的钥匙 |
| 三 | 验签,但用错了钥匙的「类型」 | algorithm-confusion、public-key-recovery | 一把你自己造的钥匙 |
这三层不是并列的三种攻击,是一条链上的三个失守点。
第一层是「门没锁」。第二层是「门锁了,但门牌号是访客写的」——服务端说「我去 kid 指定的位置取钥匙」,那你就指定一个自己能控制的位置。第三层最精妙:「门锁了,门牌号也是服务端定的,但服务端把同一把钥匙用错了算法」——它拿 RSA 公钥当 HMAC 的共享密钥用,而公钥是公开的。
所以第三层有一个前置条件:你得先有公钥。这就解释了为什么 public-key-recovery 不是一个独立攻击,它是第三层的入口——服务端不暴露公钥时,你得从两个签名里把公钥算出来。
八项能力里,有四项是同一个根因的四种变体。 这就是为什么能力表越长越没用:它数的是「填参方式」,不是「失守位置」。
二、第一层:不验签,以及四个大小写变体
这一层的两个模块其实是同一件事的两种表现。
unverified-signature 处理的是最粗暴的情况:服务端把 token 解开读了 payload,然后忘了(或者根本没写)验签那一步。你把 sub 从 user 改成 admin,签名一个字不动,它照收。
alg-none 处理的是稍微讲究一点的错误:服务端确实有验签代码,但它的算法白名单没写好,允许了 none。
关键细节在这里——大小写。JWT 规范里 none 是小写,但很多实现的白名单检查是字符串精确比对,而攻击者可以试 None、NONE、nOnE。工具的源码里就是四个变体一起生成:
header["alg"] = "none" # or "None", "NONE", "nOnE"工具页面上写得很直白:「4 variants generated」,四个变体一次性给你,逐个丢过去。这不是炫技,是因为真实的坑就藏在大小写里——你按 RFC 写 none 打不进去,不代表这条路不通。
顺带一句:这个漏洞有编号,CVE-2015-9235,node-jsonwebtoken 的 alg:none 绕过,2015 年的东西,2026 年还在被写进工具里。
这一层为什么排第一? 因为它不需要任何前置条件。你拿到一个 token,先试这一层,一分钟内要么通要么不通。图形化工具在这里的价值就是把「试四个变体」从四次操作压成一次点击。
三、第二层:把「找钥匙的地址」交给了 token
这一层是 JWT 攻击里最容易被低估的部分,也是这款工具做得最细的部分。
JWT 头部有几个字段,设计初衷是「告诉你我的钥匙在哪」:
kid:Key ID,一个标识符,服务端拿它去查密钥表jku:JWK Set URL,一个地址,服务端去这个地址下载公钥集jwk:直接把公钥嵌在头部里x5u/x5c:X.509 证书链版本
这四个字段的共同点是:它们都是 token 自己声明的。 服务端如果不做收窄,就等于让攻击者告诉它「去哪拿钥匙」。
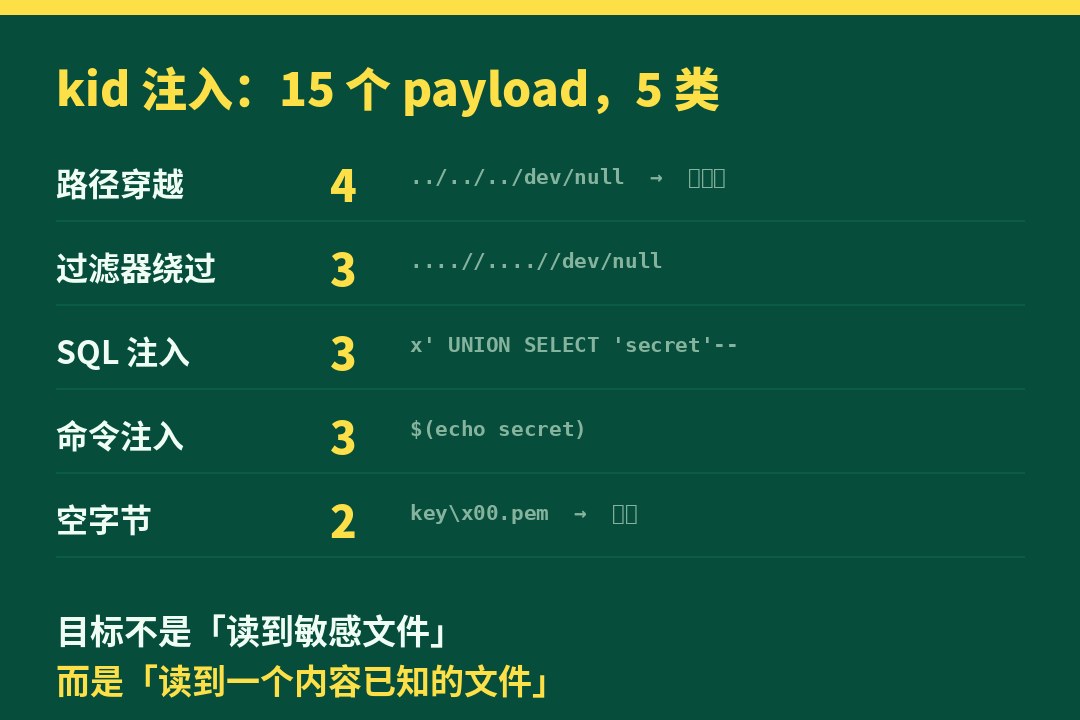
工具的 kid-injection 模块内置了 15 个 payload,分 5 类。这个分类很有信息量,我照着仓库源码 lib/kidPayloads.ts 抄一遍:
| 类别 | 数量 | 思路 | 代表 payload |
|---|---|---|---|
| 路径穿越 | 4 | 让服务端读一个内容可预测的文件当密钥 | ../../../../../../dev/null |
| 过滤器绕过 | 3 | 过滤器只剥一层 ../,就给它两层 | ....//....//....//dev/null |
| SQL 注入 | 3 | kid 被拼进查询语句,强制它返回你指定的值 | x' UNION SELECT 'secret'-- |
| 命令注入 | 3 | kid 被当 shell 命令执行 | $(echo secret) |
| 空字节 | 2 | 提前截断,绕过后缀拼接 | key\x00.pem |
第一个 payload 值得单独讲:../../../../../../dev/null。为什么是 dev/null?因为在 Linux 上它是一个永远为空的文件。服务端读它当密钥,得到的就是空字符串——而空字符串是攻击者已知的。这不是猜,是设计。
还有一个更妙的:/proc/sys/kernel/randomize_va_space。这个内核参数在绝大多数标准 Linux 上是 2。也就是说,如果服务端去读它当密钥,密钥就是字符串 "2"——一个你以为随机、实际上写在教科书里的值。
这里的洞察是:路径穿越攻击的目标不是「读到敏感文件」,而是「读到一个内容已知的文件」。 前者叫信息泄露,后者才叫伪造。
四、第三层:用错钥匙的类型,以及一个 64 字节的怪事
第三层只有两个模块,但它是技术上最有意思的一层。
algorithm-confusion 干的事:把头部里的 alg 从 RS256 改成 HS256,然后用服务端的 RSA 公钥当 HMAC 的共享密钥去签名。
为什么这能成?因为 RSA 验签用的是「公钥 + 私钥」一对,HMAC 用的是「同一份共享密钥」。如果一个实现从 token 里读 alg,看到 HS256 就去拿「密钥」,而它的「密钥」配置里放的其实是那个 RSA 公钥(因为它是 RSA 服务)——那它就用了公钥当 HMAC 密钥。公钥是公开的,所以你能签。
工具在这里生成了两个变体,源码注释写得很清楚:
PEM exact bytes:公钥 PEM 的完整字节,含结尾换行PEM trimmed (no trailing newline):去掉尾部换行
为什么需要两个? 因为服务端读公钥的方式不一样。有的实现把文件整个读进来(带换行),有的 trim() 过。差一个 \n,HMAC 结果就完全不同。这不是冗余,这是把「猜对方的实现细节」这一步也自动化了。
然后是那个 64 字节的怪事。
kid 那层的 dev/null payload,密钥是空字符串。但浏览器的 Web Crypto API 拒绝导入空密钥——它会直接抛错。工具的解决办法是:
// WebCrypto rejects empty keys; pad to SHA-256 block size (64 bytes)
function toHmacKeyBuffer(secretBytes: Uint8Array): ArrayBuffer {
  return secretBytes.byteLength === 0
    ? new Uint8Array(64).buffer
    : /* ... */;
}
把空密钥补成 64 个零字节。
乍看像 workaround,实际上是数学等价的。 HMAC 规范本身就规定:密钥短于分组长度时,右侧补零到分组长度。SHA-256 的分组长度正好是 64 字节。所以 HMAC(key="") 和 HMAC(key=00...00)(64 个零)算出来是同一个值。
这一段是整篇文章里我最想让人看到的地方:一个图形化工具的可靠性,不在于它界面漂亮,而在于它把这些「看起来像 hack、其实是规范」的细节处理对了。空密钥补 64 字节这种写法,如果作者只是随手糊一个非空字符串,工具就会在 dev/null 那个 payload 上静默出错——你点下去、没反应、以为是目标不打,其实是工具算错了。
五、唯一没在浏览器里实现的攻击,理由写在页面上
public-key-recovery 这个模块,点进去你会发现没有输入框,只有一堆命令行。
它自己的说明是这样的:需要从两个 RS256 签名里,用 GCD(最大公约数)把 RSA 公钥算出来。虽然 JavaScript 的 BigInt 理论上能算,但这个过程涉及 4096 位数的多轮候选配对,做一个可靠的浏览器实现不如直接用 Python 工具划算。
所以它给的是 rsa_sign2n 的完整命令:
git clone https://github.com/silentsignal/rsa_sign2n
cd rsa_sign2n
pip3 install -r requirements.txt
这个取舍值得单独说。 一个工具最难的品质是知道自己不该做什么。八项能力里七项纯前端,唯一一项重计算的老实交出去,还顺手把「怎么接着做」写清楚了——做完公钥恢复,回到算法混淆那一页继续。
这条链在实战里是这样的: 目标用 RS256,但公钥没暴露 → 抓两个不同的 token → rsa_sign2n 算出公钥 → 回来用算法混淆,拿这把公钥当 HMAC 密钥签名 → 通。
缺任何一环,第三层就打不通。所以这两个模块在界面上是分开的,在攻击链上是一个。
六、图形化真正解决的问题:枚举空间
到这里可以回答一个问题了:这种工具到底比命令行强在哪?
不是「点起来方便」。是它把枚举空间可视化了。
回头看这几个数字:
- alg:none → 4 个大小写变体
- kid 注入 → 15 个 payload,分 5 类
- 算法混淆 → 2 个 PEM 变体
一个新手用 CLI 打 JWT,最常犯的错不是「命令记不住」,是打完一个 payload 没通就换目标了。他不知道 radius 里的那个 payload 有多少种写法,也不知道 None 和 none 是两个不同的尝试。
图形化把「我要试哪些组合」直接摊在屏幕上,一次全给你。它省的不是打字时间,是「你不知道还有别的可能」这件事。
反过来说,工具的隐蔽价值在「检查器」上。它的安全分析模块会扫这些:
alg是 none(critical)alg是 HS*(medium,提示可离线爆破,hashcat-m 16500)alg是 RS/ES/PS(high,提示混淆风险)- 没有
exp(high)、exp已过期(info)、寿命超 30 天(medium) iat在未来(medium)、nbf晚于exp(high,这个 token 在任何时间窗都不可能有效)- 缺
iss/aud/sub/jti(low 到 info) - payload 里含
password、secret、token、api_key这类字段名(high) - 头部有
jku/jwk/x5u/x5c(high)、有kid(medium)、有crit(info)
这份清单本身就是一份检查表。 你不需要每次都想「我该看什么」——粘进去,它告诉你这个 token 有哪几处写着「来打我」。
其中一个判断特别值得记:nbf 晚于 exp,这个 token 在任何时间窗都不可能有效。 但它又是 high 级——因为有些解析器会忽略这个自相矛盾,照样放行。逻辑无效的东西能被接受,这本身就是漏洞。
七、一个不该被当成营销的前提:零后端
这类工具有一个和别人不一样的安全要求:用户会往里粘贴生产环境的 token。
一个 token 就是一把钥匙。你把它粘到一个「在线 JWT 调试工具」里,如果那个工具是服务端渲染的,你的 token 已经上传到别人的服务器上了,而且进了日志。
所以 JWT Arsenal 的零后端不是卖点,是底线。README 里三条写得很干脆:零后端(CDN 静态托管,没有服务端代码)、零遥测、运行时零网络请求——所有密码学操作走浏览器原生 Web Crypto 和 jose 库。
这条判断可以推广到所有同类工具上:任何需要你粘贴凭证的在线工具,都必须能离线跑。 做不到这一点的,不管界面多漂亮,都不该用。这是个可以拿去筛工具的标准。
八、边界:它替代不了 CLI 工具
得说清楚它不能干什么,否则这篇就成了软文。
| 场景 | 图形化(JWT Arsenal) | CLI(如 jwt_tool) |
|---|---|---|
| 快速判断一个 token 有哪些问题 | ✅ 粘进去就看 | 要记参数 |
| 枚举变体试打 | ✅ 一次生成全部 | 要逐条跑 |
| 批量处理几百个 token | ❌ 一次一个 | ✅ 天然适合 |
| 挂代理、接 Burp 联动 | ❌ 独立页面 | ✅ 可在工具链里 |
| 公钥恢复这类重计算 | ❌ 明确不做 | ✅ 有现成脚本 |
| 写进自动化流程 | ❌ | ✅ 可脚本化 |
所以正确的定位是:它是「快速定位阶段」的工具,不是「全流程」的工具。
一个真实项目的顺序大概是:发现一个 JWT → 粘进图形化工具看它哪一层失守 → 确认打哪一层 → 需要批量或联动时代码化。
工具链不是选一个,是分工。把图形化工具当终点的人,会在需要批量的第一个小时里放弃它;把它当起点的人,省下的是排查方向的时间。
九、分角色给结论
如果你在做渗透测试: 先建立那张三层表。看到 JWT 的第一反应不该是「试 alg:none」,而是「这个 token 的 alg 是什么、服务端可能在哪层失守」。三层顺着走,比乱试快十倍。
如果你在写服务端代码: 按三层的反面对自己提三个问题——① 我是不是真的验签了(不是「解析了」)② 密钥来源是不是完全由服务端决定(kid 有没有被拼进任何路径、SQL、命令、URL)③ 我是不是从 token 里读 alg 来决定用哪种算法。第三问最常被忽略,也最致命。
如果你只是想搞懂 JWT: 先去把这个工具的安全分析那一页的检查项抄下来。那份清单比任何教程都实在——它列的不是攻击手法,是「什么样的 token 看起来就有问题」。
最后说一句关于这款工具本身:它很新、star 不多、代码量不大,算不上什么重量级项目。但它在两个地方做得比很多老工具清醒——把 8 个模块的边界说清楚,把不该在浏览器里做的事诚实地推出去。 一个工具知道自己做不到什么,通常意味着它知道自己做到了什么。

itadol5j
暂无介绍....
延伸阅读:
李佳琦首卖Token,阿里92年副总裁站台:这场直播真正上链接的不是Token
李佳琦今晚首卖 Token,阿里最年轻副总裁陈宇森站台。但算完账你会发现:20 万亿 Token 折成钱是几千万级预算,...

我跑了一遍 AiSOC:6311 星的开源 AI 安全中心,最值钱的是它自己那份打脸报告
AiSOC 6311 星,MIT,Cyble 出资。但最值钱的是它自己那份 REPOSITORY_REALITY.md:...
8 种 JWT 攻击,其实只有 3 个根因:拆一款零后端的图形化利用工具
八项 JWT 攻击能力按「服务端在哪一步做错」归类只剩三层:不验签、信任 token 给的钥匙地址、用错钥匙类型。拆 J...
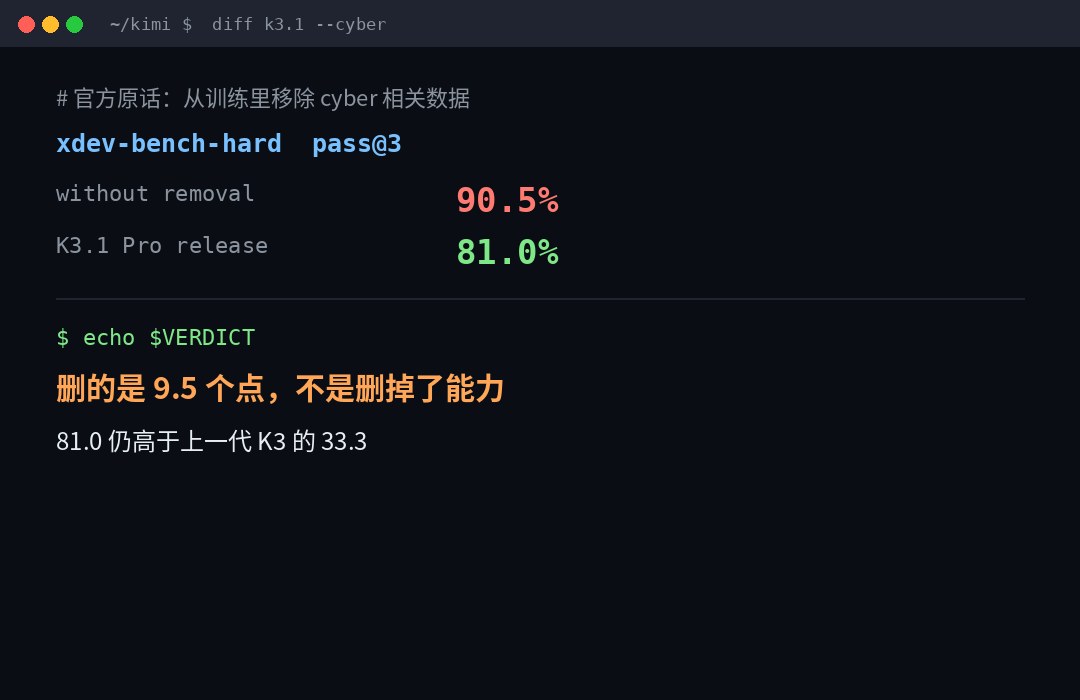
Kimi K3.1 没有「移除攻击能力」,它只是把天花板削掉了 10%
Kimi K3.1 没有移除攻击能力。官方删的是训练数据里指向攻防的语料,内部基准 90.5 掉到 81.0——而 90...
一份积分,五个产品:WorkBuddy 的 Buddy One 到底统一了什么(附接入教程与提示词)
Buddy One 统一的不是五个 App,是一份账:积分、1TB 存储、会员身份三层合并。官方文档里四处会真金白银卡住...