我跑了一遍 AiSOC:6311 星的开源 AI 安全中心,最值钱的是它自己那份打脸报告
先说结果:这个项目最值得看的不是它的 AI,是它自己写的一份审计文档。
那份文档叫 docs/audit/REPOSITORY_REALITY.md,开头一句是这么写的:「下面每一条被标为 WORKING 的,要么在真实栈上跑通过,要么追溯到了一个真实调用链。验证不了的地方就写验证不了。没有一条是靠『文件存在』推断出来的。」
我跑了两遍:一遍是它那个三十秒的离线 demo,一遍是把这份审计从头读到尾。
读完之后我的判断是——这东西的代码水平不是重点,它那种「先承认自己哪里是假的」的做法才是重点。 因为在安全工具这个圈子里,愿意在自己官网上写「我们以前的快速开始是假的」的项目,我印象里一个都没有。
一、先看那份打脸报告说了什么
审计文档里有一段,我原样翻译过来:
> 在这次审计之前,文档里那个快速开始,其实什么都没跑到。 ./install.sh 交给的是一个九服务的编排文件,里面没有 ingest 服务、没有 fusion 服务,而且写着 AISOC_DISABLE_KAFKA: true。它唯一的「内容」,是 seed_demo.py 直接往 Postgres 里写进去的 15 条编造事件。 > > 一个新用户照着 README 走完,看到的是一个装满的界面,于是得出结论:这平台能跑。而实际上他从头到尾没跑过这个平台。
后面还有一句更狠的:
> 光是这一件事,就解释了为什么总有人反馈「数据是假的」「架构对不上」。
我看这段的时候停了很久。这不是别人爆的料,是项目自己写的,写在仓库里、链在 README 上,标题就叫「什么才是真的能跑」。
安全工具最怕的不是功能少,是你不知道它哪部分是演示。 一个 SOC 平台如果连「事件到底有没有真的从 Kafka 走过来」都要靠猜,那它给的所有结论都不值钱。
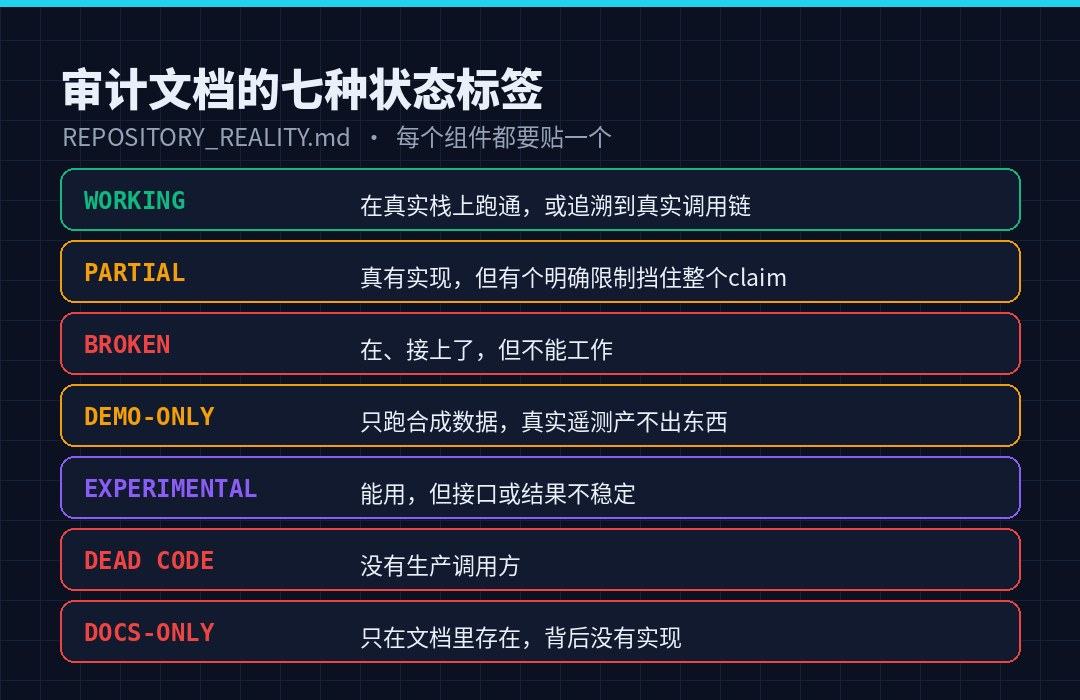
这份文档做的事,就是把每一个组件贴上一个状态标签:WORKING / PARTIAL / BROKEN / DEMO-ONLY / EXPERIMENTAL / DEAD CODE / DOCS-ONLY。最后两个标签是这台机器上最不该出现的两个词——「没有生产调用方的代码」和「只在文档里存在的东西」。
二、我实际跑的那三十秒
pip install aisoc-sandbox && aisoc-sandbox demo,一行装完,一行跑完。
它给了五个预置场景,我挑的是 lateral-movement——Okta 异地登录,Alice 在纽约 09:30 登录成功,八分钟后从圣彼得堡又登了一次,中间地理跨度在那八分钟里物理上不可能。
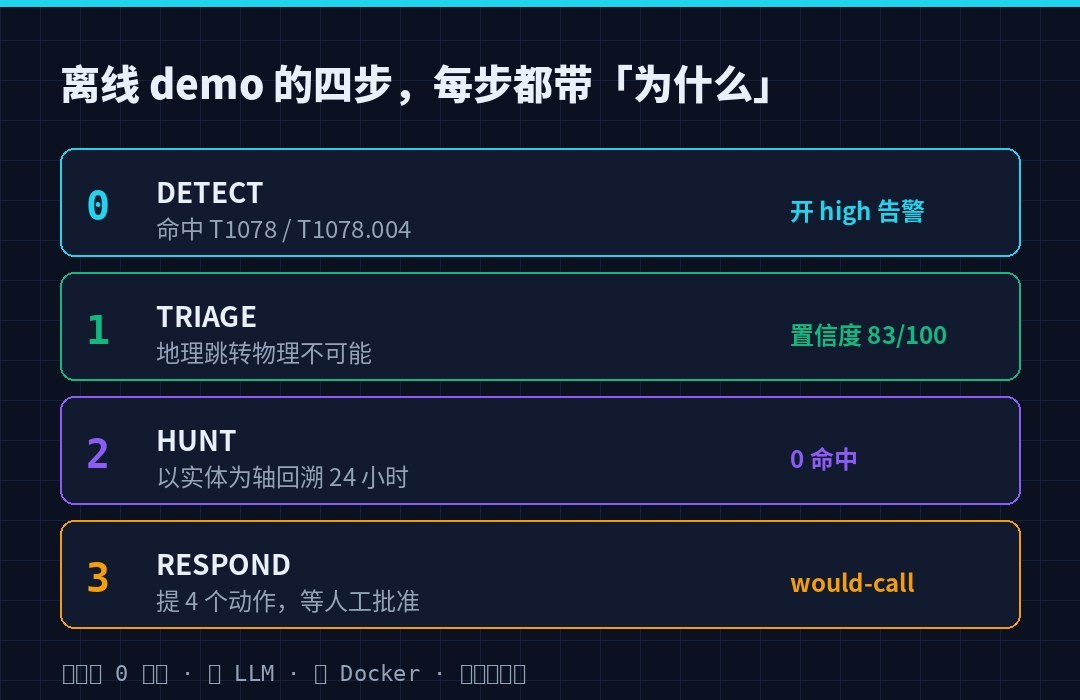
输出是四步:
Step 0  DETECT   DetectAgent    → 命中 T1078 / T1078.004,开一条 high 告警
Step 1  TRIAGE   TriageAgent    → 置信度 83/100,理由:协议层看起来合法,但地理跳转物理不可能
Step 2  HUNT     HuntAgent      → 以实体为轴回溯 24 小时,0 命中
Step 3 RESPOND RespondAgent → 提 4 个处置动作,等人工批准每一步都带三样东西:做了什么、为什么这么判断、调用了什么。比如第 1 步的「为什么」写的是:
> 认证会话在协议层看是合法的,但两个连续事件之间的地理跳转在物理上不可能——典型的凭据接管特征。
第 3 步给的四个动作是:撤销该用户全部会话、强制改密、建工单、通知值班群。而它的结论行写得很清楚:「4 个动作已提出,等分析员批准后执行。」
这里有个细节值得单独说。 整个输出跑下来只用了 0 毫秒,因为它是纯离线的合成运行——没有 LLM,没有 Docker。所以每一步的调用都标成 would-call:
→ would-call user.session.revoke_all({"user": "alice@example.com"})would-call 这个词是整段输出里最诚实的地方。 它没说「我撤销了会话」,它说的是「我真的跑起来的话,会调这个」。
如果所有 AI 安全工具都这么写,这个行业能少一半误解。
三、2538 和 7023 之间那 4485 条
真正让我决定写这篇的,是它的检测规则处理方式。
README 里写:2538 条可执行规则,规则库里有 7023 条。
中间差 4485 条。绝大多数项目会把这个差额藏起来,或者干脆只报大数。它反过来,专门写了一页报告解释差额是怎么来的。
它的做法叫「可执行是挣来的,不是声明的」:
> 一条规则只有在一个厂商格式的真实事件、经过真实的连接器 normalize() 和真实的检测引擎、并且被亲眼看到命中之后,才进入编译后的规则集。绝不从「目录里存在」或者 enabled: true 推断。
而且这个证明还能反向验证:--prove-gate 会把 Windows 连接器撤掉,然后要求那 1687 条 Windows 规则全部静默。如果撤了连接器还有规则在响,说明这个证明是假的。
然后是那份拒绝清单,这是全文我最想让人看的一张表:
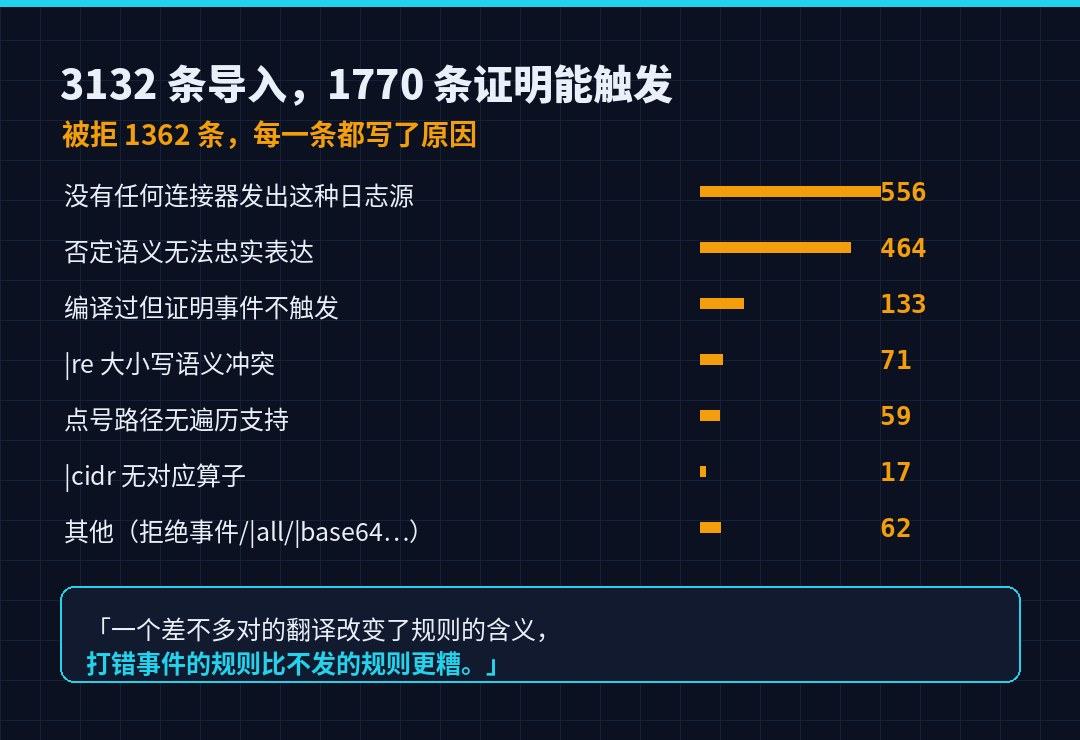
| 拒绝原因 | 条数 | 例子 | ||
|---|---|---|---|---|
| 没有任何连接器发出这种日志源 | 556 | linux/None | ||
| 否定语义无法忠实表达(缺字段会翻转结论) | 464 | `ModifyingApplication\ | startswith` | |
| 编译过了,但在自己的证明事件上不触发 | 133 | DLL 侧加载规则 | ||
| 上游 `\ | re` 区分大小写,而匹配器强制 IGNORECASE | 71 | `CommandLine\ | re` |
| 字段是点号路径,匹配器不支持路径遍历 | 59 | properties.message | ||
| 连接器直接拒绝了那个证明事件 | 30 | Azure App Gateway 规则 | ||
| `\ | cidr` 没有对应算子 | 17 | `DestinationIp\ | cidr` |
| `\ | all` 用在非 contains 修饰符上 | 14 | S3 桶策略规则 | |
| 裸关键词要全事件搜索,匹配器是字段级的 | 10 | 授权给账号 | ||
| `\ | base64 / \ | base64offset` 没有算子 | 7 | Cobalt Strike 服务安装 |
| `\ | fieldref` 要比较两个字段,没有算子 | 1 | 进程删除自身可执行文件 |
全部加总:1362 条被拒。 从 3132 条导入的 Sigma 规则里,编译并证明能触发的是 1770 条。
报告里有一句话把立场说透了:
> 拒绝是刻意的。一个「差不多对」的翻译改变了规则的含义,而打错事件的规则比不发的规则更糟。
这话在检测工程里是常识,但把它写成一份带条数和例子的公开表格,就不是常识了。
四、跑起来才发现的五个问题
审计文档里还有一节,叫「跑起来才发现的已知缺陷」,开头写:「这些光看代码是看不出来的。」
我挑五个最有代表性的:
① 每一条告警的 connector_type 都是 "crowdstrike crowdstrike"。 厂商和产品拼接时没去重,而且同一个 helper 在两个地方各有一份拷贝。
② 告警描述字段里放的是序列化的事件。 控制台本该显示一句话,实际显示 {"command_line": "powershell.exe -nop ...,把厂商自己给的描述丢掉了。
③ Kafka 的健康检查在一个不能工作的 broker 上报 healthy。 磁盘满的时候 Kafka 写不了 meta.properties,拒绝了所有请求,编排层照样显示健康。
④ CrowdStrike 的告警到融合层时没有 actor。 而这个系统的关联键是 {租户}:{实体}:{战术}——所以缺 actor 不是空一列,是所有受影响的告警都关联进同一个 unknown 桶。
⑤ 被停用用户的 API Key 还能继续认证。 这条最要命。会话路径每请求都重读 is_active,所以停用确实立刻踢掉了会话;但 _resolve_api_key 走的是另一条路——它查不到活跃用户时,不是拒绝,而是退化成一个通用的 api_service 角色放行。于是一个离职的人给自己签的所有 key 都能一直用下去。
第 ⑤ 条是这类系统的典型死法:功能路径都测了,测试方法也对(测会话,会话确实断了),但有两套认证实现,只测了一套。
审计文档还顺手记了一个纠正过自己的判断:它一开始把 OpenSearch 记成死代码,理由是「没有任何东西读它」。后来发现查错了服务——只查了 services/api,没查 services/threatintel,而后者无条件在用。它把这次误判原样写在了文档里。
一个项目的可信度,很大程度上取决于它怎么处理自己判断错的地方。
五、几个诚实到反常的数字
这个项目在报数上有几个习惯,值得单独拿出来说。
模型可靠性:50 条告警里,44 条给出可用输出;把回复约束成 JSON 之后,50 条全部可用。
它用的是本地 ~2GB 的 llama3.2:3b-instruct-q4_K_M,CPU 推理。它自己承认:「这不是前沿模型」,而且页面上会标注是哪条路径回答的。
告警缩减率报了三个数:75.3%(旧的归组口径)、33.3%(生产口径)、24.5%(检测形状的队列)。
大部分产品只会挑最高的那个报。它把三个并排放着,还解释了为什么第三个最低——因为在修掉一个缺失标识符时,它选择了收窄分组而不是放宽,这个选择直接让数字变难看。
没测过的写「未测量」,不写 0。
它的模型适配矩阵里,没有付费 key 测不了的模型行,写的是 not measured。README 里原话:「这里从未跑过任何托管厂商的模型——因为没有付费 key,所以按模型的那些行读作『未测量』而不是零。」
这一条是判断一个安全项目靠不靠谱最快的尺子。 一个把「没测」写成 0 的项目,和一个把「没测」写出来的项目,差的是整个数据文化。
六、它的边界,人家自己写了
README 里有一节叫「AiSOC 不是什么」,四条:
- 不是可以替换掉的 SIEM。 它做关联和调查,不替代长期日志留存和合规检索
- 看不见你没接进来的遥测。 没有资产发现能力
- 默认不自主。 响应需要显式策略授权和人工批准
- Demo 和样本事件不是真实事件,基准数字是底座的自洽性度量,不是真实 agent 准确率
配套的还有部署要求,写得很具体:Docker Compose v2、Docker VM 里 8GB 内存和 20GB 空闲磁盘、python3 3.9+、bash。首次运行要下一个 ~2GB 的模型到卷里。
它还顺手解决了一个很实际的问题:端口被占用不会中断安装。 它会挑一个空闲端口发布,告诉你旧端口被谁占了,然后把控制台地址一起挪过去。文档里给的数据是:在一个 5432 和 11434 都被占用的裸克隆上,64 秒到已登录的控制台。
装完之后有个 make smoke,把一个真实事件推进去,跟着它穿过 Kafka、检测、关联、Postgres,再从公开 API 把告警读回来,每个阶段报 PASS 或 FAIL:
[PASS] raw telemetry accepted by ingest
[PASS] event traversed the spine and became an alert
PASS: 10/10 stages
这十行 PASS,就是那份审计文档存在的意义。 有了它,「跑起来了」才是一个可以被验证的陈述,而不是一个截图。
七、要不要装
如果你是做蓝队/检测工程的: 值得装。不是因为它 AI 有多强,而是因为它那份 Sigma 编译报告——1362 条为什么被拒,每一条都带原因和例子。这份清单本身就是一份「你的检测规则为什么打不响」的排查手册。你甚至可以不装它,只读那页文档。
如果你想看 AI 怎么落地到安全运营: 看它的 Investigation Ledger 设计。每一步记 prompt、工具调用、引用、判决、token 成本,导出成签名证据包;一个引用了证据里不存在的指标的判决,会被降级到人工复核而不是自动关单。 这个「接地检查」是整条链上最该抄的一段。
如果你只是想找个 SIEM 替代品: 别装。它自己第一条就说了不是。
最后说个背景:这个项目由 Cyble 出资,MIT 协议,2026 年 5 月建仓,到 11 月 1 日已经发到 v21.0.0,6311 星。版本号跑得很快,但那份审计文档和 README 里的每个数字都是脚本从树上重新数出来的,CI 会在 README 和代码对不上时失败。
在一个连「我们的快速开始曾经是假的」都敢写出来的仓库里,版本号跑得快反而让人放心一点。

itadol5j
暂无介绍....
延伸阅读:
李佳琦首卖Token,阿里92年副总裁站台:这场直播真正上链接的不是Token
李佳琦今晚首卖 Token,阿里最年轻副总裁陈宇森站台。但算完账你会发现:20 万亿 Token 折成钱是几千万级预算,...

我跑了一遍 AiSOC:6311 星的开源 AI 安全中心,最值钱的是它自己那份打脸报告
AiSOC 6311 星,MIT,Cyble 出资。但最值钱的是它自己那份 REPOSITORY_REALITY.md:...
8 种 JWT 攻击,其实只有 3 个根因:拆一款零后端的图形化利用工具
八项 JWT 攻击能力按「服务端在哪一步做错」归类只剩三层:不验签、信任 token 给的钥匙地址、用错钥匙类型。拆 J...
Kimi K3.1 没有「移除攻击能力」,它只是把天花板削掉了 10%
Kimi K3.1 没有移除攻击能力。官方删的是训练数据里指向攻防的语料,内部基准 90.5 掉到 81.0——而 90...
一份积分,五个产品:WorkBuddy 的 Buddy One 到底统一了什么(附接入教程与提示词)
Buddy One 统一的不是五个 App,是一份账:积分、1TB 存储、会员身份三层合并。官方文档里四处会真金白银卡住...