552B 的模型,每次只叫 8B 起床:把 DeepSeek V4.1 Flash 的 MoE 讲成人话
先说结果:我第一次看到”552B 参数”这四个字,本能反应是”这玩意儿得多少张卡”。等我把它 config.json 拆开算了一遍,才发现自己错得离谱——它干活的时候,压根没叫醒 552B。
真正上场的,是 8B。
这两个数字差了 69 倍。中间那个东西,叫 MoE。
这篇不聊跑分,不聊价格,就把 MoE 是什么、552B 和 8B 到底什么关系、为什么这两个数字能同时成立,讲清楚。看完你再去看任何一款 MoE 模型的宣传,都不会被绕进去。
我一开始是怎么算错的
我先说我的错误,这样你能少走一遍。
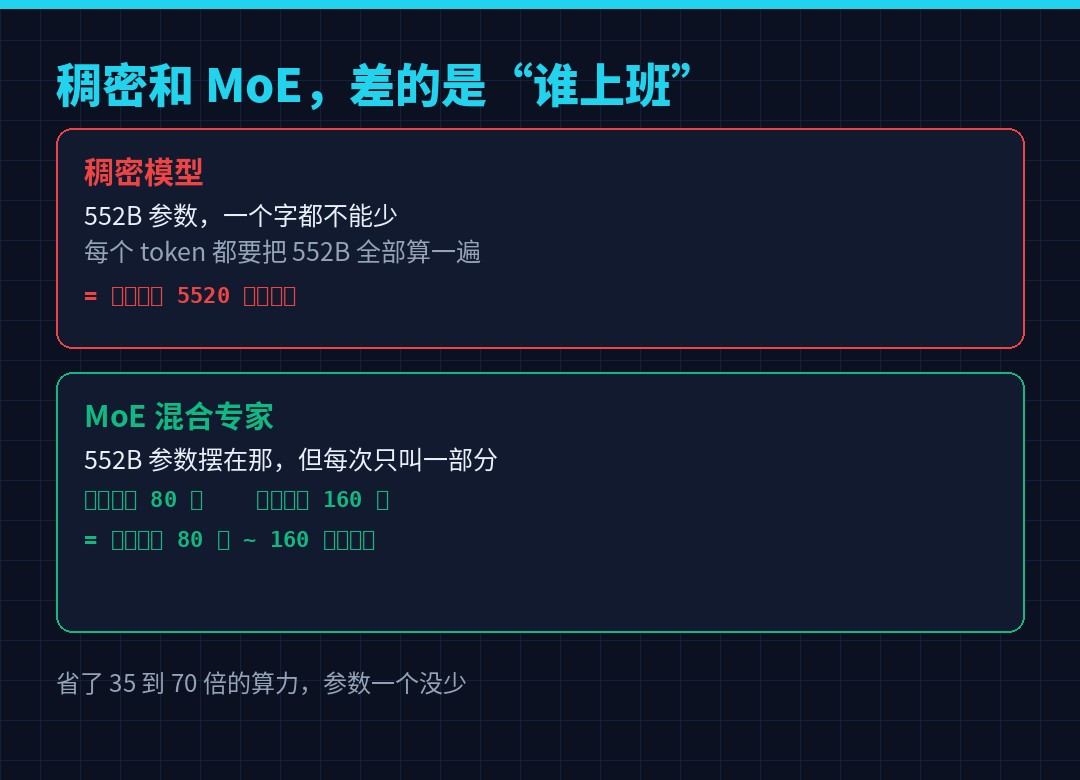
我脑子里的模型是这样的:参数量 = 这个模型有多重;有多重 = 跑起来要多大的显存、多少算力。稠密模型确实是这样,比如一个 70B 的稠密模型,每生成一个字,70B 参数全都要参与计算一遍。
按这个逻辑推,552B 的模型生成一个字,就要动 5520 亿个参数。
我当时算出来一个结论:这东西每吐一个字,相当于普通 70B 模型跑八遍。那它凭什么便宜?
这个结论是错的。错在我把”模型的体积”和”模型的工作量”当成同一件事了。
稠密模型里这两件事碰巧是一回事,MoE 把它们拆开了。
MoE 到底是什么:一个公司的比喻
Mixture of Experts,混合专家。名字翻译得挺唬人,其实机制特别朴素。
想象一家公司有 384 个专业部门,还有一个综合办公室。
每来一个任务(一个 token),不是把 384 个部门全叫来开会,而是由一个前台看一眼这个任务,挑出最对口的 6 个部门,加上综合办公室,一起处理。处理完就散会,剩下的 378 个部门继续摸鱼。
这就是 MoE 的全部机制。
对应到技术术语:
- 384 个专业部门 = 384 个 routed expert(路由专家)
- 综合办公室 = 1 个 shared expert(共享专家),每个 token 都会经过它
- 前台 = router(路由器),学出来的一个打分函数
- 挑 6 个 = top-6 路由,每层每个 token 只激活 6 个专家
- 不上班的部门 = 参数还在,但不参与这次计算
DeepSeek V4.1 Flash 的模型卡里写得很清楚:每层 1 个共享专家 + 384 个路由专家,每个 token 激活 6 个路由专家。一共 40 层。
那 552B 和 8B 是怎么同时成立的
这是整篇最核心的一段,我用真实数字给你算一遍。
我去 HuggingFace 上把它的 config.json 拉下来,关键几个字段是:
hidden_size: 5120
moe_intermediate_size: 2304
num_hidden_layers: 40
n_routed_experts: 384
n_shared_experts: 1
num_experts_per_tok: 6
一个 MoE 专家的参数量,基本就是三个矩阵(SwiGLU 结构,gate、up、down):
3 × 5120 × 2304 = 35,389,440,约 3540 万参数。
一层 384 个这样的专家:
3540 万 × 384 ≈ 135.9 亿。
40 层加起来:
135.9 亿 × 40 ≈ 5436 亿。
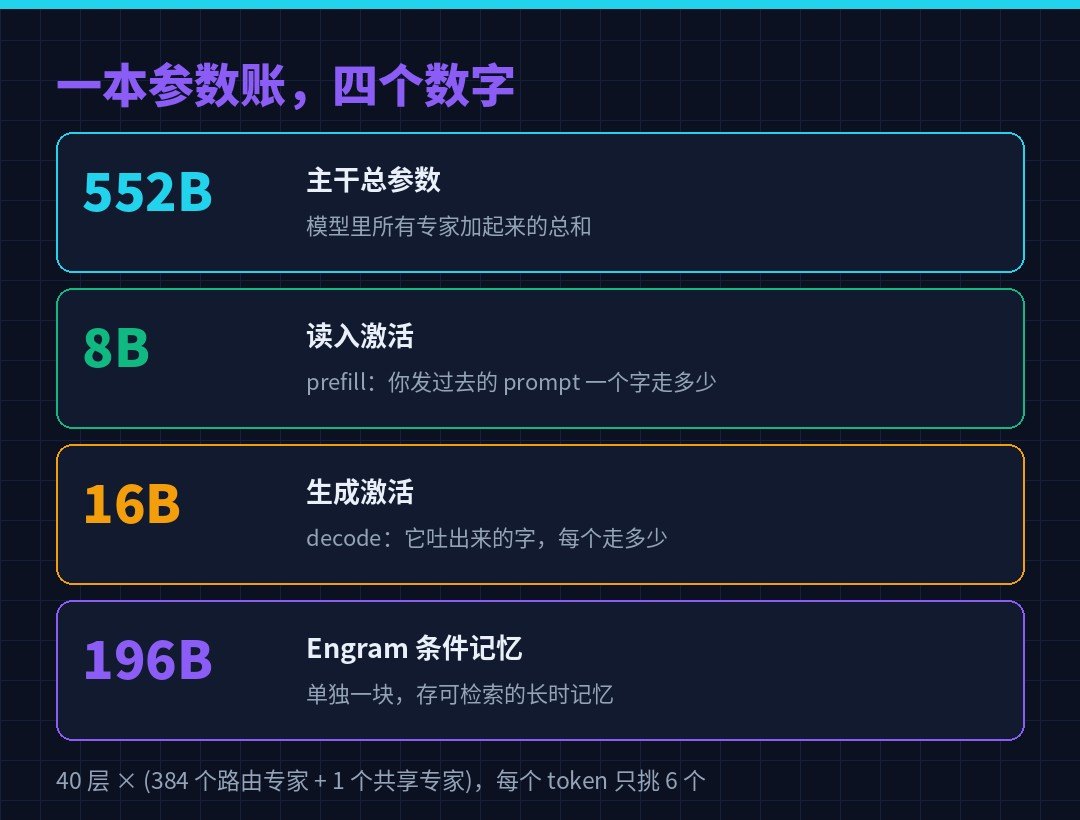
加上 40 个共享专家(约 14 亿),再加注意力层、词表嵌入这些剩下的部分,凑到 5520 亿。
所以你看到的 552B,主要是这 384×40 = 15360 个专家堆出来的。
现在算激活量。每个 token 每层只走 6 个路由专家:
3540 万 × 6 × 40 ≈ 85 亿。
这就是官方说的”读入时激活约 8B”的来源。我不是抄的,是自己按 config 算出来的,对得上。
生成时激活 16B,是因为解码阶段的路径不一样(后面会讲 CED)。
552 ÷ 8 = 69。
552 ÷ 16 = 34.5。
这就是两个数字能同时成立的原因:模型有 552B 的记忆容量,但只花 8B 到 16B 的计算量。
一句话记住:显存按大的算,算力按小的算
我把这件事总结成一句话,你可以直接背下来:
买模型看总参数,跑模型看激活参数。
展开成两本账:
第一本,显存账。 所有权重都得装进显卡里。哪怕这次不用,它也不能凭空消失——下一个 token 可能就要叫它。所以 552B 就是 552B,FP8 下大约 552GB(说 510GB 的那批文章,单位其实是 GiB)。这个数字骗不了人,它决定了你至少需要多少张卡。
这里还有个细节,是我拉 config.json 时才注意到的:它的 quantization_config 里除了 quant_method: fp8,还单独写了一条 expert_dtype: fp4,权重分块是 32×32。也就是说,那些专家的权重还能再压一轮——真正吃掉显存的大头,比「552B 乘一个字节」要小。
第二本,算力账。 每生成一个字,只有那 6 个专家的权重被搬进计算单元。所以真正的乘加运算量,对应的是 8B 到 16B 这个量级。
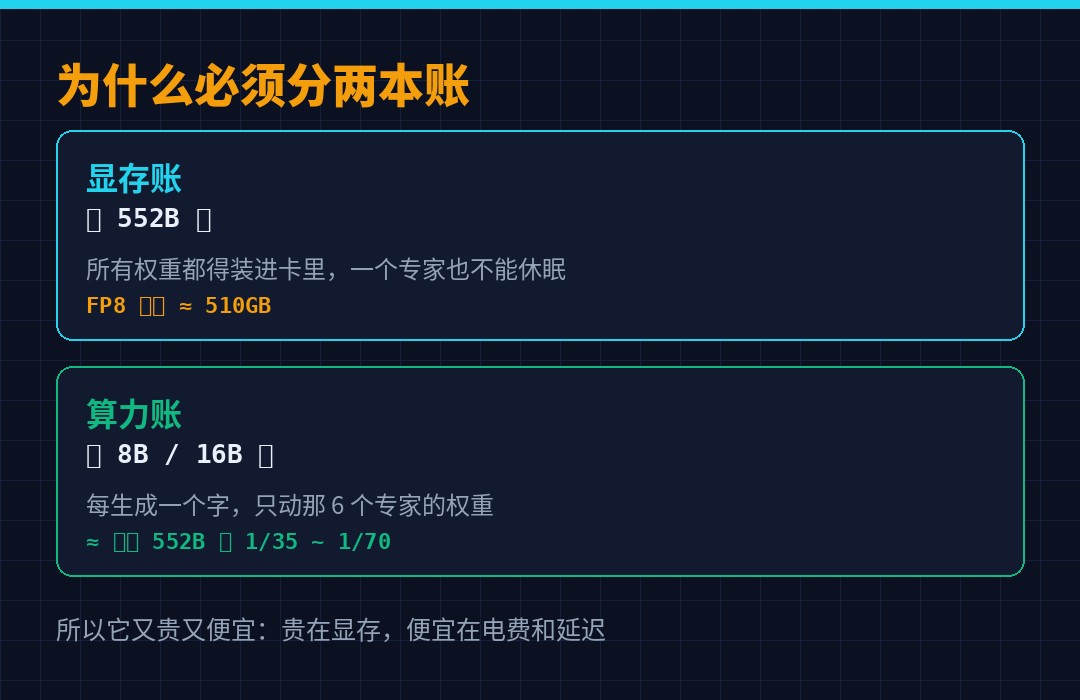
这就是为什么 MoE 模型给人一种”又贵又便宜”的割裂感:
- 贵,贵在显存,你得把几百 GB 全塞进去
- 便宜,便宜在算力和延迟,每个字只算 8B 的量
很多人抱怨”MoE 模型本地跑不动”,其实说的是第一本账。也有人夸”MoE 推理便宜”,说的是第二本账。两边都没错,只是没分清账本。
为什么读入只要 8B,生成却要 16B
这里有个反直觉的地方,值得单独说。
正常人的理解是:读入一段长文本,应该更费劲才对。毕竟你发过去一万字,模型得全看完。
但 DeepSeek V4.1 Flash 反过来了:读入只激活 8B,生成要激活 16B。
原因在它的架构上。模型卡里写的是 Causal Encoder-Decoder,简称 CED:40 层 Transformer 被切成前 20 层编码器 + 后 20 层解码器。
关键在于后半段的 KV 缓存。传统解码器每一层都要自己算一份 KV,层数越多缓存越厚。CED 的做法是——解码器的全局 KV 不从自己每层的隐状态推,而是直接从编码器最后一层的隐状态投影过来。
翻译成人话:前 20 层把整段输入吃透、压成一份摘要;后 20 层拿着这份摘要往外吐字,不用每层都重算一遍输入的表示。
于是读入阶段便宜(8B),生成阶段要维持自回归的推理路径,稍贵一点(16B)。
这个设计的取向非常明确:它是为”输入很长、输出不长”的场景优化的。 你把一整份代码库、一整份合同、几十页文档丢进去问一个问题,正是它的舒适区。
反过来说,如果你要它写一本小说,这个架构不占优势。
顺便说清楚 Engram 那 196B
你可能会在某些文章里看到”748B”这个数字,跟 552B 对不上,然后困惑。
这不是错,是两个口径。
模型卡里写了:Engram conditional memory,196B 参数,通过 token 级别的查表稀疏访问。
552B + 196B = 748B。
Engram 是什么?你可以理解成一块可以按需查表的长期记忆。它不是常规的注意力机制,而是一个巨大的键值存储,模型给一个 token,去里面查出对应的历史关联。因为它是稀疏访问的,查一次只碰一小块,所以它的 196B 也不参与”每 token 激活多少”的计算。
所以看到 748B 不要慌,那是把记忆体也算进总账了。做显存规划的时候要算它,算单字成本的时候不用算它。
那这架构对普通人意味着什么
我不太想写成产品软文,就说三句实在的。
第一,MoE 不是魔法,是拿显存换算力。
这条路线的本质是把”计算密集”换成”显存密集”。算力便宜的地方(云端大规模推理)它很划算;显存紧张的地方(你桌上那张 24G 的卡)它一点优势都没有。所以别指望消费级显卡能跑 552B 满血,物理规律不答应。
第二,激活参数才是你该看的那个数。
以后再看到某某模型”总参数 XXXB”,先问一句”激活多少”。1T 总参数激活 30B 的模型,实际推理成本可能比 200B 稠密模型还低。只报总参数不报激活参数的宣传,等于只报车重不报油耗。
第三,架构选择暴露了产品定位。
CED 这种”读入便宜、生成稍贵”的设计,等于明说了它是给 agent、给长文档分析、给代码库理解准备的。这类任务的特征是输入巨大、输出很小。你要用它写长文,就属于用错工具。
最后,给你一个自查清单
下次再遇到一个新模型,按这个顺序看,五分钟能摸清底细:
- 总参数多少 —— 决定显存下限
- 激活参数多少 —— 决定推理成本和速度
- 专家怎么配 —— 多少路由专家、几个共享、top-k 取几
- 是不是稠密 —— 如果没提 MoE,那就是稠密,两个数字相等
- 上下文多长 —— 决定它能一次吃多少东西
- 有没有额外的记忆模块 —— 有的话,总参数会虚高
把这六条问完,任何一篇模型发布稿都忽悠不了你。
DeepSeek V4.1 Flash 的答案是:552B 总量、8B/16B 激活、40 层、每层 384 路由 + 1 共享、top-6、100 万上下文、外加 196B Engram。
记住这个比例:69 比 1。
模型的体积和它的工作量,从 MoE 开始,就是两件不同的事了。
最后补一句我自己踩过的细节:它的 topk_method 是 noaux_tc,scoring_func 是 sqrtsoftplus,routed_scaling_factor 是 1.5。这些名字你不用记,它们说明的是一件事——「选哪 6 个专家」这件事本身是要精心设计的。路由器挑错人,552B 的知识就调不出来。MoE 的难点从来不在「分成多少份」,而在「怎么分对」。

itadol5j
暂无介绍....
延伸阅读:
AI Agent 出事那天,你多半找不到「现场」:一份能照着跑的应急响应方案
Agent 出事那天,没有进程树、没有内存镜像、甚至说不清是哪台机器——传统应急的三大支柱在这里全部失效。一份可以照着跑...

552B 的模型,每次只叫 8B 起床:把 DeepSeek V4.1 Flash 的 MoE 讲成人话
552B 总参数、8B 激活,差 69 倍,两个数字却能同时成立——中间那个东西叫 MoE。用一家 384 个部门的公司...
李佳琦首卖Token,阿里92年副总裁站台:这场直播真正上链接的不是Token
李佳琦今晚首卖 Token,阿里最年轻副总裁陈宇森站台。但算完账你会发现:20 万亿 Token 折成钱是几千万级预算,...
我跑了一遍 AiSOC:6311 星的开源 AI 安全中心,最值钱的是它自己那份打脸报告
AiSOC 6311 星,MIT,Cyble 出资。但最值钱的是它自己那份 REPOSITORY_REALITY.md:...
8 种 JWT 攻击,其实只有 3 个根因:拆一款零后端的图形化利用工具
八项 JWT 攻击能力按「服务端在哪一步做错」归类只剩三层:不验签、信任 token 给的钥匙地址、用错钥匙类型。拆 J...