AI Agent 出事那天,你多半找不到「现场」:一份能照着跑的应急响应方案
先说一个我在演练里撞到的问题。
假设你公司有个客服 Agent,接的是工单系统,权限是”读工单 + 回客户 + 建跟进单”。某天安全告警响了:这个 Agent 的凭据在凌晨三点调了 400 多次导出接口。
传统应急的思路是:先隔离主机,再抓内存镜像,然后看进程树。
问题是——隔离哪台主机?
这个 Agent 可能跑在 K8s 的某个 pod 里,但它的”行为”发生在 API 网关上;它的”记忆”在向量库里;它的”指令”是一段 prompt 模板,存在 Git 里;它的”身份”是一个 service account,跟另外三个 Agent 共用。
传统应急的三大取证支柱,在这里全部失效:
- 没有进程树。 它的”动作”是一条条 HTTP 请求,散在网关日志里
- 没有内存镜像。 它没有可 dump 的进程状态,”意图”在上下文的拼接顺序里
- 没有边界。 你甚至说不清这台机器”是哪台”
这就是 AI Agent 应急响应最反直觉的地方:它不是一个”主机被入侵”问题,而是一个”身份被冒用 + 授权过宽 + 行为不可追溯”的问题。
所以这份方案不是把传统 IR 流程改个名字。它得重新排顺序。
一、先分清三种事故,别把三种混成一种
我看过不少”AI 安全事件”,最大的问题是把三种完全不同的事故混在一起讨论,于是响应方案写得像三国演义——什么都提一句,什么都落不了地。
得分三层:
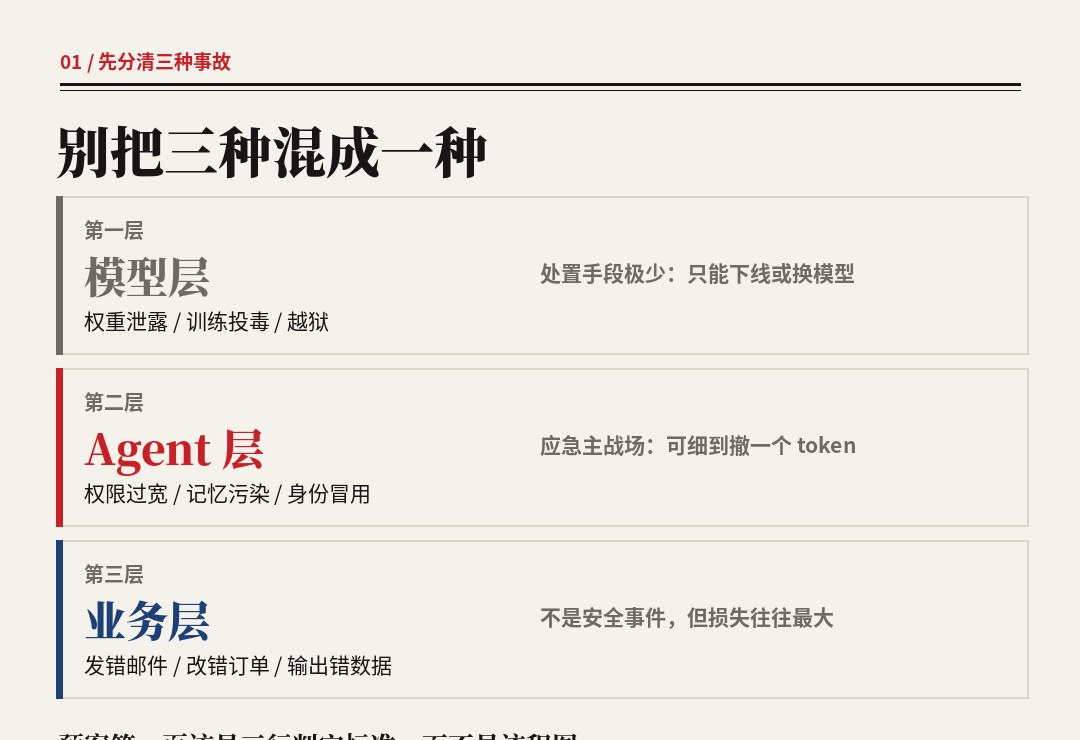
第一层,模型层。 模型本身被攻破——权重泄露、训练数据投毒、越狱绕过护栏。这层的特征是:你无法”处置”模型,你只能”下线服务”。 处置手段极少,基本只有换模型或加护栏。
第二层,Agent 层。 模型没问题,但挂载的东西出问题——工具权限过宽、记忆被污染、身份被冒用、上下文被注入。这层才是应急的主战场,因为它的处置粒度可以很细:撤一个 token、收一个工具权限、清一段记忆。
第三层,业务层。 技术上都正常,但 Agent 干了不该干的事——发错邮件、改错订单、把内部数据写进了客户可见的回复。这层严格说不是安全事件,是业务事故,但它的损失往往比前两层都大。
我见过最典型的误判:一个 Agent 把不该发的报价单发给了客户,安全团队按”数据泄露”拉了三小时应急,最后发现是 prompt 里少写了一句格式约束。
这三层的响应负责人、时间要求、处置手段全都不一样。 预案第一页就该是三行判定标准,而不是流程图。
二、分级不要用”AI”这个词当理由
OWASP 在 2025 年 12 月发了《Top 10 for Agentic Applications 2026》(ASI01–ASI10),是 100 多位专家共同评审的,目前最系统的 Agent 风险分类:
- ASI01 目标劫持 —— 外部内容改了 Agent 的主目标,它还在”正常”地跑
- ASI02 工具滥用 —— 每个工具都合规,组合起来不合规(查敏感记录 → 写文件 → 外发)
- ASI03 身份与权限滥用 —— 继承人类的高权限凭据,或借共享账号提权
- ASI04 Agent 供应链 —— MCP server、插件、prompt 模板、工具描述被篡改
- ASI05 意外代码执行 —— 生成的 shell/SQL/Python 在生产凭据下跑起来
- ASI06 记忆与上下文投毒 —— 长期记忆、RAG 库、共享上下文被污染,影响后续所有会话
- ASI07 不安全的 Agent 间通信 —— 多 Agent 之间没有认证、完整性、时效校验
- ASI08 级联失败 —— 一个小错在规划执行链里放大
- ASI09 人机信任滥用 —— 用户过度信任流畅自信的 Agent 输出
- ASI10 失控 Agent —— 凭据合法、行为像正常、目标已偏
这份清单解决的是”分类”。但它不解决”先做哪个”。
而在真实应急里,”先做哪个”才是要命的。
我倾向于用一个更粗但更好用的分级——基于“影响是否可信”和”是否还在继续”两个维度,四个档:
信息级 —— 有异常,但能解释。记录、确认基线、调检测规则。
升级级 —— 动作序列不对或权限请求异常,但没有确认的敏感影响。保全证据、找 owner 确认,考虑只收紧那一个工具或权限。 到这一步还需要人确认才能动更大的动作。
高级 —— 可能未授权访问、敏感数据外泄、或异常动作仍在继续。升级到应急负责人、限制受影响的身份或能力、评估关联系统。范围和影响判定必须立即由人做。
严重级 —— 确认的破坏性动作、大范围访问、可能扩散的实际损害。走预先批准的紧急处置路径,通知责任人。
这个分级的重点在最后一句话:如果证据不完整,就记录”已知”和”未知”,标出下一步验证动作,绝不把假设当成已确认的入侵。
三、六步流程:取证要排在关停前面
这是整篇最想传出去的一段。传统 IR 的顺序是”隔离—取证—恢复”,Agent IR 得改一下,原因是Agent 的日志往往是最容易消失的证据。
具体六步:
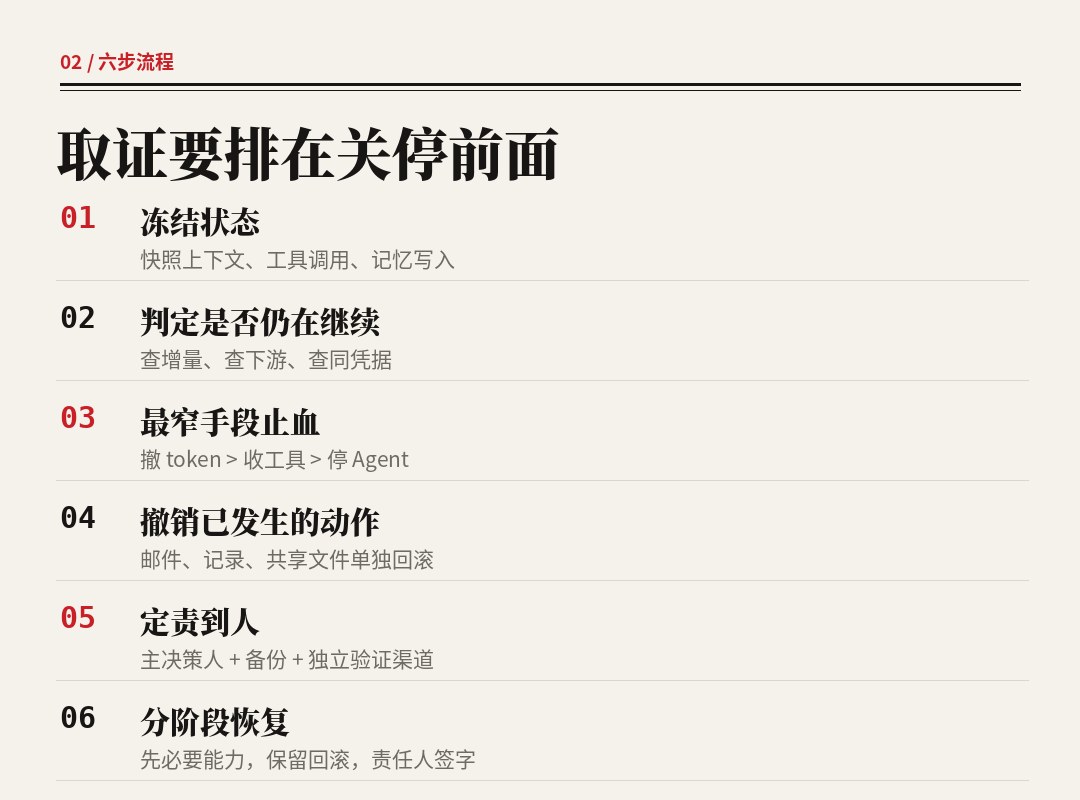
① 冻结状态,不是冻结服务
第一动作不是 kill。是把当前状态快照下来:完整的对话上下文(含被注入的那段外部内容)、所有工具调用记录(含参数)、记忆库的写入记录、身份凭据的最近使用记录。
理由很实在:Agent 的”现场”是上下文的拼接顺序。你一旦重启它、清掉会话,那段被注入的内容就永远找不回来了——而它是判断”这是注入还是模型幻觉”的唯一证据。
② 判定动作是否还在继续
这一步决定你后面能多从容。查三个东西:工具调用日志还有没有新增、下游系统有没有连锁反应、同一个凭据有没有在别处被使用。
如果还在继续,才进入紧急限制;如果已经停了,你有时间做完整取证。
③ 用最窄的控制手段止血
这是我认为最被低估的一条原则:优先窄控制,而不是整体关停。
- 能撤一个 token,就不要停整个 Agent
- 能收一个工具权限,就不要撤所有权限
- 能限制一个数据源,就不要断整个集成
但有个前提动作:动手之前,先查这个凭据还被谁用着。 一个共享的 service account 可能撑着好几条业务流,你一撤,无关业务全挂——然后你在应急群里被业务方追着问。
反过来也要说清楚:不确定性不能成为”不处置”的理由。 应急负责人可以记录这个权衡、选最窄的有效控制,同时并行让相关 owner 去梳理受影响流程。
④ 记住:停掉 Agent 不会撤销它已经做过的事
这一条我被踩过。Agent 被停掉之后,它已经发出的邮件还在对方邮箱里,已经改的记录还是错的,已经共享出去的文件还是共享状态。
这些都得单独排查、单独回滚。 停服务只是止住”继续发生”,不是”撤回已发生”。
⑤ 定责到人,包括”谁批准了这次紧急动作”
这一条是 Agent 应急和传统应急差别最大的地方。
传统应急里,”谁下的隔离指令”通常有现成流程。Agent 这里没有——因为Agent 本身可能就是这个动作的来源。
所以预案里必须写死:每个高风险动作,有一个主决策人 + 一个备份;有非工作时间的上报路径;有验证审批人身份的独立渠道。
特别要注意一种情况:如果 Agent 的 owner 或它的指令本身可能被攻破,就必须绕过常规 owner,走独立渠道验证。 否则你会看到”我授权你关掉我自己”这种荒谬场景。
⑥ 恢复要分阶段,且要人签字
恢复不等于把开关打开。顺序应该是:
确认范围(它访问了什么、改了什么、传了什么)→ 确认原因(凭据泄露?权限过宽?工作流不安全?输入异常?配置错误?)→ 消除暴露面(轮换凭据、收权限、修复数据)→ 受控验证(和 owner 一起测)→ 分阶段恢复(先只放开必要能力,保留回滚)→ 由责任人签字后才回正常。
四、一张能直接抄的判定表
预案里最值钱的不是流程图,是这种”看到什么→做什么”的表。我按上面的六步压了一版:
| 信号 | 先查什么 | 处置动作 | 谁拍板 |
|---|---|---|---|
| 出现了没人认领的 Agent 身份 | 资产清单里有没有这个身份 | 立即停用,追溯创建来源 | 安全 |
| 凭据在异常服务/上下文被使用 | 网关日志、下游调用记录 | 撤该凭据,查共用方 | 安全 + owner |
| 工具调用量突增 | 正常基线是多少、是否仍在增长 | 限流 + 快照上下文 | 安全 |
| 访问超出批准范围的数据源 | 该数据源的实际读取记录 | 收窄该数据源授权 | 数据 owner |
| 动作时间与正常使用时段不符 | 是否有排班/定时任务解释 | 记录,观察 24 小时 | owner |
| 出现”查敏感数据→写文件→外发”链 | 三者是否同一会话内发生 | 立即抬到高级,保全证据 | 应急负责人 |
| 记忆库出现异常写入 | 写入来源、影响哪些会话 | 隔离该记忆分区,准备回滚 | 安全 + owner |
| 输出内容与事实不符且很自信 | 是幻觉还是被投毒 | 别急着下线,先取上下文 | 业务 + owner |
这张表的好处是:它把”要不要拉应急”变成了可执行判断,而不是靠感觉。
五、90 分钟桌面演练脚本
方案写得再好,不演练等于没有。这是我认为性价比最高的一件事——不需要任何工具,一张桌子四个人就能跑。
角色:应急负责人(1)、安全响应(1)、Agent owner(1)、数据/系统 owner(1)。小团队可以一人多角,但每项关键职责不能没人认领。
剧本(可以直接用):客服 Agent 在凌晨 3 点调用导出接口 400 余次,目标是一个它本不该有权限的财务数据表。
时间轴:
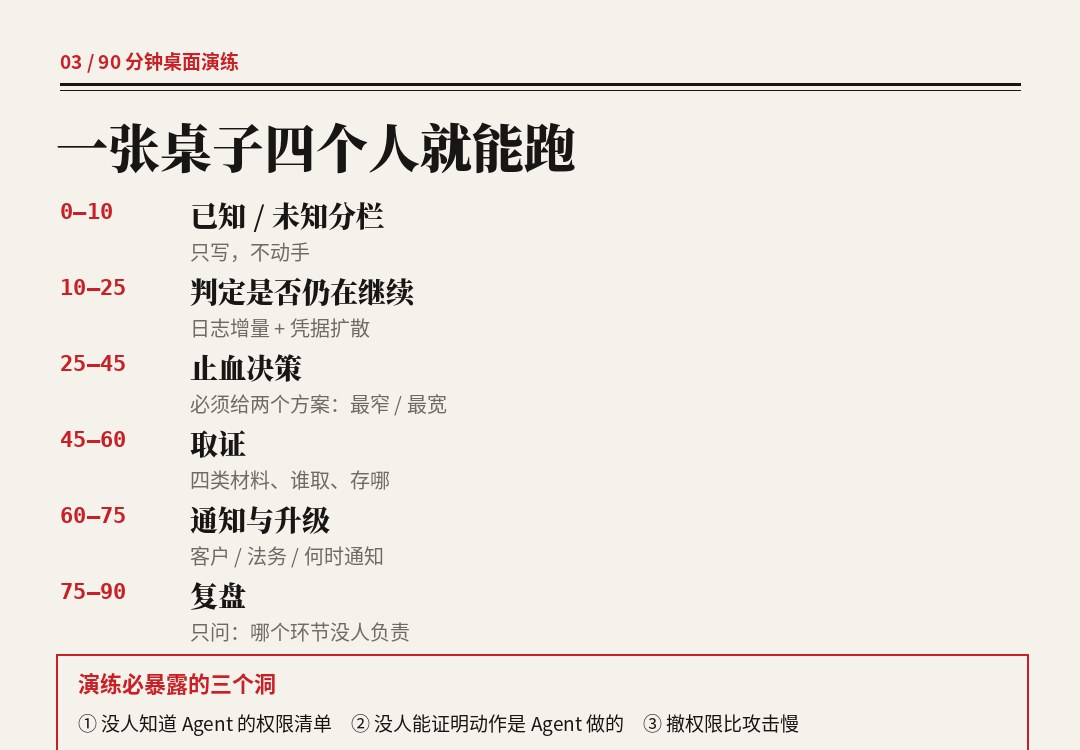
- 0–10 分钟:只做一件事——把已知和未知分开写。已知:调用次数、调用时间、调用接口。未知:调到了什么数据、是谁在调、是否还在继续。
- 10–25 分钟:判定是否仍在继续。查工具调用日志增量、查该凭据在其他服务的使用。
- 25–45 分钟:止血决策。要求给出至少两个方案:一个最窄(只撤这个导出权限),一个最宽(停整个 Agent)。讨论各自代价。
- 45–60 分钟:取证。列出要保全的四类材料,指名谁去取、存哪里。
- 60–75 分钟:通知与升级。谁通知客户、谁通知法务、什么情况下才通知。
- 75–90 分钟:复盘。只回答一个问题:这次演练暴露了哪个”没人负责”的环节。
演练最容易暴露的三个洞,我几乎每次都能看到:
第一,没有人知道这个 Agent 的权限清单。 一问”它能访问哪些系统”,全场沉默。这说明你缺的不是预案,是资产台账。
第二,没有人能证明”这个动作是 Agent 做的”。 日志里只有 service account,没有 Agent 标识、没有会话 ID、没有触发它的用户。这直接导致事后追责和定损都做不了。
第三,撤权限的审批链比攻击慢。 演练里”撤一个 token”要走三个人批,用了 40 分钟。真实攻击的时间窗口是秒级。
六、三个反直觉的判断
反直觉一:先怀疑”输入”,再怀疑”模型”。
绝大多数 Agent 异常的第一因,不是模型坏了,是它读到了不该读的东西。OWASP 把”目标劫持”排在 ASI01,理由就是:外部文档、邮件、网页里的恶意内容进了规划循环,Agent 会一边被劫持一边表现得完全正常。
所以第一条排查线永远是:这次会话里,有哪些内容是外部来的?
反直觉二:不要急着 kill,先想”kill 之后证据还在不在”。
这条和传统 IR 的直觉相反。传统主机被入侵,你隔离了,磁盘还在。Agent 你 kill 了,会话上下文可能就没了,而那段被注入的文本是唯一的判据。
反直觉三:最该被处置的,往往是”记忆”而不是”进程”。
记忆投毒(ASI06)的可怕之处在于它有延迟。今天被污染的一条记忆,可能三天后让另一个会话输出错误结论。你当时的所有日志都是”正常”的。
所以预案里必须有一条:记忆库要能按分区隔离、要能回滚、要能追溯写入来源。 做不到这三件事,你根本没法处置记忆投毒。
七、平时该建的四个基线
应急能力是平时攒出来的。这四个基线,缺一个预案就是纸。
基线一:Agent 台账。 每个 Agent 都要有:唯一身份、责任人、业务目的、批准的工具清单、批准的数据范围、正常活跃时段、正常动作量级。没有台账,你连”异常”都没法定义。
基线二:身份隔离。 Agent 不能借用人类会话,不能共用 service account。要独立身份,权限要时限化、最小化、可撤销。
基线三:可追溯的动作链。 每次动作要能回答三个问题:谁在动(Agent 身份)?它被授权做什么(策略判定)?事后能不能证明(审计链)? 这三个问题答不上来,你的日志就只是碎片。
基线四:能按分区处置。 工具权限能单独收、记忆库能单独隔离、凭据能单独撤。做不到细粒度,你只剩”全停”这一个选项——而”全停”在业务上通常批不下来。
最后
我不想把这篇写成”AI 安全很重要”的劝进文。
真正想说的是一句更朴素的话:Agent 应急最难的地方,不是技术,是”责任归属”这件事在 Agent 身上变得模糊了。
传统系统里,动作和人对得上——张三点了按钮,日志里有张三。Agent 这里,动作和人对不上:Agent 动了手,但它的目标、权限、判断依据,全都是人给的。
于是应急时最常出现的僵局是:安全团队说”先停”,业务方说”停了业务就断”,owner 说”我不知道它有这个权限”。
这份方案的全部价值,就是把这三句话在事故之前就问完。
预案真正的作用不是事故时照着念,而是逼你在平静的时候,把”谁负责”这件事写下来。
等出事那天再问,问不出来。

itadol5j
暂无介绍....
没有啦 (T▽T)
延伸阅读:
AI Agent 出事那天,你多半找不到「现场」:一份能照着跑的应急响应方案
Agent 出事那天,没有进程树、没有内存镜像、甚至说不清是哪台机器——传统应急的三大支柱在这里全部失效。一份可以照着跑...

552B 的模型,每次只叫 8B 起床:把 DeepSeek V4.1 Flash 的 MoE 讲成人话
552B 总参数、8B 激活,差 69 倍,两个数字却能同时成立——中间那个东西叫 MoE。用一家 384 个部门的公司...
李佳琦首卖Token,阿里92年副总裁站台:这场直播真正上链接的不是Token
李佳琦今晚首卖 Token,阿里最年轻副总裁陈宇森站台。但算完账你会发现:20 万亿 Token 折成钱是几千万级预算,...
我跑了一遍 AiSOC:6311 星的开源 AI 安全中心,最值钱的是它自己那份打脸报告
AiSOC 6311 星,MIT,Cyble 出资。但最值钱的是它自己那份 REPOSITORY_REALITY.md:...
8 种 JWT 攻击,其实只有 3 个根因:拆一款零后端的图形化利用工具
八项 JWT 攻击能力按「服务端在哪一步做错」归类只剩三层:不验签、信任 token 给的钥匙地址、用错钥匙类型。拆 J...