输入、输出、缓存命中:AI token 账单上的名词,看懂这一篇就够了
先说结果:这些名词里,真正会让你多花钱的只有两个——「缓存未命中」和「输出 token」。剩下的都是它们的注释。
我这两个月被账单教育了三次,都是同一个毛病:以为自己在省钱,其实在给同一个前缀反复付全价。这篇把我踩过的坑和查到的官方口径一次写清楚,看完你至少能回答一个问题——为什么我明明只发了一句话,账单上却有八千个输入 token。
一、token 是什么,为什么中文更贵
token 是模型处理文本的最小单位。它不是字,也不是词,是分词器切出来的一块。同一句话,不同模型、不同编码,切出来的块数可以不一样。
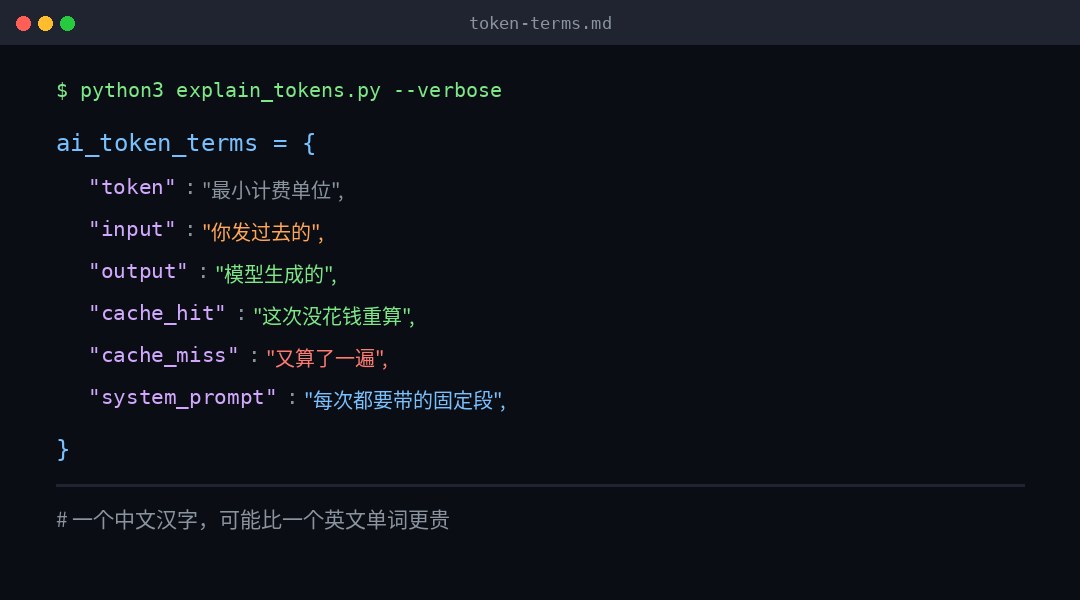
我拿 o200k_base 编码实测了几组,差别比想象的大:
| 文本 | 字符数 | token 数 | 字符/token |
|---|---|---|---|
| The quick brown fox jumps over the lazy dog. | 44 | 10 | 4.4 |
| 敏捷的棕色狐狸跳过了那只懒狗。 | 15 | 16 | 0.94 |
| 你好,世界 | 5 | 4 | 1.25 |
| CVE-2026-109618 | 15 | 8 | 1.88 |
看出问题了吗。同一句话,英文 10 个 token,中文 16 个。英文大约 4 个字符才 1 个 token,中文接近一个字 1 个 token。
这条对中文用户非常不友好:网上流传的「1 token ≈ 4 字符」是英文经验值,你拿它估中文,会低估一半以上。
还有一个反直觉的:CVE-2026-109618 这种编号,15 个字符烧 8 个 token。数字和连字符会被切得很碎。所以日志、哈希、ID 这类内容,比看起来贵得多。
二、一次请求的钱,花在四段上
我第一次看账单时最困惑的不是贵,是明明只问了一句话,输入却有八千多 token。后来才明白,输入不止你打的那句话。
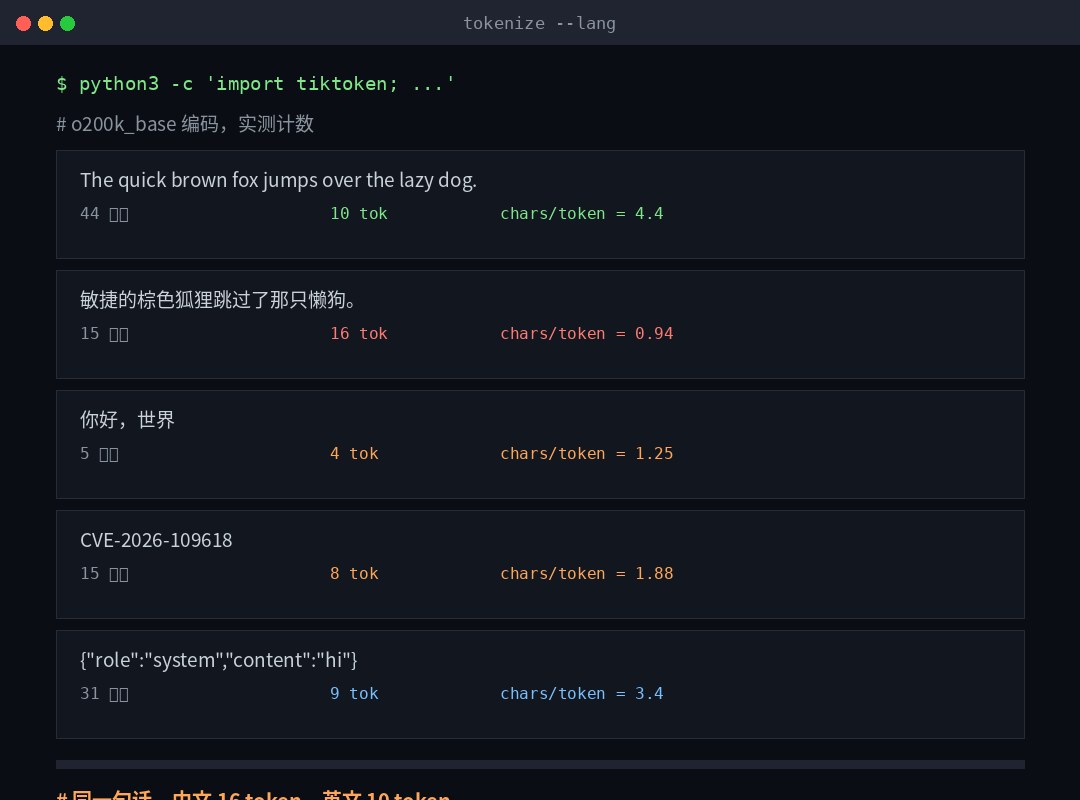
一次请求的输入,通常是四段拼起来的:
| 段 | 英文名 | 是什么 | 会不会变 |
|---|---|---|---|
| 系统提示词 | system / instructions | 你是谁的设定、规则、输出格式 | 基本不变 |
| 工具定义 | tools | 函数的 JSON Schema 和描述 | 很少变 |
| 对话历史 | messages / history | 之前每一轮的问答,全带上 | 只追加 |
| 本轮提问 | user | 你刚打的那句话 | 每次都变 |
我第一次被吓到的那次,就是工具定义那一坨占了 1,200 个 token。一个函数带参数描述,JSON Schema 展开来特别占地方。你写了 20 个工具,光定义就能吃掉两千。而且这部分你一个字都没打,但它每次都收费。
这里埋着一个后面要用的关键点:前三段都是「只追加、不修改」的结构,第四段每次都变。这个顺序不是巧合,它决定了缓存能不能命中。
三、输入、输出,还有那个藏在输出里的
这三者的关系,官方口径是这样的:
- 输入 token(input / prompt tokens):你发过去的一切,包含上面那四段。
- 输出 token(output / completion tokens):模型生成的。注意——不只是你看到的那段文字。
- 推理 token(reasoning tokens):推理模型在给出答案前,内部想的那些。你看不到,但它按输出价计费。
第三条是很多人账单翻倍的真正原因。我用推理模型跑一个分类任务,看到答案只有 20 个字,账单上输出却是 900 多。那 880 个看不见的 token,全是它在里面琢磨。
所以有个看起来矛盾的现象是正常的:答案越短,不一定越便宜。
输出价通常是输入价的 5 倍左右(各家的具体倍率见后面那张表)。这也解释了一个实操原则:能用输入解决的,别让它输出。把答案模板、格式示例放进系统提示词(便宜),别让它自己长篇大论地组织(贵)。
四、缓存命中与未命中:这是全文最该记住的一节
它们到底是什么
模型读输入的时候,会算一堆中间状态(叫 KV state)。这部分算力最贵。
提示词缓存(prompt caching)就是把某个前缀算出来的状态存下来,下次遇到一样的前缀,直接拿来用,不再重算。
于是就有了两个词:
- 缓存命中(cache hit):这次的前缀在缓存里找到了,这部分输入按折扣价收费。
- 缓存未命中(cache miss):没找到,老老实实按原价重算一遍。
命中的条件,比你想的严
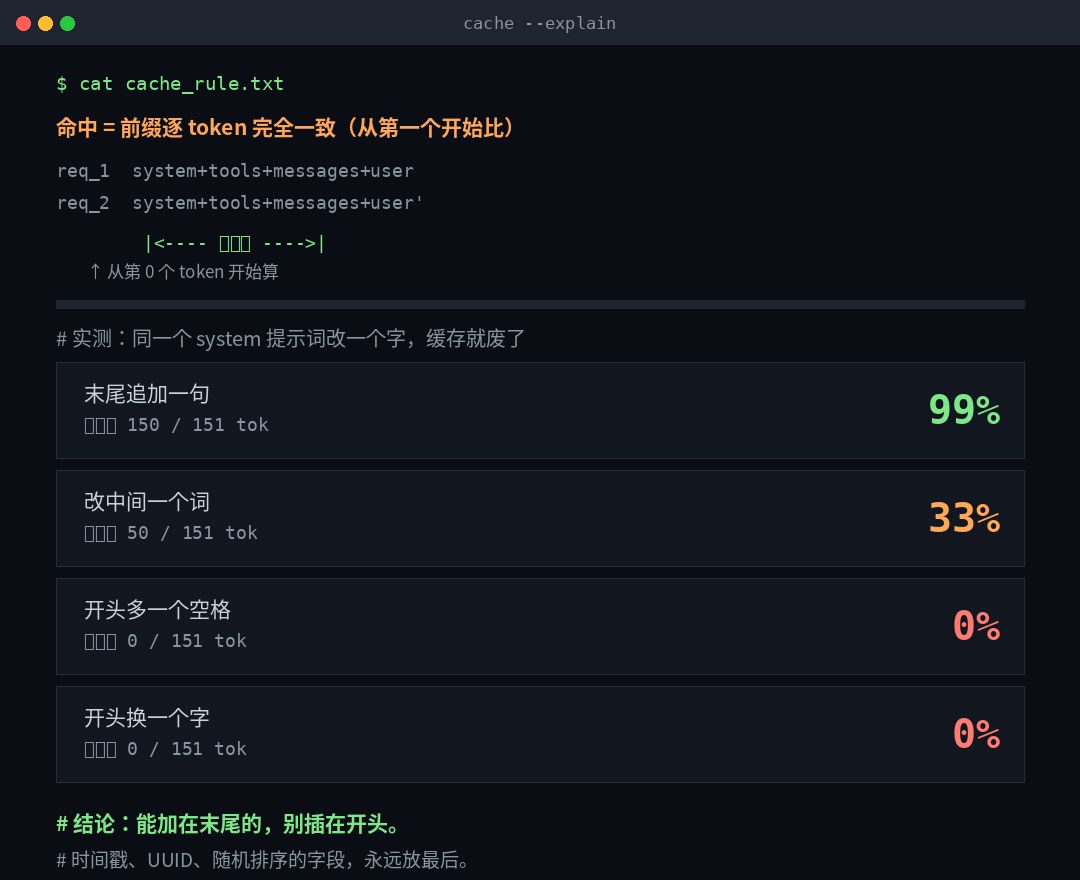
关键在「前缀」两个字。不是「问了差不多的问题」,是从第 0 个 token 开始逐字一致。
我做了个实验:拿一个 151 个 token 的中文系统提示词,改不同位置,看能复用多少。
| 改动方式 | 可复用前缀 | 比例 |
|---|---|---|
| 末尾追加一句话 | 150 / 151 | 99% |
| 中间改一个词 | 50 / 151 | 33% |
| 开头多一个空格 | 0 / 151 | 0% |
| 开头换一个字 | 0 / 151 | 0% |
看到那个「开头多一个空格」了吗。一个空格,缓存全废,按原价重算 151 个 token。
这不是 bug,是原理:缓存存的是从开头累积的状态,第一个 token 变了,后面全部失效。
所以有一条可以立刻用上的规则:恒定内容放最前面,会变的内容放最后面。
最常见的翻车写法是把当前时间、请求 ID、随机排序的字段塞在系统提示词开头。那等于每次都在新起一个缓存。这些字段要么挪到最末尾,要么干脆别放进去。
还有几个容易忽略的门槛
- 有最小长度。太短的前缀根本不给缓存。OpenAI 是 GPT-5.6 及以后 1,024 token 起;Anthropic 按模型分档,512 / 1,024 / 2,048 / 4,096 都有。不够长的话不报错,静默不缓存,你只能从返回的用量字段看出来。
- 有存活时间。OpenAI 默认 30 分钟(可到 12 小时);Anthropic 默认 5 分钟,可升到 1 小时。而且这个时间从请求开始算,不是从回答结束算——回答如果流了 4 分钟,5 分钟档只剩 1 分钟窗口。
- 并发时会互相等。缓存条目要等第一个请求开始返回之后才可用。同一秒发 10 个请求,这 10 个大概率都是未命中。
- 换了模型、换了工具、改了推理档位,前缀就变了,命中率归零。
命中率怎么看
别靠猜。两家都给用量字段:
OpenAI  : usage.prompt_tokens_details.cached_tokens
Anthropic: usage.cache_read_input_tokens / cache_creation_input_tokens
Anthropic 那个特别直观:两个都返回 0,说明压根没进缓存——通常是因为前缀没到最小长度。
五、价格结构:写要加钱,读才便宜
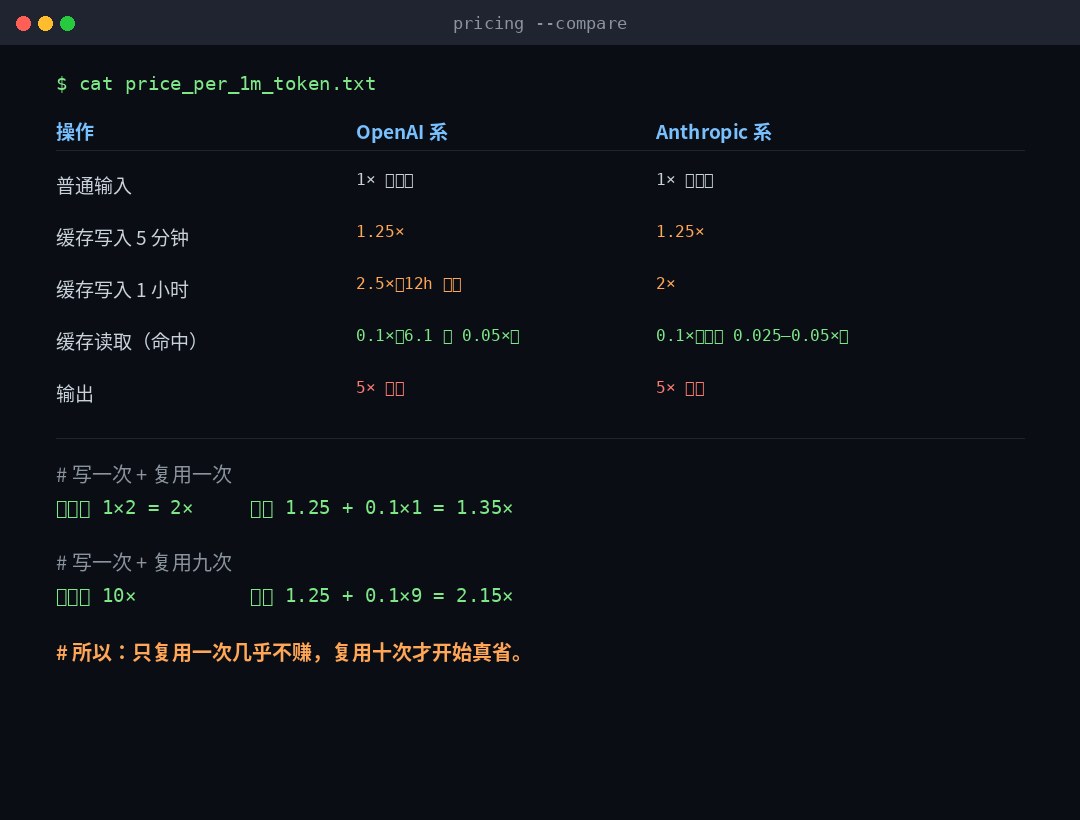
缓存不是免费的,这一点很多人漏掉。第一次写进缓存,要加价;之后读,才打折。
| 操作 | OpenAI | Anthropic |
|---|---|---|
| 普通输入 | 1×(基准) | 1×(基准) |
| 缓存写入 · 短期档 | 1.25×(30 分钟) | 1.25×(5 分钟) |
| 缓存写入 · 长期档 | 2.5×(12 小时) | 2×(1 小时) |
| 缓存读取(命中) | 0.1×(GPT-6.1 系 0.05×) | 0.1×(部分模型 0.025–0.05×) |
| 输出 | 约 5× | 约 5× |
拿最普通的 0.1× 读、1.25× 写算两笔账:
- 写一次 + 复用一次:缓存 1.25 + 0.1 = 1.35×;不缓存是 1 + 1 = 2×。省 32%。
- 写一次 + 复用九次:缓存 1.25 + 0.9 = 2.15×;不缓存是 10×。省 78%。
这条账的意思是:只用一次的话,缓存几乎不赚甚至略亏;复用十次以上,才是真的省。那些「一次性的临时对话」开缓存,纯属给自己找麻烦。
顺带一句:缓存的写入是按 token 段算的,不是按次。加断点本身不花钱,花的钱取决于你实际缓存了多长的内容。
六、提示词、系统提示词,到底怎么分
这两个词经常被混着用,但在计费和权限上是两回事。
| 名称 | 英文 | 谁写的 | 优先级 | 计费归属 |
|---|---|---|---|---|
| 系统提示词 | system prompt / instructions | 平台方或应用开发者 | 最高 | 输入 token |
| 开发者消息 | developer message | 应用开发者 | 次高(高于用户) | 输入 token |
| 用户提示词 | user prompt | 终端用户 | 低于上面两者 | 输入 token |
| 助手消息 | assistant message | 模型自己生成 | — | 输出 token |
两个容易踩的点:
- 「提示词」是个大词。它泛指你发给模型的所有文字指令,而「系统提示词」只是其中最靠前、优先级最高的那一段。说「提示词太长」时,往往真正的问题是系统提示词和工具定义太长。
- role 也是要花钱的。每条消息包一层
{"role":...,"content":...},这层结构本身也算 token。消息条数多的时候,光包装就能上千。
所以「清空对话重开」这个动作是有效的——不是玄学,是把历史那一段砍掉了。但反过来也要注意:清空之后,之前缓存的对话历史前缀也用不上了。
七、七个我踩过的坑,直接抄结论
- 拿「字符数 ÷ 4」估中文预算。错。中文接近 1 字 1 token,你这么估会少算一倍。要准就用
tiktoken实测,或者看返回的 usage。 - 以为「问过类似问题」就能命中。不能。必须从第一个 token 起完全一致。
- 在系统提示词开头插时间戳。这是最常见的缓存杀手。挪到末尾。
- 看到答案短就以为便宜。推理模型的思考过程按输出价收费,答案 20 字、计费 900 token 是常态。
- 给一次性对话开缓存。一次复用只省 32%,但多了一层复杂度和调试成本。至少三次复用才值得。
- 不看用量字段就猜命中率。两家的
cached_tokens/cache_read_input_tokens都是明码返回的。 - 并发发请求想靠缓存提速。缓存要等第一个响应开始才可用,同一秒发出去的请求基本都未命中。
八、照着做的一份清单
今天就能改的
- 把系统提示词和工具定义里所有会变的东西(时间、ID、用户信息、随机字段)挪到消息末尾。
- 工具按固定顺序排列。顺序变了前缀就变,白丢缓存。
- 先量一次:把系统提示词 + 工具定义的 token 数打出来。超过 2,000 就值得优化了。
值得花半天做的
- 把一个长系统提示词拆成「恒定段 + 易变段」,在恒定段末尾打缓存断点。
- 用真实流量跑一轮,记录
cached_tokens占总输入的比例。低于 30% 说明前缀设计有问题。 - 把输出侧也压一压:能要求「只输出 JSON」就别让它写解释,输出价是输入的五倍。
别做的
- 别为了缓存把提示词写得九曲十八弯。缓存省的是钱,不是清晰度。
- 别在一次性脚本里加缓存逻辑,多出来的复杂度比省下的钱贵。
- 别假设不同模型之间缓存能通用。换模型就是换缓存,命中率归零。
最后
这些名词拆到最后,其实只讲了一件事:模型按「它读进去多少」和「它写出来多少」收费,而缓存是唯一一个能把「读」打折的机制。
所以真正该优化的不是提示词写得多漂亮,是把那堆每次都不变的东西,放在每次都不变的位置上。
你省不下来的钱,多半不是模型太贵,是你的前缀每次都在变。
最后留个最实用的动作:下次看到账单异常,先别怀疑模型涨价,去看 cached_tokens 那一栏。它是不是 0,决定了你是在为算力付钱,还是在为重复付钱。

itadol5j
暂无介绍....
延伸阅读:
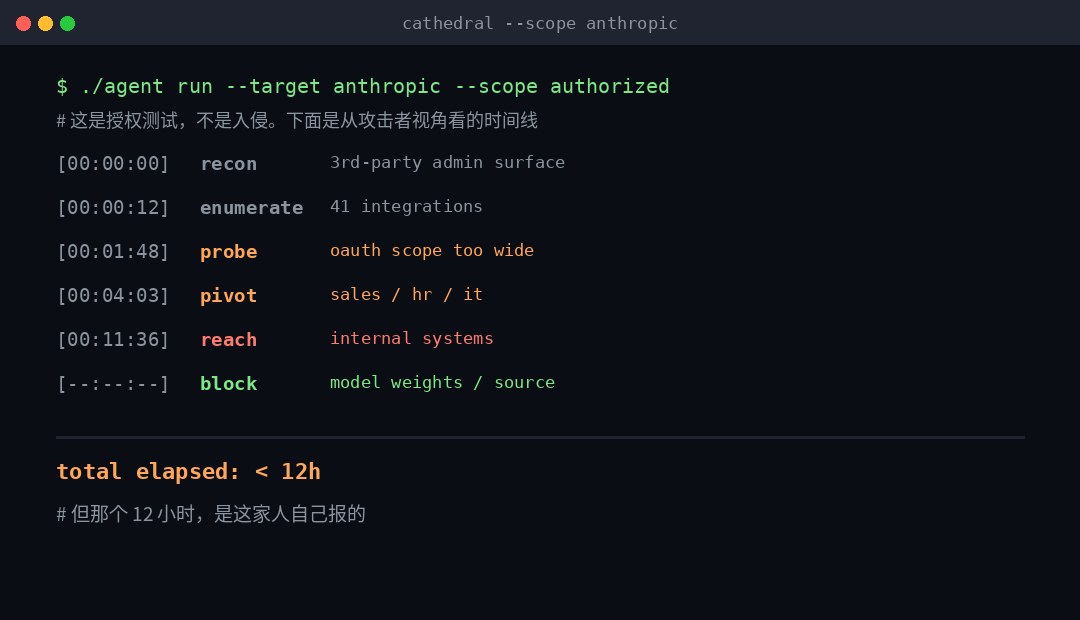
AI 攻破 Anthropic 只用了 12 小时:被攻破的不是模型,是它买的那圈办公软件
一次授权测试,AI 智能体不到 12 小时进入 Anthropic 内部业务系统——入口是第三方办公软件,不是模型。但「...

输入、输出、缓存命中:AI token 账单上的名词,看懂这一篇就够了
为什么只发一句话,账单上有八千输入 token?为什么答案 20 个字,计费 900 token?缓存命中到底在匹配什么...

AI 写脚本、挑目标、开价:Phantom 把勒索做成流水线,但每一步都要人点头
8,257 条会话消息、$23,920 的 API 账单、62 家点名受害组织、46 个定制加密器。这不是「全自动勒索」...
GPT-6.1 Terra 不是骨折价,是这家终于把中间那层补上了
$1 输入 / $5 输出,比 Sol 正好砍一半。但它不是最便宜的(往下还有便宜十倍的 Luna),也不是降价——是替...

微软把 AI Agent 划进内部威胁名单:这次动的不是模型,是权限归谁
微软 10 月 19 日的框架改了一个默认假设:Agent 不是自己人。核心只有一句话——把智能的供给和对智能的权威分开...